ARTICLE · 1218130
中山医院胸外科AI临床决策研究成果入选国家自然科学基金委2025年度资助成果巡礼
前言
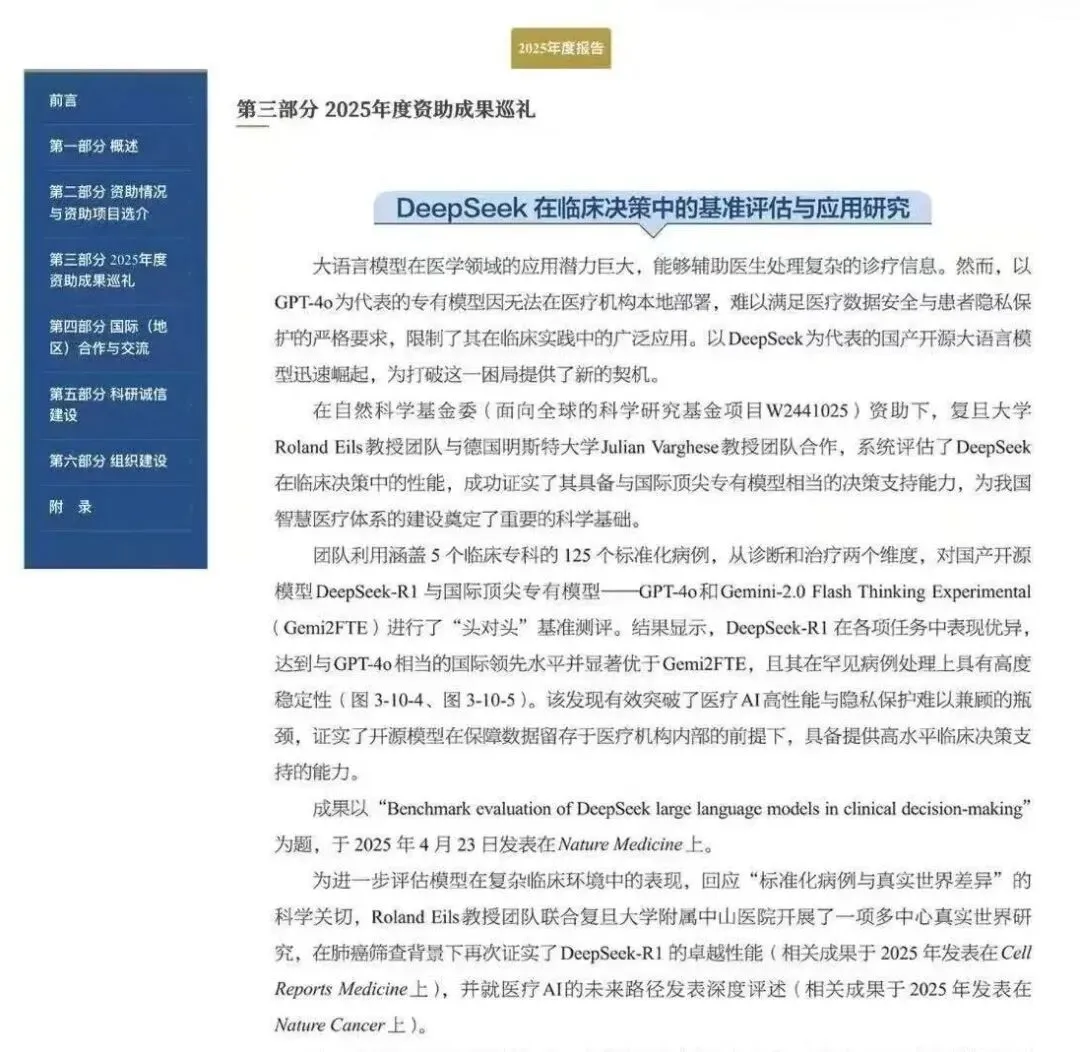
复旦大学附属中山医院胸外科谭黎杰教授团队与复旦大学智能医学研究院Roland Eils教授团队合作开展的肺癌筛查多中心研究,作为“DeepSeek在临床决策中的基准评估与应用研究”的系列成果,入选近期发布的《国家自然科学基金委员会2025年度报告》资助成果巡礼栏目。
筛查发现肺结节后,下一步该怎么办? 如何根据报告制定合理的后续管理方案,是临床工作中的常见问题。面对不同医院、不同格式的筛查报告,大语言模型能否给出准确、易读且稳定的建议?围绕这一问题,团队开展多中心研究,用真实世界临床报告检验AI的辅助决策能力。
此前,Roland Eils教授及合作团队在Nature Medicine发表研究,使用125个标准化病例,评估DeepSeek等大语言模型在诊断和治疗推荐任务中的表现。为进一步评估模型在复杂临床环境中的表现,回应“标准化病例与真实世界差异”的科学关切,谭黎杰教授团队联合Roland Eils教授团队开展了一项多中心真实世界研究。
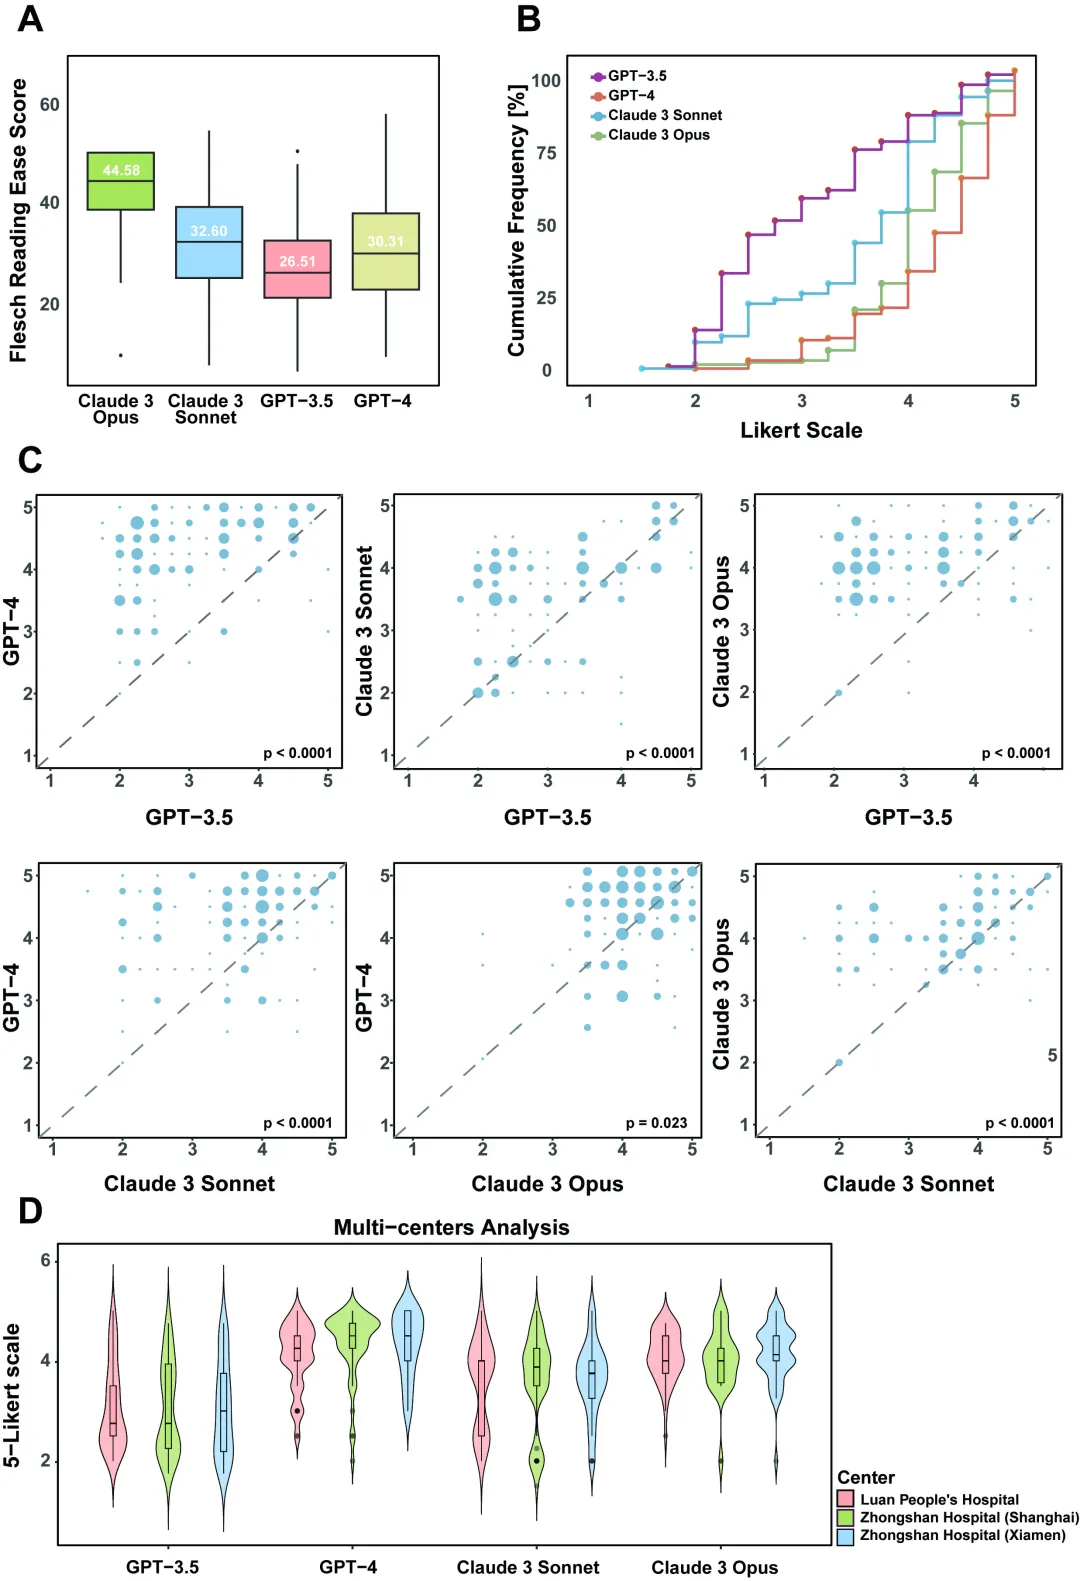
研究聚焦肺癌筛查场景,纳入复旦大学附属中山医院、复旦大学附属中山医院厦门医院和六安市人民医院的148份匿名化低剂量CT(LDCT)筛查报告,比较GPT-3.5、GPT-4、Claude 3 Sonnet和Claude 3 Opus生成的诊疗建议。团队关注的不只是建议是否准确,还包括内容是否易于理解,以及模型面对不同机构报告时能否保持稳定表现。
结果显示,不同模型在临床应用中各具所长:GPT-4在临床决策的准确性上表现最佳(中位评分4.5/5),展现了严谨的逻辑与决策能力;而Claude 3 Opus 则在回复的可读性上拔得头筹,其语言风格更易于被非专科医生理解。值得注意的是,模型在顶级三甲医院和基层医院的报告处理中表现基本一致,未发现显著的性能差异,证明了其在不同医疗环境下的稳定性与普适性。
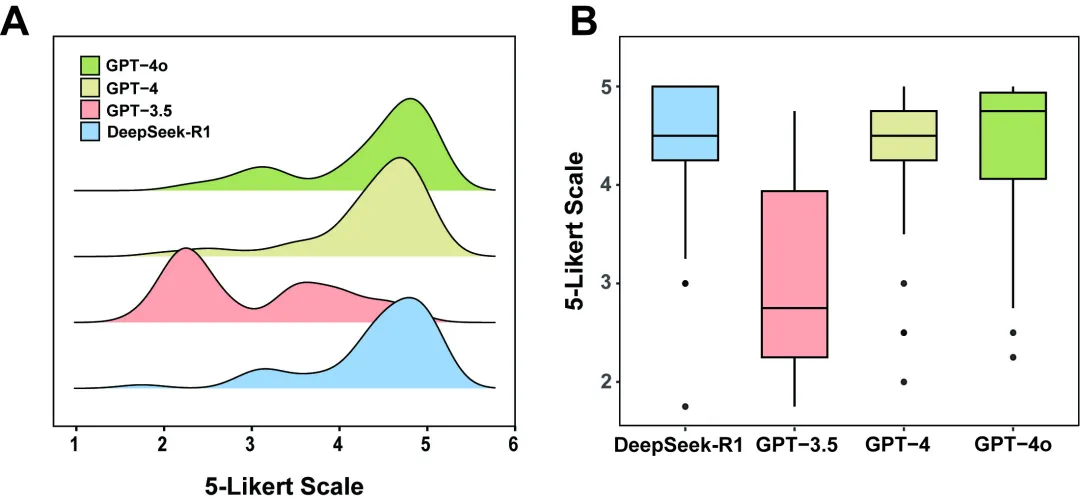
此外,探索性分析进一步证实,国产开源模型DeepSeek-R1、专有模型GPT-4o和GPT-4的总体表现相近,均显著优于GPT-3.5;但DeepSeek-R1和GPT-4在生成“满分回答”的比例上呈现出高于GPT-4和GPT-3.5的趋势。这意味着在数据隐私敏感和成本受限的医疗场景中,高性能开源模型将具有巨大的应用前景。
从标准化病例评估到肺癌筛查场景验证,此次入选的科研成果呈现了团队将AI研究与临床需求相结合的探索。围绕肺结节诊疗中的实际问题,为AI辅助临床决策积累研究证据。
相关论文以“Multi-center benchmarking of large language models for clinical decision support in lung cancer screening”为题,于2025年11月21日在线发表于Cell Reports Medicine。同期围绕该研究成果,团队受邀接受“Cell Press对话科学家”栏目专访,专访内容2025年12月18日在“CellPress全科学”官方微信公众号以当日头条形式发布。
复旦大学附属中山医院胸外科段智允博士、黄旭住院医师为论文共同第一作者;谭黎杰主任、Roland Eils教授为共同通讯作者。