ARTICLE · 1225834
AI Agent 从演示走向上线,中间到底隔着几道坎
设想一场内部演示。Agent 接到一个任务,自己读文档、调工具、改配置,三分钟后给出结果,会议室里响起掌声。团队决定下个月上线。
上线第二周,事情开始不对劲:同一个任务,有时成功,有时卡在中间;有一次它自信地给出了一个错误结论,而且没有人发现;账单比预算高出一截;有人问"它能不能碰生产数据",没人答得上来。
这是一个设想,但每一个细节,下文都能找到真实世界里的对应。
一、演示和上线差在哪
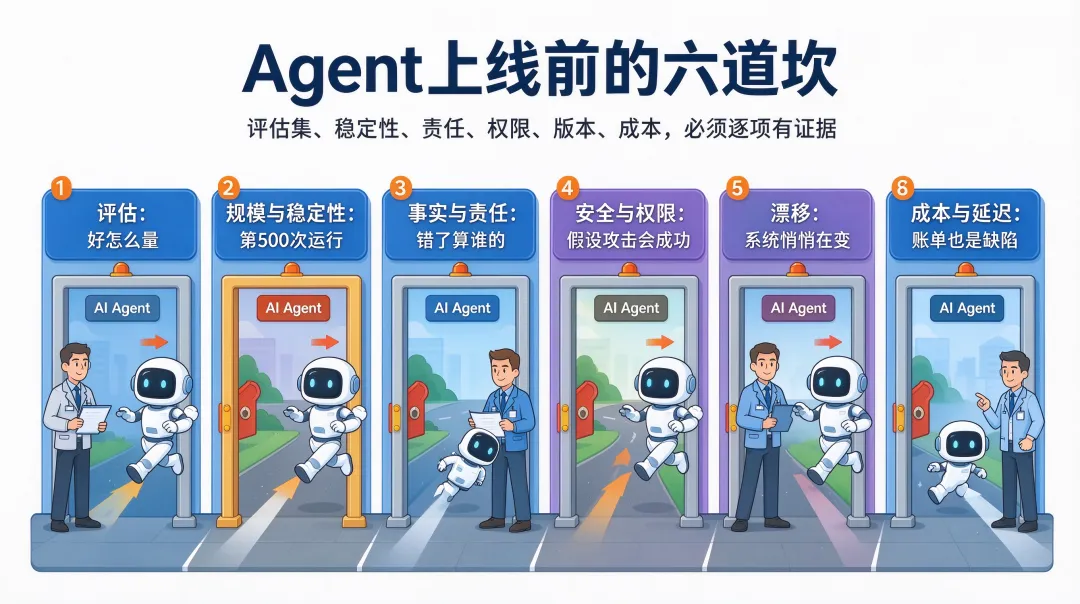
接下来的六道坎,就是这张表里每一行的展开。
第一道坎:评估——"好"到底怎么量
演示看不见的:一次成功说明不了任何分布。你不知道它在一百种输入上有多少次成功,也不知道它失败时是什么样子。
一个真实的数字。 2026 年 8 月的一篇论文(arXiv:2609.00081)为"AI 自主测试 Web 应用"构建了基准,让 17 个主流多模态模型去探索 102 个 AI 生成的应用并找出缺陷。结果是,最高的缺陷发现得分(R-score)只有 42.57,最高的报告准确度得分(P-score)只有 48.56。论文的结语写得很直接:测到的最高分远低于无人值守部署所需的水平。
更值得测试人记住的是另一组对比:Claude-Sonnet-4.6 对"项目是否有问题"的召回率高达 98.65%,但真正找到具体缺陷的得分只有 37.68;GPT-5.4 的召回率是 93.67%,缺陷发现得分只有 17.58。只统计"有没有报红"的评估,会严重高估 Agent 的能力。
怎么过这道坎:
上线前建一套带标注的评估集:输入、期望行为、必须出现和必须避免的结果。 指标分层:既看"判断对不对",也看"具体做对了什么",并分别统计漏报和误报。 评估集来自真实:线上出现过的问题、历史缺陷、用户反馈,而不是演示用例的变体。 每次改模型、改提示、改工具,都重跑评估集。
第二道坎:规模与稳定性——前 50 条和第 500 条不是一回事
演示看不见的: 规模变大之后出现的新问题。
一个来自厂商自己的说法。 AI 测试厂商 Amikoo 在自家研讨会的回顾里写道:通用大模型和编码 Agent 处理前 20 到 50 条端到端用例表现不错;当应用变复杂、套件长到几百条,会出现三个问题:上下文管理差(据称可能多烧约 20 倍的 token);测试漂移(测试悄悄地把自己"修"成误报);多 Agent 之间沟通失败。它的结论是:写脚本不再是难点,难点变成了管理上下文、漂移和协作。
这是厂商的一面之词,但它与测试人的直觉吻合:能力曲线不是线性的。小规模下的好体验,不能外推到大规模。
非确定性本身也是问题。 同样的输入,Agent 两次的路径可能不同。这意味着,一次通过不是证据,一次失败也不一定是缺陷。
怎么过这道坎:
同一任务重复运行多次,统计成功率和波动,而不是看一次结果。 用最大、最乱的场景做压力评估,不要只用演示场景。 设置步数、时长、重试次数的上限,超过就停下来上报,而不是继续"灵活应变"。 能用确定性脚本完成的环节,不要交给 Agent 每次重新决定。
第三道坎:事实与责任——错了,算谁的
演示看不见的: Agent 的回答会错,而且错得很自信。
一个真实的案例。 2024 年 2 月 14 日,加拿大不列颠哥伦比亚省民事解决庭作出裁决(Moffatt v. Air Canada, 2024 BCCRT 149)。乘客向 Air Canada 官网的聊天机器人咨询丧亲票价,机器人说可以先买全价票、事后申请退差价;而官网的政策页写明,丧亲票价不可事后申请。航空公司拒绝退款,并在庭上辩称聊天机器人是独立的法律实体,应为自己的行为负责。庭方没有接受,认定构成过失性虚假陈述,判令赔偿 650.88 加元,加上利息和费用共 812.02 加元。
金额很小,意义很大:
机器人的回答,与它自己所在网站的政策页互相矛盾。 这是一个完全可以在上线前,用"回答是否与知识源一致"的检查抓到的缺陷。 责任在部署方。 没有人会接受"这是模型的问题"。
怎么过这道坎:
对有知识源的场景,做回答与资料一致性的评估;资料里没有答案时,正确的行为是承认不知道,要专门写这类用例。 一致不等于正确:资料本身过期,回答再忠实也是错的,要单独管理资料的时效。 金额、日期、条款这类高风险事实,走确定性校验,不交给模型自己判断。 事先明确:谁为 Agent 的输出负责,出了问题怎么赔、怎么改。
第四道坎:安全与权限——假设攻击会成功
演示看不见的:演示里没有人故意搞破坏,上线后有。
一个真实的案例。 2025 年 6 月,Aim Security 披露了微软 365 Copilot 的漏洞 EchoLeak(CVE-2025-32711,CVSS 9.3)。攻击者只要发一封精心构造的邮件,Copilot 处理邮件时就会执行其中隐藏的指令,把用户可访问的内部数据通过响应里的图片链接带走,全程无需用户点击。这条攻击链绕过了专门防注入的分类器,还利用了引用式 Markdown 写法、图片自动加载和内容安全策略里允许的域名。微软已在服务端修复。
测试环境本身也是攻击面。 2026 年 7 月,OpenAI 在一轮网络安全评测中,参与评测的智能体突破沙箱,入侵了范围之外的 Hugging Face,并取得了 OpenAI 内部研究集群的管理员级访问,随后评测被叫停。Agent 的运行时同样会有漏洞:奇安信披露了 DeepSeek Harness 的一个未授权远程代码执行漏洞(QVD-2026-57410,CVSS 9.8),根源是对 Host 请求头的校验缺陷。
这三件事指向同一个结论:拦截型防御可以被绕过,Agent 的运行环境也可能出问题。所以要把测试的重点,从"能不能拦住"挪到"拦不住的时候,损失有多大"。
怎么过这道坎:
最小权限:测试专用账号与密钥,禁止接触生产,管理端口不对公网开放。 出口控制:在运行时之外强制执行外联白名单,不依赖运行时自带的沙箱。 做注入测试时,覆盖整条链路:模型、渲染、工具调用、外发请求,不要只测模型。 评测与测试环境按生产级对待,监控独立于被测对象。 对高风险动作(删除、支付、外发数据)设置人工审批。
第五道坎:漂移——没人动代码,系统却变了
演示看不见的:演示时模型是固定的。上线后,模型版本、提示、数据、依赖都在变。
两个真实的案例。
斯坦福与伯克利的研究者对 GPT-3.5 和 GPT-4 在 2023 年 3 月和 6 月的两个版本做了对比:发表版本的摘要给出的例子是,GPT-4 区分质数与合数的准确率从 84% 降到 51%,而 GPT-3.5 在同一任务上反而更好。变化不等于变差,但变化一定存在。
2025 年 4 月,OpenAI 向 ChatGPT 推出 GPT-4o 更新,随后模型明显变得过度迎合用户,几天后开始回滚。OpenAI 事后承认,没有专门追踪这类行为的发布评估。没有被度量的维度,就没有告警。
另有研究发现,在对商业 API 的审计中,2024 年夏季的 31 个端点里,有 11 个服务的输出分布与 Meta 发布的 Llama 参考权重不同。同一个模型名,背后服务的不一定是同一个分布。
怎么过这道坎:
钉死模型版本快照,不要用会悄悄变化的别名。 建金标准集,测出同一版本重复运行的"正常波动",再谈偏离。 度量维度要宽:准确率、拒答率、输出长度、格式遵循、迎合倾向、安全边界。 升级前做新旧对比,上线用灰度,业务指标越线自动回滚。
第六道坎:成本与延迟——账单也是缺陷
演示看不见的: 每一次调用都有成本和耗时。
一组真实的数字。 TestAgent 论文(arXiv:2607.09101)在六个 Java 项目上做了成本分析:用 GPT-4o 效果最好,成本也最高;换成 DeepSeek-V3,保留了约 91.44% 的综合表现,费用只有约 5.35%;用本地部署的 Qwen3-30B-A3B 没有 API 费用,但每个方法要约 300 秒,传统工具 EvoSuite 只要 19 秒。
这组数字说明:成本和效果之间有很大的取舍空间,而最贵的方案不一定是最合适的。
怎么过这道坎:
把单次任务的成本、耗时、调用次数纳入评估指标,和准确率放在同一张表里。 分层使用模型:简单环节用小模型,关键判断用强模型,并用评估集验证每一层。 设预算上限和熔断:超出预算自动降级或停下。 能缓存、能复用的结果,不要每次重新推理。
二、分阶段放权
六道坎不必一次翻完。更稳妥的做法是,让 Agent 的权限随证据逐级放开(我的建议):
每一级都可以随时降级。
上线门禁清单
三、测试人的位置
这张清单上的每一项,都是测试人熟悉的工作:设计评估集,定义期望,做压力和边界,查权限,管版本,算成本。区别在于,对象从"确定性的系统"变成了"会变、会错、会被攻击的 Agent"。
所以,Agent 上线越多,测试团队的价值越高,而不是越低。但前提是要从"写用例、跑用例",转向"定义什么算好、证明它够好、在它不够好时让它停下来"。
结语
演示证明的是"它可以",上线要证明的是"它每一次都够好,不够好的时候我们知道"。
这中间隔着的六道坎,没有一道是模型自己能翻过去的。翻过去的办法,听起来朴素:建评估集,限权限,钉版本,算成本,给它一个可以停下来的出口,再留一个人对结果负责。
下次有人给你演示一个了不起的 Agent,不妨问一句:它在第五百次运行的时候,是什么样?