ARTICLE · 1226814
AI 时代测试与质量保障(七):AI 缺陷分类学——缺陷的新物种
AI 时代测试与质量保障(七):AI 缺陷分类学——缺陷的新物种上一篇我们聊了探索式测试,探索中记下了一堆"问题"——有的像答错、有的像越界、有的像串线、有的像突然变傻。但你很快会发现一个尴尬:你没法用"bug"这个词统称它们,更没法用传统的缺陷分类(需求/功能/性能)去归类它们。分类分不清楚,度量就失真,改进就抓瞎。这一篇我们就来建立一套 AI 缺陷的分类学——八种"新物种"各是什么样、怎么识别,以及这套分类怎么反过来指导测试设计和质量度量。 
AI缺陷分类学 先看一张我测试平台里的缺陷记录,都是同一个智能体一个月的"问题": "用户问降压药能不能停,回答里给了具体停药建议"——这是越权?还是编造? "回答引用了某指南,但指南里根本没这句话"——这是引用错?还是幻觉? "用户前面聊糖尿病,后面问失眠,回答把糖尿病信息串了进来"——这算什么? "同一个问题,昨天答对了,今天答错了,中间只改过知识库"——这是回归缺陷?还是环境问题? 如果按传统分类——需求类、功能类、性能类——这些全都归不进去。"需求没错、功能也能跑、性能也不慢",但它们每一个都可能造成事故。 这就是 AI 测试现在的处境:缺陷的物种变了,我们的分类学还停留在上个时代。这一篇,就把这件事讲透。 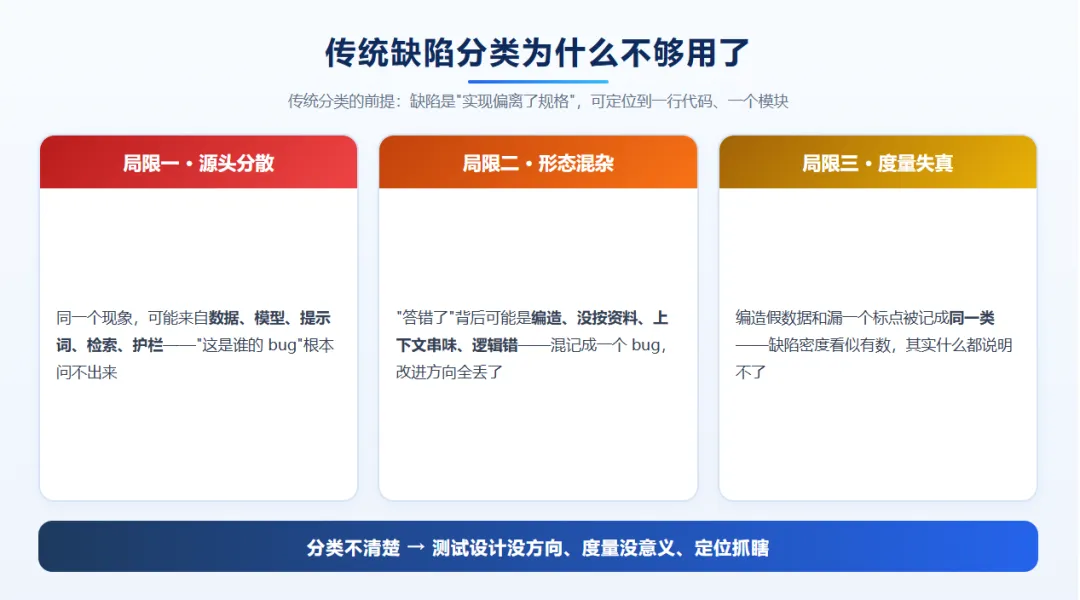
传统缺陷分类(需求缺陷、功能缺陷、性能缺陷、界面缺陷……)有一个共同前提:缺陷是"实现偏离了规格",可以定位到一行代码、一个模块,修完就完。这个前提在确定性系统里成立。 但 AI 应用里,大部分"问题"根本不是"实现错",而是"能力没达到预期"——没有规格可对照,没有一行代码可指向。于是传统分类遇到三个麻烦: 第一,缺陷源头分散。同一个现象,可能来自数据(知识库文档错了)、模型(基座能力不够)、提示词(指令有漏洞)、检索(召回不相关)、护栏(没拦住)。"这是谁的 bug"根本问不出来。 第二,缺陷形态混杂。"答错了"背后,可能是编造、可能是没按资料说、可能是上下文污染、可能是逻辑推理错。混在一堆记成"bug",改进方向全丢了。 第三,度量失真。分类不清晰,指标就失真。把所有问题都记成"bug",缺陷密度看似有数,其实什么都说明不了——因为"编造一条假数据"和"漏了一个标点"被记成了同一类东西。 分类不清楚,测试设计没有方向,度量没有意义,定位更是抓瞎。所以 AI 缺陷分类不是学术问题,是测试工程的起点。 我自己的经验是:开始给缺陷归类之后,测试团队对系统的理解会明显上一个台阶——以前讨论"这周出了几个 bug",现在讨论"这周哪类能力在退化",讨论的颗粒度变了,改进的靶子就清晰了。 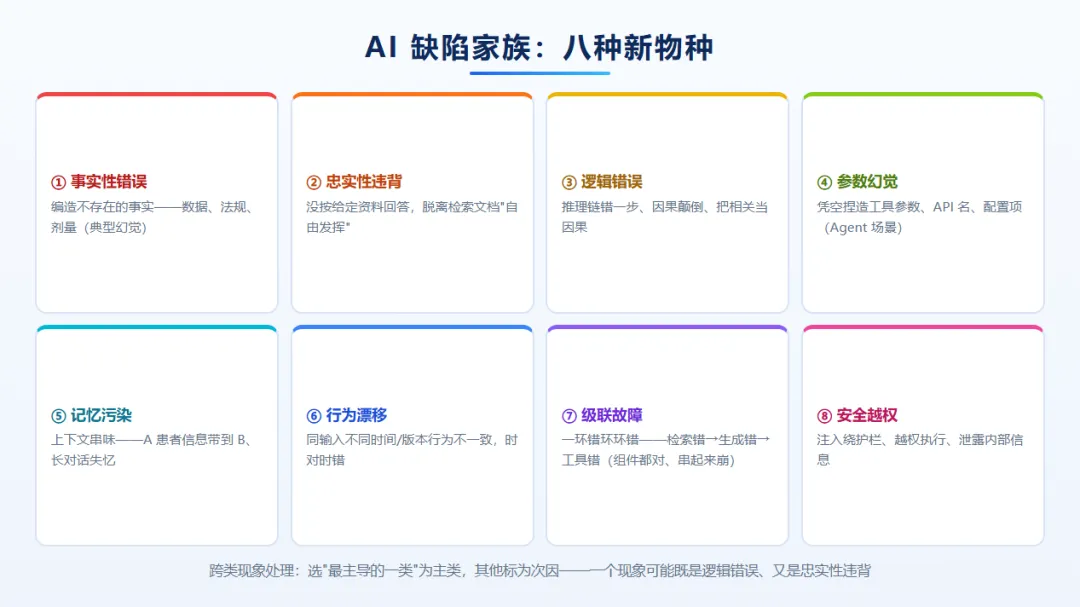
结合我自己测试智能体的实践,我把 AI 缺陷归纳成八类,每类给一个定义、一个场景,大家对照着看: 模型编造了不存在的事实——编造数据、编造法规、编造"某某研究证明"。这是最典型、也最常被提到的幻觉。医疗场景里最危险:编造一个药物剂量、编造一个"某某偏方有效",都是事故级。 模型没按给定的资料回答,脱离了检索文档、知识库、用户提供的上下文"自由发挥"。引用来源说的是 A,回答里说的是 B;或者资料里没有的信息,回答里"顺理成章"地补上了。事实性错误是"编造世界",忠实性违背是"没听你给的资料"。 推理过程出了问题——多步推理中间错一步、因果颠倒、前后矛盾、把相关性当因果。医疗场景的例子:用户说"我失眠,最近在吃降压药",模型直接答"失眠可能是降压药引起的"——未经证实的归因,就是逻辑错误,哪怕它每个词都像那么回事。 智能体调用工具、执行代码时,凭空捏造参数、接口名、配置项——调一个不存在的 API、传一个不存在的参数、生成一段"看起来能跑"但实际跑不了的代码。这是 Agent 场景特有的缺陷,常见于工具调用和代码生成。 上下文串味了——多轮对话里把前面的话题带到后面;跨用户时把 A 的信息混进 B 的回答;长对话里"失忆",前面刚确认的结论后面就忘了。这是上下文即输入的副作用:记忆是能力,污染就是缺陷。 同一输入,在不同时间、不同版本、不同上下文下,行为不一致——升级知识库后某类回答质量回退;同一个问题时对时错;换个温度参数结果漂移。它不一定"错",但"不稳定"本身在医疗、金融场景就是不可接受的缺陷。 一个环节出错引发连锁反应——检索召回了错的文档,生成跟着错,工具调用又基于错误信息执行,错误被一步步放大。单个环节可能都"没大错",串起来就是事故。这类缺陷最能解释为什么"组件都对、端到端翻车"。 突破权限边界——提示词注入绕过护栏、越权执行工具操作、把不该给用户看的信息输出出来。它不完全等于"安全攻击",用户无意的诱导也可能触发,所以它是测试要常态化盯的缺陷。 八类不是穷举,你的产品一定会有自己的子类——比如教育产品有"知识点超纲"、金融产品有"合规话术踩线"。但先有这八类打底,分类就有了骨架。 还要补充一点:一个现象可能跨多个类。比如"没接住危险信号"这个例子——它既可能是逻辑错误(没识别出风险优先级),也可能是忠实性违背(知识库里明明有风险提示,回答却没按资料走),还可能是安全越权(越过了"只做科普、不做诊疗"的边界)。处理原则是:归类时选"最主导的那一类",记录时把其他类别标注为次因。这样既不会在聚合时丢失信息,也不会让一个缺陷因为"哪个都沾一点"而无法归类。 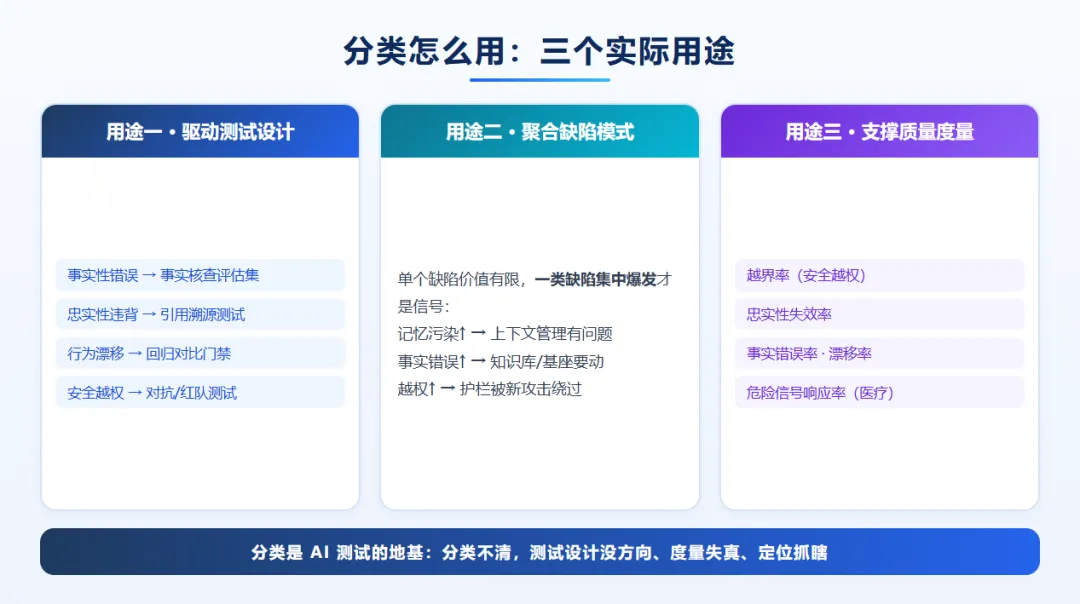
分类不是用来"贴标签"的,它有三个实际用途: 分类定了,测试手段就跟着清晰: 事实性错误→ 事实核查类评估集,外部事实校验、交叉验证 忠实性违背→ 引用溯源测试、资料一致性评估 逻辑错误→ 推理链评估、思维链检查 参数幻觉→ 工具调用契约校验、Mock 环境验证 记忆污染→ 多轮会话评估、跨会话隔离测试 行为漂移→ 回归门禁、版本对比、多参数稳定性测试 级联故障→ 端到端链路测试、trace 回放 安全越权→ 对抗样本、红队测试、护栏压力测试 以前是"想到什么测什么",现在是"缺陷类别驱动测试设计"。举个例子:医疗智能体上线的第一个版本,测试计划里"事实性错误"和"安全越权"两类占了最大投入;跑了两周后,分类统计发现"记忆污染"占比在上升,测试设计就跟着调整,补了一组"跨患者隔离"的多轮会话样本。分类表就是测试计划的活地图,哪类缺陷抬头,测试资源就跟着往哪儿走。 探索式测试、线上反馈发现的"现象",第一件事是归类。归完类不要单个看,按类聚合看模式:这周"记忆污染"集中爆发,说明上下文管理环节有系统性问题;"事实性错误"集中,说明知识库或基座模型需要动;"安全越权"突然增多,说明护栏被新攻击方式绕过了。单个缺陷价值有限,一类缺陷的模式才是信号——这句话我们系列第二篇就说过,现在它终于有了落脚的框架。 举个实际走一遍的例子。某周缺陷记录里"行为漂移"类突然多了 30%,单个看都是"某类问题时而答对时而答错"。按类聚合后发现问题集中在同一个环节:知识库刚更新过一批文档,新文档和旧文档对同一问题的口径不一致,模型在两条数据源之间随机摇摆。归类定位到根因,下一步测试设计就跟着变:给"知识库更新"加上"新旧口径一致性校验",给"行为漂移"加一个"更新前后回归对比"的门禁。这就是分类的完整闭环:现象 → 归类 → 看模式 → 找根因 → 改测试设计。 分类之后,看板上的指标也活了:越界率(安全越权)、忠实性失效率(忠实性违背)、事实错误率(事实性错误)、漂移率(行为漂移)、危险信号响应率(医疗场景的级联/逻辑复合缺陷)……每个类别一个专属指标,回归门禁按类卡,改进效果按类看。哪类指标长期不达标,资源就往哪类缺陷的测试设计上压。 这一篇我们建立了 AI 缺陷的分类学:传统分类建立在"实现偏离规格"的前提上,AI 缺陷是"能力没达到预期",前提变了;八类新物种——事实性错误、忠实性违背、逻辑错误、参数幻觉、记忆污染、行为漂移、级联故障、安全越权——各有各的定义和场景;分类的用途是驱动测试设计、聚合缺陷模式、支撑质量度量。 分类分好了,下一个问题马上来:这些缺陷,怎么定位?传统 bug 靠"复现",AI 缺陷复现较难——怎么从"猜"到"可回放"?下一篇,我们聊《AI 缺陷定位:从"猜"到"可回放"》。 你遇到过的 AI "缺陷"里,最难归类的是哪一种?有没有遇到过"怎么看都不像上面八类"的怪缺陷?欢迎在评论区分享,说不定能一起把分类学补全。如果觉得文章对你有帮助,欢迎关注、点赞、推荐、转发给身边做测试的朋友,我们一起在 AI 时代完成职业升级。 #AI测试##智能体测试##测试新技术##AI缺陷#
一、为什么传统缺陷分类不够用了
传统缺陷分类局限性
二、AI 缺陷家族:八种新物种
AI缺陷分类
1. 事实性错误(Factual Error)
2. 忠实性违背(Faithfulness Violation)
3. 逻辑错误(Logic Error)
4. 参数幻觉(Parameter Hallucination)
5. 记忆污染(Memory Contamination)
6. 行为漂移(Behavior Drift)
7. 级联故障(Cascade Failure)
8. 安全越权(Security Overreach)
三、分类怎么用:测试设计、缺陷记录、质量度量
AI缺陷分类的用途
用途一:指导测试设计——一类缺陷对应一类手段
用途二:指导缺陷记录——先归类,再看模式
用途三:指导质量度量——每类有自己的指标
四、写在最后
【互动】