ARTICLE · 1229810
文档"跨页"解析碎片化,MinerU-Popo破解"卡脖子"
一页PDF丢给MinerU、PaddleOCR、GLM-OCR这些VLM模型,元素类型、位置框、阅读顺序、文本内容,抠得干干净净,单页解析已经接近天花板。
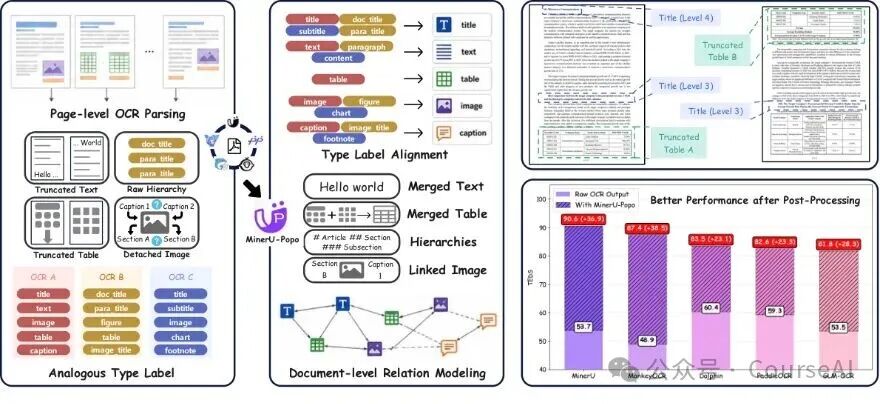
可一份真实的企业文档,表格会横跨两页被劈成两半,段落翻页就断成两截,章节标题的层级关系全丢,图和它的说明文字天各一方。
单页满分,全文不及格。下游RAG检索到的全是碎片,准确率怎么可能高?
上海交通大学、上海人工智能实验室和UC Berkeley联合提出的MinerU-Popo,就是专门来补这块短板的。
不重新造OCR轮子,而是用一个4B的轻量后处理模型,把各家OCR的页级输出"缝合"成连贯的文档级结构。
一、后处理到底难在哪?
你可能会说:拼接文本、合并表格,写规则不就行了?
论文里列了三个真实挑战,条条致命:
1. 跨页几何断裂。 分页是物理的,逻辑是连续的。页底的章节标题可能管辖着下一页的内容;一个逻辑表格会被劈成"表格A"和"表格B"。
2. 解析输出冗余。 OCR结果包含全量元素,但每个任务只需要其中一小撮。做标题层级分析时,海量正文和表格全是干扰项。
3. 长文档可扩展性。 几百页的财报直接塞进轻量模型会爆上下文,而简单切块又会让前后块的层级判断"打架"——比如第一个块里的全局标题是1级,后面块缺了参照系,就会把2级标题误判成1级。
规则搞不定,通用大VLM做后处理又太贵、太慢、没法私有化部署。这就有了MinerU-Popo的解题思路。
二、四大子任务:把文档级解析拆成四个专项
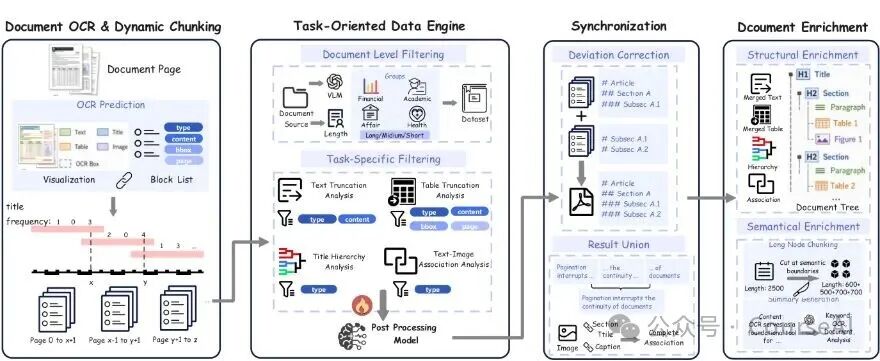
MinerU-Popo的核心洞察是:文档级结构 = 四个可解的子问题。
文本截断恢复:判断相邻文本块是否被分页/分栏/插图打断,该拼就拼。
表格截断恢复:预测跨页表格是否同属一个逻辑表,并给出逐列的单元格合并策略——不仅拼起来,还要决定边界单元格是保留还是合并。
标题层级重建:这是最有意思的一个。GLM-OCR只认两级标题,Dolphin认三级,而MinerU-Popo直接预测开放式整数层级——文档嵌套多深,它就认多深,天然适配任意深度的复杂文档。
图文关联分析:给每个caption找到它的图/表,再找到管辖它的章节标题。
四个子任务各管一段,拼起来就是把页面级碎片重组成一棵文档树。
三、三个关键设计撑起4B小模型
3.1 任务导向数据引擎:让模型只看该看的
这是全文最工程化的部分。
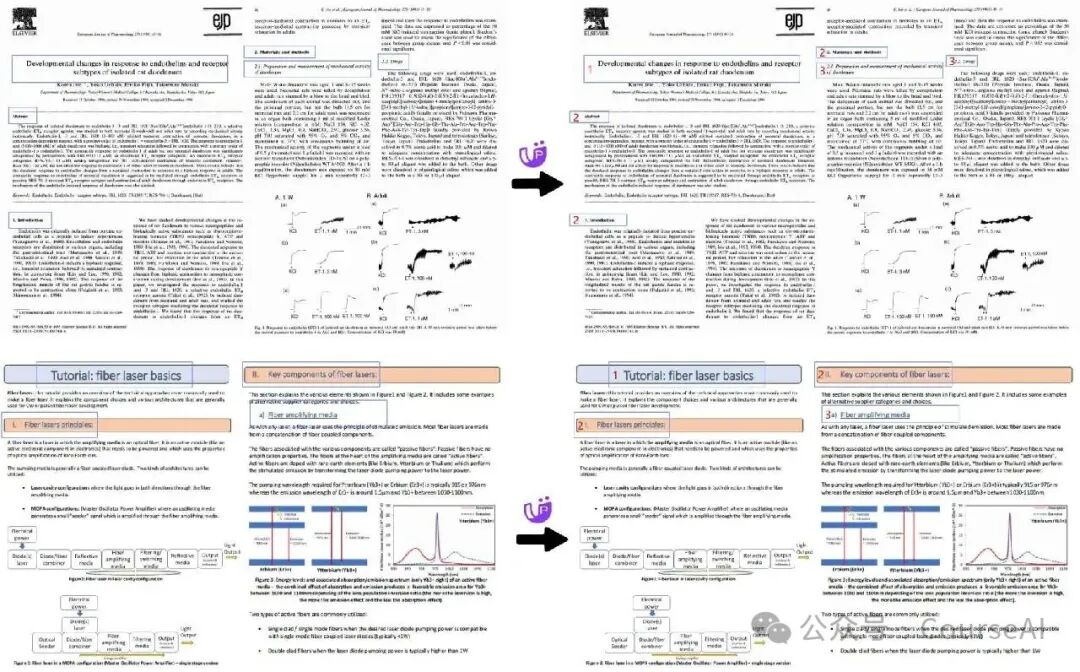
团队从Common Crawl等真实来源收集文档,用VLM按内容领域(科技/学术/医疗/法律等)、版式、长度做文档级过滤和均衡采样,再用启发式规则做任务特定过滤:
层级分析 → 只留title元素 图文关联 → 只留title/caption/image/table 文本截断 → 靠首尾句和标点规则筛掉明显完整的段落,只取首句末句 表格截断 → 锁定页边界表格,校验列数一致性和bbox宽度
结果就是:输入token大幅缩水,干扰信息被砍掉,30K训练数据(8张H200训6小时)就把4B模型喂到90分。
3.2 动态分块+重叠同步:长文档不断层
这是解决长文档的关键一招:
动态分块:不是固定步长切,而是在窗口内选任务元素密度最高的页作为切点,保证重叠区有足够参照物。块与块之间留3页重叠。 重叠同步:以首个块为锚点,计算相邻块在重叠区域标题层级的平均偏差,逐块校准后续预测。
没有这套机制,长文档整篇硬跑的文本截断召回率会从93.8%掉到86.6%。
3.3 文档增强:为RAG而生的树结构
最后把结果组装成树:层级定父子,段落/合并表格/关联图像挂到对应章节节点下。
再做语义增强——长节点按段落边界切段(避开跨页拼接点),LLM为每个节点生成摘要。
检索时嵌入的是"标题路径+摘要",而不是整段正文。
四、实测成绩:这才是真本事
1. 标题层级TEDS全面提升20%以上,而且是套在五个主流OCR模型上都涨:
| 90.6 | ||
| 87.4 | ||
| 83.5 | ||
| 82.6 | ||
| 81.8 |
2. 小模型吊打大模型:TEDS 90.6 vs Qwen3-VL-32B的78.0,速度0.37 vs 0.04 doc/s。领域微调+输入裁剪的威力。
3. RAG延迟最高降70%,准确率还更高:因为检索的是浓缩的标题+摘要,单次查询从68s降到约20s。
4. 端到端QA:基于文档树导出的JSON/Markdown格式在MMDA上超60%准确率,比SHT/XML格式高出一截——因为后者缺了截断恢复、层级、关联这一整套后处理。
结尾
文档解析的竞争,已经从"单页抠得准"进入到"跨页连得通"的阶段。
与其不停地卷更大的OCR模型,不如在既有输出上做一层聪明的"缝合"——4B参数、可本地部署、MIT协议开源,训练成本也就6小时。
单页满分不是终点,把碎片连成知识,才是RAG时代文档解析的终极答案。
参考资源
https://arxiv.org/html/2605.24973 github.com/opendatalab/MinerU-Popo
推荐阅读