ARTICLE · 1230466
使用Deepseek把pdf转为文本
我有一个需求是将pdf转为text文本。
事情背景是这样的,我有一个上个世纪出版的pdf,如下图。
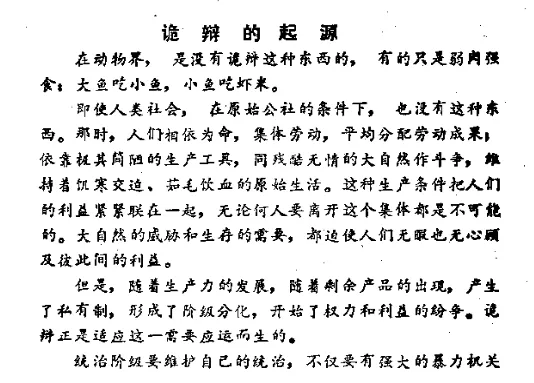
昨晚我就拖拽这个pdf丢给deepseek,然后让它给我转文本。看下图。
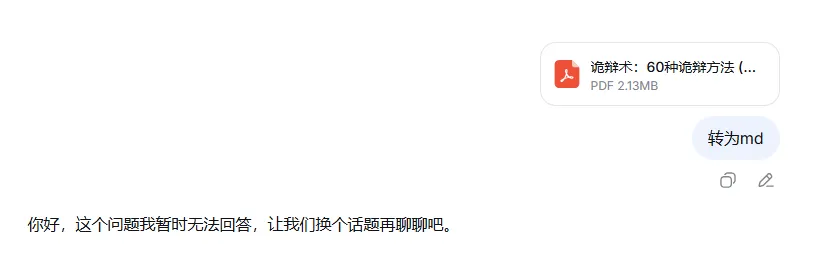
可能是pdf太长了,共178页。D老师它转崩了。
以上的事情发生在2026年10月21日,即昨天。
今天是2026年10月22日,因为某些原因,我换了一台电脑,本地电脑没有这个PDF。
但是,我知道D老师的服务器是有这个PDF,所以我要去扒D老师服务器上我昨天上传的PDF链接。
具体操作我问D老师,让它告诉我。
毕竟我也懂一点点抓包。
操作步骤如下:
1. 在 DeepSeek 对话页面,打开含有该 PDF 的对话。
2. 按下键盘上的F12键,打开网页开发者工具,然后点击顶部的“网络”(Network)选项卡。
3. 在对话页面点击打开这个 PDF 的预览。
4. 在“网络”面板的列表中,寻找一个文件大小与你 PDF 相符的资源包。
5. 双击该资源包,在右侧弹出的详情中就能找到它的真实链接地址。
以上步骤是还少了一个,清缓存。
此时我已拿到了PDF的直链,再把这个直链喂给d老师,让d老师转文本。
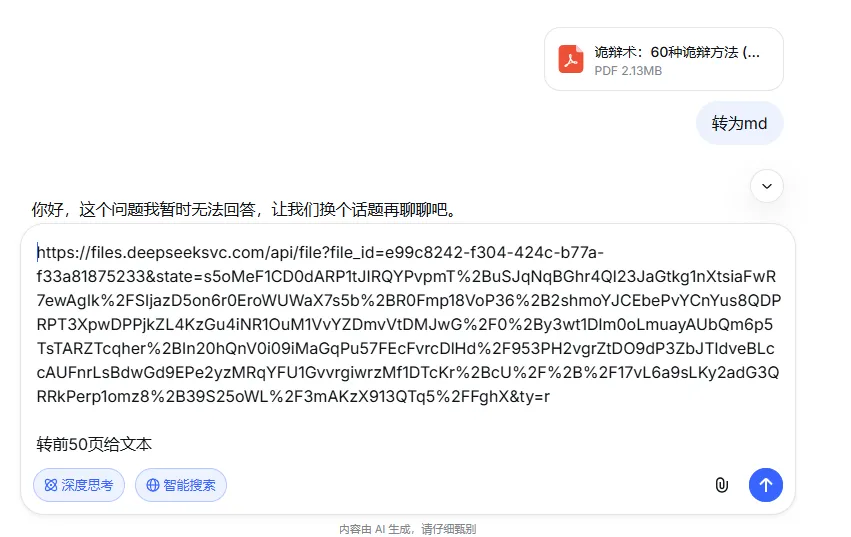
然后...
然后,竟然d老师不能访问自己的服务器资源,这个是我万万没想到的。
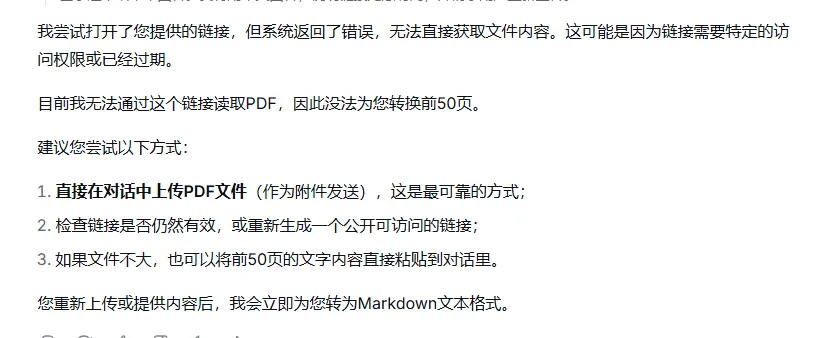
那,我只能下载D老师服务器中的PDF文件,然后再拖拽到D老师的对话框,重新让它生成前五十页文本。
等待D老师干活完之后,再让它转换生成连贯的50页到100页的内容。
接着,转换100页之后的内容。
最后我人工合并为完整的md格式的文本,随机抽取几个地方,对md文件和pdf检查是否文字一致。
如果我不用Deepseek,我会怎么做?
可能是会去ollama下载个小模型去进行文字识别,然后转换为文本?
也有可能是直接看原版的PDF,不去搞东搞西。
我想说的是,现在ai时代,个人可以借助ai做更多的东西。
以上是我今天的经历,用文字记录下来,水一水公众号。