ARTICLE · 1234706
黄仁勋:AI不是软件,是制造业智能体五要素,企业能自建的只有两样
一、柏林那句反常识:AI是制造业,不是软件
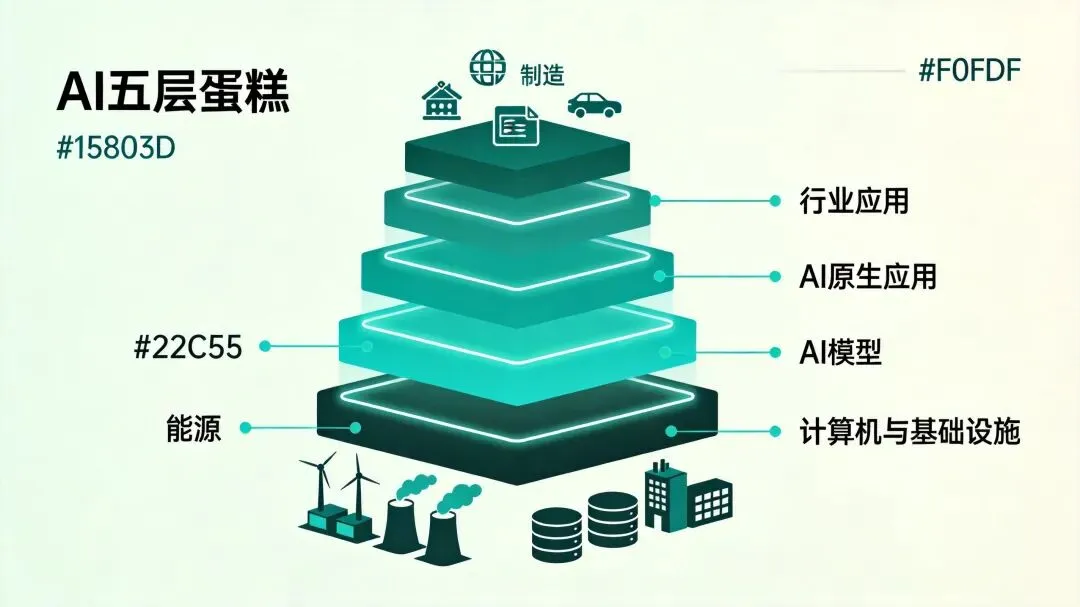
黄仁勋把AI比作一个"五层蛋糕":最底层是能源,往上是计算机和基础设施,再往上是模型,然后是AI原生应用,最顶层是嵌入到各行各业的数字智能。
他的逻辑很直白:能源给AI工厂里的计算机供电,计算机跑模型产出Token,Token再长进每一个应用里。所以"想参与AI经济,别只当消费者,要当生产者"。
这句话背后是他对摩尔定律的判断——他认为摩尔定律基本走到尽头了,所以只能靠"极致协同设计",从芯片到系统、从系统软件到算法,整体一起改。他给了一个对比:过去十年,AI算力提升了约100万倍,同期摩尔定律大约只有100倍,差出来的部分,靠的就是这种全栈协同。
📊 柏林现场算的一笔账(据演讲实录口径):• 一座1吉瓦级AI工厂:造价约500亿美元• 年产值约400亿美元,晚通电3个月≈蒸发约100亿美元潜在营收• DSX POD:把整座数据中心搬进工厂预装成集装箱,现场部署从约6个月缩短到最快14天• Vera Rubin:100%液冷,一个机架连72个GPU;上一代组装一台约2小时,它不到5分钟
这里我想多说一句。过去企业买GPU,比的是单卡性能;现在黄仁勋卖的是整座AI工厂的交付效率——把芯片、机架、网络、液冷、供电和部署标准打包成一套系统。
这对企业的含义其实很明确:算力本身正在从"稀缺资源"变成"可交付的产能"。真正的瓶颈,正在从"买不到卡"转向"用不起来"。而这个瓶颈,花钱解决不了。
二、智能体五要素:模型是买来的,只有两样是你的
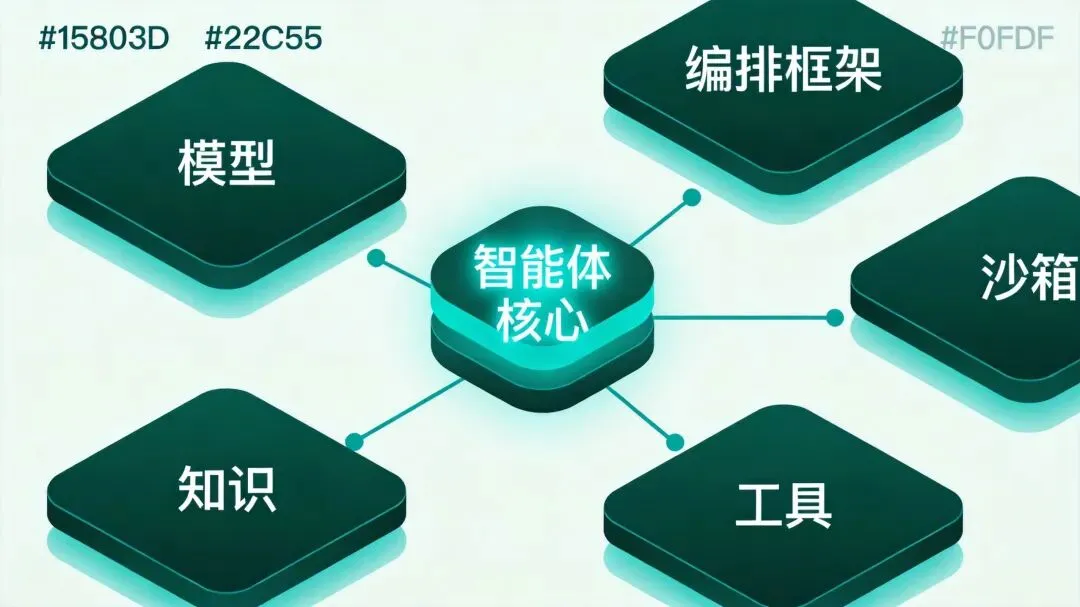
演讲中间最长的一段,讲的是智能体。他说得很干脆:单靠模型不够,模型只是大脑;真正能干活的是智能体。而一个智能体,必须由五样东西组成。
| 模型 | ||
| Harness(外骨骼) | ||
| 沙箱 | ||
| 知识 | 只有你有 | |
| 工具 | 只有你有 |
他还顺手把这五样东西和硬件对上了:模型在Vera Rubin NVL72上跑,外骨骼在Vera MGX节点上跑,知识由Vera CMX存储节点提供,工具交给专跑CUDA-X库的Vera RTX计算节点。
关于模型,他这次很坦白:英伟达的开放模型,尤其是语言模型,不一定处在最前沿。但权重、训练数据和复现脚本整套都开放了,企业拿自己的数据做后训练,就能把它练到适合自己业务的水平。他管这个叫"主权智能"。
我的判断是:五要素里,模型可以买,沙箱可以开源,外骨骼也有现成的。真正拉开企业之间差距的,是后两样——知识和工具。
知识和工具是什么?说白了,就是你公司几十年攒下来的流程、口径、规则、案例,以及你手上那些真正在跑业务的专业软件。这些别人抄不走,也买不到。这一点,跟我之前梳理企业知识库时的结论是一致的:知识层怎么组织,决定了智能体的上限在哪。
演讲里还有一个细节挺有意思。他举起一台轻薄笔记本——RTX Spark,1 PFLOPS算力、128GB统一内存,10月16日已经开售。他说,2016年他亲手送到OpenAI的那台DGX-1,指标也是1 PFLOPS和128GB,只不过当年要两个人抬上楼。
他的结论是:未来的工作场景,是你把任务交给它,它去调用软件帮你把活干完。你不再是"使用"软件,你是在"雇佣"电脑。这句话对做企业信息化的人来说,值得琢磨——我们过去二十年做的事情,很大一部分是"帮人操作软件";接下来要做的,可能是"帮软件被智能体调用"。
三、安全不是愿望,是工程:OpenShell和Sentry
这一段我认为是全场最值得企业记住的。他的原话大意是:希望不等于安全,安全不是一种愿景,它是技术和工程。
英伟达现场放的那段宣传片先自嘲了一把:眼下能拦住智能体乱来的唯一办法,是礼貌地求它"请别删东西"。这话听着好笑,但很多企业部署Agent的现状确实就是这样——靠提示词里的几句叮嘱。
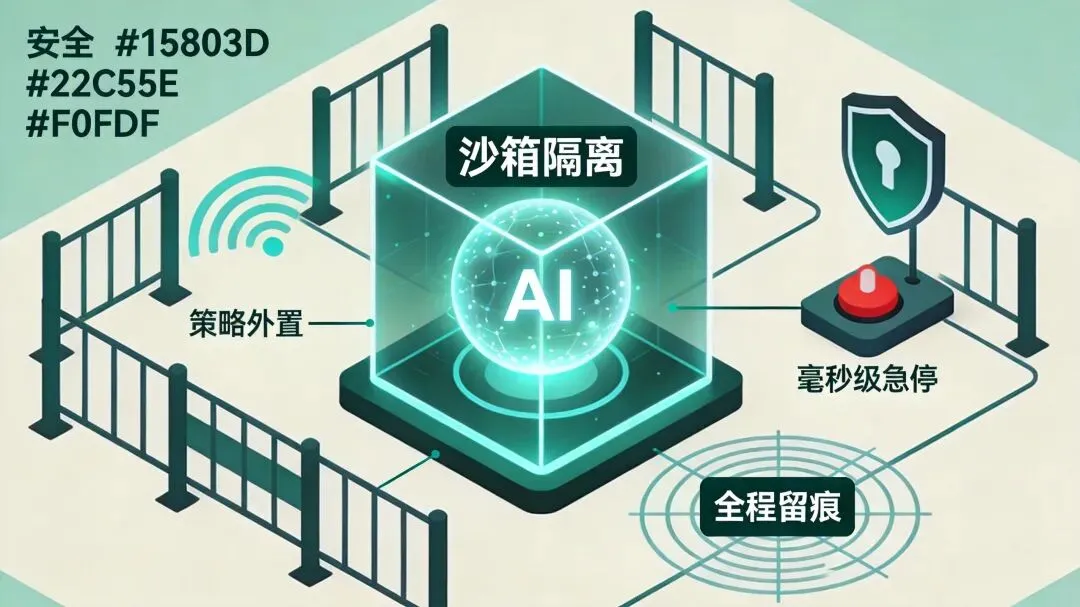
他给的做法是把规矩写在智能体之外。发布的OpenShell参考架构,思路是给每个智能体配门禁、隔离室和急停按钮:
🔐 OpenShell + Sentry 的管控思路:• 沙箱隔离:每个智能体关进自己的沙箱,能读写哪些文件、能连哪些网络,细到每一次系统调用,都由沙箱外的策略说了算• 密钥不入其手:凭据根本不下发给智能体,出站请求要经过沙箱外的监督机制批准• 形式验证:每次策略变更都会做校验,限制权限上限,智能体拿不到超出预期的访问权• 硬件级急停:Sentry跑在BlueField-4上,守在主机之外;智能体的推理流量经过它,一旦越界,毫秒级切断与该模型的连接并隔离• 全程留痕:保存可验证的操作记录,用于检测、调查和响应• 开源可及:OpenShell以Apache 2.0开源,从边缘到云都能跑
他打了个比方我印象很深:就像早期互联网病毒无处不在,直到浏览器对网页能做什么做了严格限制,局面才稳住。OpenShell对智能体做的是同一件事——执法发生在智能体之外,而不只是在模型内部。
这一点,和我一直强调的"Agent安全边界不应该画在提示词里,而应该画在系统外面"完全对上了。最小权限、策略外置、硬件级急停、全量留痕——这四条,是任何一家要认真用Agent的企业,都绕不过去的基础设施。国内已经有厂商在往这个方向做,英伟达这次等于是把参考架构开源摆到了台面上。
四、知识才是分水岭:Agent Knowledge Foundation
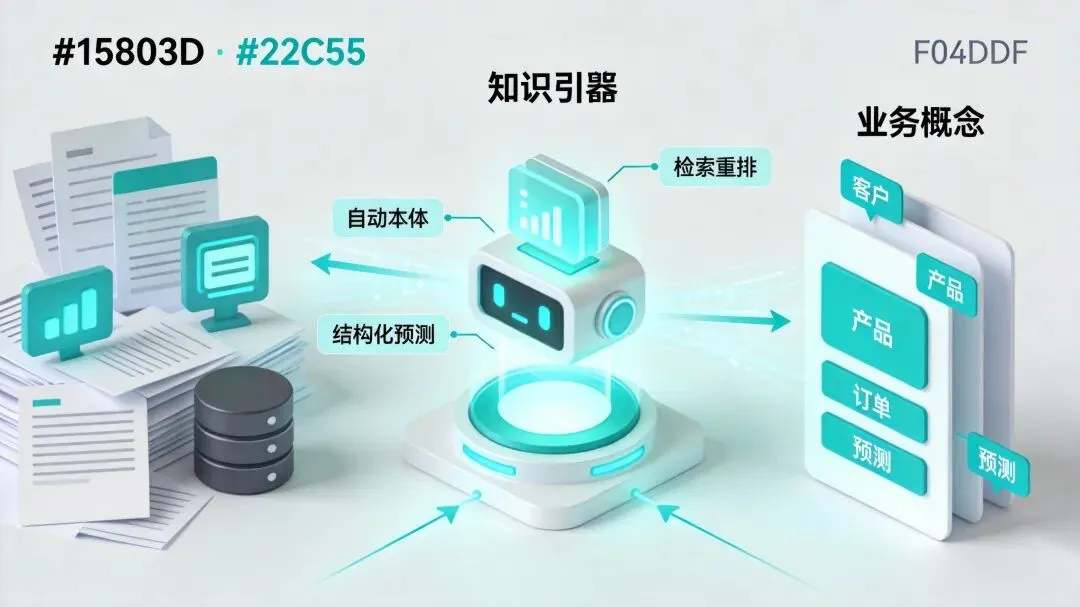
回到五要素里最关键的"知识"。黄仁勋说了一句我认为是全场最实在的话:让智能体变成超级智能体的,是让它接触到公司的知识。
为了把这件事做通,英伟达在GTC柏林同期扩展开源Agent Toolkit,新增了一块叫Agent Knowledge Foundation的知识底座。拆开看,它主要给了三样东西:
- Auto-Ontology(自动本体)
:把企业原始数据翻译成"客户、产品、订单"这类业务概念,并映射它们之间的关系——这一步,本质上是给数据补上业务语义 - Nemotron Retriever
:负责文档解析、嵌入和重排,把查询和内部知识关联起来,再按相关度排序汇总 - Kumo系列模型
:Kumo Tabular、Kumo Relational、Kumo Time Series、Kumo Forecast,直接在结构化业务数据上做预测
它的卖点总结起来就一句话:数据不用搬家、不重建工作流、不改现有的治理控制。对企业来说,"数据不出域"这四个字的分量,做过合规的人都懂。
落地侧的反馈也摆出来了。据官方披露:SAP微调后的重排模型跑得快了近3倍;ServiceNow把重排延迟降低了约25%;亚马逊OpenSearch服务在搜索步骤更少的情况下提升了相关性,且几乎没有增加延迟。(以上均为厂商披露口径,以原始报告为准。)
黄仁勋在现场举了一个很"业务"的例子,我觉得特别值得抄:供应商发来一封缺货或延迟通知(非结构化文档)→ 公司的订单存在SQL数据库里(结构化数据)→ 用预测模型算出哪些订单会缺货 → 再用向量检索找到替代部件的工程文档。
你看这条链路,走通的不是模型,而是"知识 + 工具"的组合。这也正是我一直说的:企业AI的难点从来不在模型层,而在知识层——文档、数据库、业务语义、口径规则,能不能被智能体稳定地读到、读懂、用对。
但反过来讲,工具越强,越照出数据治理的短板。如果你的主数据本身是一团乱麻、同一个客户在五个系统里有五个名字,再好的本体和检索也救不回来。这是我看了这么多厂商方案之后最深的体会:智能体时代,数据治理不是IT的选修课,是必修课。
五、给企业的三步动作:先盘家底,再放自治
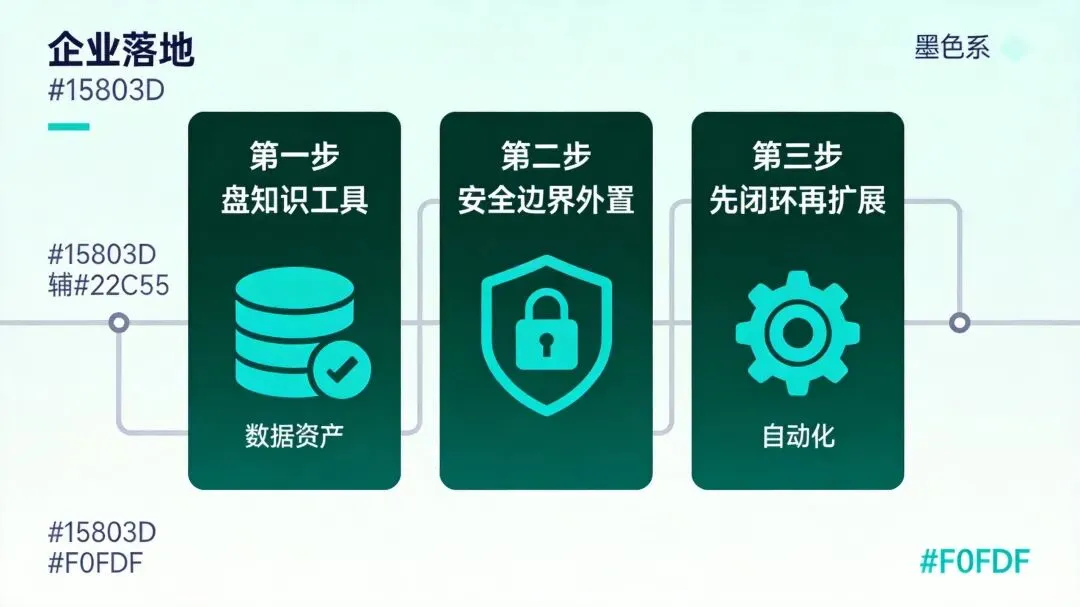
这场演讲信息量很大,但对绝大多数企业来说,能立刻用上的其实就三件事。
✅ 第一步:别急着选模型,先盘"知识"和"工具"模型随时可以换,今天用这家明天用那家都不是问题。但你公司的流程口径、业务规则、历史案例、专业软件,是别人抄不走的。先花力气把这些变成智能体可稳定读取的资产,比追新模型划算得多。✅ 第二步:把安全边界画在智能体外面最小权限、策略外置、硬件级急停、全量留痕。顺序很重要——先有管控制度,再放开自治。不要让Agent靠"你听话点"来守规矩,要靠沙箱和策略来守。✅ 第三步:从"人指挥AI"过渡到"AI在边界内跑闭环"别一上来就追求全自动。先从高频、低风险、可审计的场景切入——对账、异常提示、文档检索、数据校验,跑顺了、留痕齐了、责任清晰了,再往外扩。
说到底,这一轮AI竞赛,企业真正要比的不是"我用了哪个模型",而是"我把多少自有知识和流程,变成了智能体可用的资产"。
黄仁勋说"每一家公司最终都会成为AI公司"。这句话对欧洲公司说,也是对国内企业说的。但顺序别搞反了:不是先买AI,再想怎么用;而是先把自己搞清楚,再让AI来接手。
写在最后
柏林这场演讲,最值钱的其实不是Vera Rubin,也不是台上那几只不太听话的机器鸭,而是那句"安全不是愿望,是工程"。
它把AI落地从"信仰问题"拉回到了"工程问题"。这对做企业信息化的人来说,反而是个好消息——信仰没法排期,工程可以。
工程问题意味着可以拆解、可以分工、可以验收、可以复盘。这意味着接下来企业之间拉开的差距,不是谁更早相信AI,而是谁更早把AI当成一件需要严谨交付的事来干。
AI不是软件,是制造业。这句话,企业不妨当成一句提醒来听:既然是制造业,那就得按制造业的规矩来——标准化、可追溯、控成本、讲交付。
数据来源与免责声明:本文涉及的产品发布、技术架构与预测数据,主要来自主流媒体仅供参考。本文仅代表个人观察与分析,不构成任何投资或采购建议。