ARTICLE · 1235986
2026 AI 文档解析实战:你的 RAG 答不准,多半错在第一公里
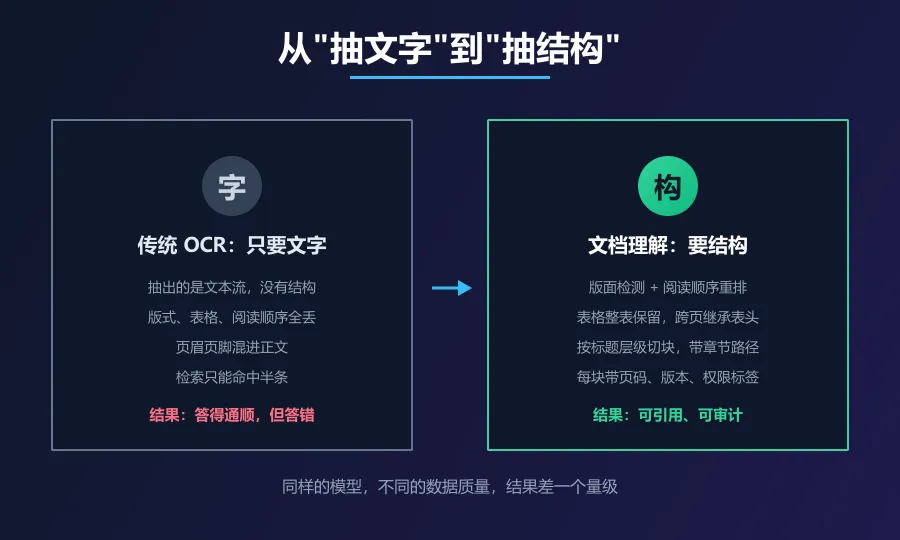
你换模型、调提示词、加 rerank,答案还是错——因为那份 PDF 里的表格,在进知识库之前就已经被拆烂了。
这两年做企业 AI 应用,最常听到的一句抱怨是:"我们知识库都建好了,就是答不准。"
于是团队开始第二轮投入:换更强的模型、把提示词改十几版、加一层 rerank、把召回量从 5 调到 20 再调回 5。
折腾了一个月,准确率从 61% 涨到了 67%。
问题出在哪儿?
有一次我把他们知识库里的一条"证据"原文打出来,全组都沉默了。那条所谓"证据"长这样:
供应商 A 公司 B 公司 C 公司 账期(天) 30 45 60 结算方式 月结 月结 预付 70%而它对应的原始 PDF,是一张跨页的三线表,表头在上一页,数据在下一页。
你为检索层花的所有功夫,都建立在这堆被拆碎的文本之上。第一公里塌了,后面跑得再快也没用。
一、为什么"第一公里"决定了 AI 应用的上限
先认一个现实:企业里真正有价值的知识,八成不在数据库里,而在文档里。
合同、投标书、技术方案、SOP、检测报告、财务报表、设备图纸、扫描件、传真件……它们的共同点是:非结构化、版式复杂、还常常是图片。
行业里常被引用的一组统计是:企业数据中约 80% 是非结构化内容,而其中相当一部分是 PDF 与扫描件。
这就带来一个残酷的放大效应:
📌 事实 1:误差会层层放大,不会层层抵消。解析阶段丢掉一个表头,检索阶段就会把这份文档排到第 3 位,生成阶段就会把 A 公司的账期安到 B 公司头上。一步错,步步错,而且是静默地错。
📌 事实 2:模型越强,越会"圆"你的错误输入。解析错了,模型不会报警,它会用很通顺的语言把错误信息包装成结论。你拿到一份读起来很专业的错误答案——比直接报错危险十倍。
📌 事实 3:这是唯一花小钱能拿到大收益的环节。检索调优要排期、模型替换要预算,而把切块策略从"按 500 字切"改成"按标题层级切",可能只需要一个下午。
💡 一句话判断标准:如果一条"知识"在知识库里已经不是人类读得懂的样子了,那它就不该被检索到。
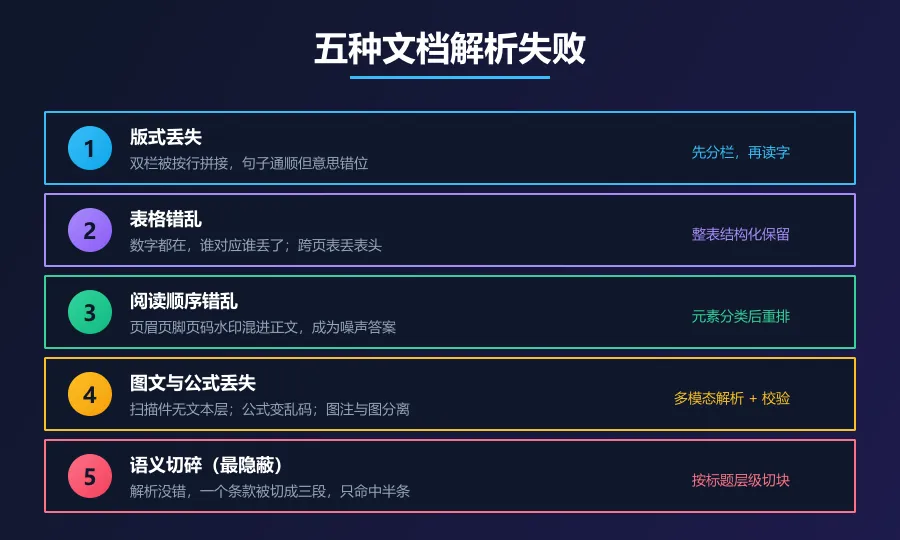
二、五种解析失败,先对号入座
绝大多数"答不准",都能归到这五类里的某一类。找到病因再开药,比继续调提示词有效得多。
① 版式丢失
双栏排版被按行拼接,读出来是"左栏第一行 + 右栏第一行 + 左栏第二行……"
症状:句子读起来通顺但意思完全错位,答案里出现莫名其妙的半句话。
处方:上版面检测,先判定分栏与区块,再按区块内的阅读顺序输出。
② 表格错乱
合并单元格、跨页表格、无线框表格,被拆成一行行散落的文本。
症状:数字都在,但"谁对应谁"丢了。金额、账期、规格串行。
处方:表格必须单独识别成一个结构化对象(Markdown / HTML / JSON),而不是拆成文本行;跨页表格要做表头继承。
③ 阅读顺序错乱
页眉、页脚、页码、水印、脚注混进了正文。
症状:检索命中的是页脚里的公司名,回答里莫名其妙冒出"第 3 页 内部资料 请勿外传"。
处方:元素分类 + 顺序重排,页眉页脚单独归档,默认不参与检索。
④ 图文与公式丢失
扫描件只有图像没有文本层;公式变成 ∫▒〖x^2 dx〗这种乱码;图注与图分离。
症状:整份文档检索不到;技术文档的公式章节变成噪声。
处方:走多模态(VLM)解析路线,公式转 LaTeX,图注与图片建立绑定关系。
⑤ 语义切碎
这条最隐蔽:解析没错,但切块方式错了。
症状:一个完整条款被切成三段,三段分别进了不同 chunk,检索只能命中半条。
处方:按标题层级 + 语义边界切块,保留父子关系;切块要带上"所属章节路径"。
三、文档解析的五层栈
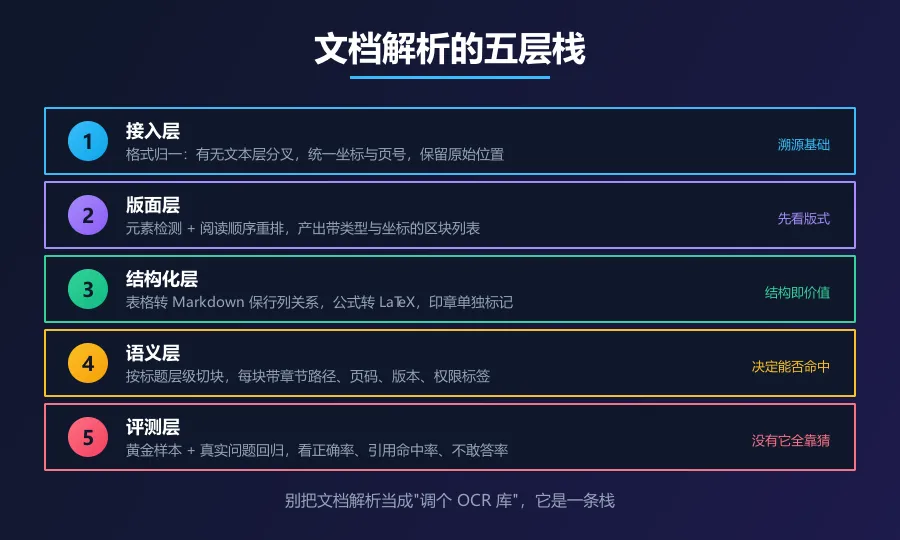
别把文档解析理解成"调个 OCR 库"。它是一条五层的栈,每一层都有明确的输入输出。
1. 接入层:格式归一
先判断 PDF 有没有文本层:有 → 走文本+坐标;没有 → 走图像渲染 统一坐标系与页面尺寸,处理旋转、倾斜、多页合并 保留原始页号与坐标,后面每一步的引用溯源都要靠它
2. 版面层:先"看懂版式",再"读字"
元素检测:标题 / 正文 / 表格 / 图片 / 公式 / 印章 / 手写 / 页眉页脚 分栏判定与阅读顺序重排 这一步的产物应该是带类型和坐标的区块列表,不是一段纯文本
3. 结构化层:把"看起来像表格"变成"真的是表格"
表格 → Markdown 或 JSON,保留行列与合并关系 公式 → LaTeX 图 → 图注绑定 + 可选的图像摘要 印章 / 签名 → 单独标记(合规场景关键)
4. 语义层:决定检索能不能命中
- 按标题层级切块
,而不是按固定字符数 每个 chunk 带上:文档名、章节路径、页码、版本、生效日期、权限标签 长表格不切碎,宁可整表作为一个 chunk(配合表头摘要)
5. 评测层:没有它,前四层都是在猜
抽 50 份最痛的文档做"黄金样本" 准备 20~30 条真实业务问题,看的是"答案对不对、引用对不对" 解析方案每换一次,就跑一遍
四、一条能跑起来的最小流水线
不需要重构技术栈。下面这七步,一个熟悉业务的人加一个开发,一周内能跑通。
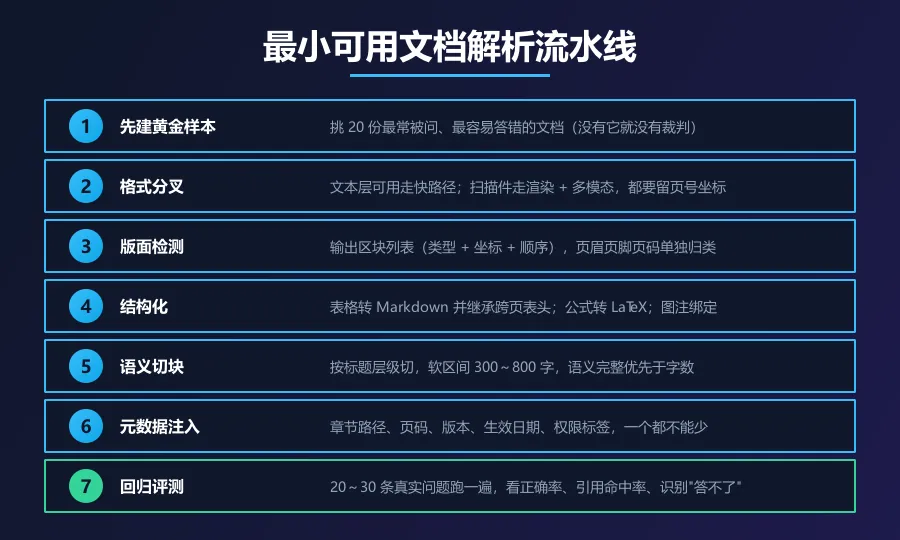
第 1 步|先建"黄金样本"。从真实业务问题倒推:哪 20 份文档最常被问、最容易答错?把它们抽出来。没有这一步,后面所有优化都没有裁判。
第 2 步|格式分叉。文本层可用的走快路径;扫描件走渲染 + 多模态路径。两条路都要保留页号坐标。
第 3 步|版面检测。输出区块列表(类型 + 坐标 + 顺序),页眉页脚页码单独归类。
第 4 步|结构化。表格转 Markdown 保留行列;跨页表继承表头;公式转 LaTeX;图注绑定。
第 5 步|语义切块。按标题层级切,chunk 大小给个 300~800 字的软区间,但以语义完整为准,不要硬切。
第 6 步|元数据注入。每块都带:doc_id、section_path、page、version、effective_date、perm。前两个决定引用能不能追溯,后三个决定冲突时该信谁。
第 7 步|回归评测。20~30 条真实问题跑一遍,看三个数:答案正确率、引用命中率、不可回答识别率。
一段最小示意(伪代码,重点在结构而不是语法):
def parse_and_index(pdf_path):pages = load_pdf(pdf_path) # 1) 保留页号 + 坐标for page in pages:if page.has_text_layer: # 2) 快路径blocks = extract_text_blocks(page)else: # 2) 扫描件路径blocks = layout_detect(page.render()) # 3) 版面检测for b in blocks:if b.type in ("header", "footer", "watermark"):b.indexable = False # 页眉页脚不参与检索if b.type == "table":b.text = table_to_markdown(b, inherit_header=True) # 4) 结构化if b.type == "formula":b.text = formula_to_latex(b)sections = build_section_tree(blocks) # 5) 按标题层级还原结构chunks = [{"text": s.text,"meta": {"doc_id": doc_id, "page": s.page,"section_path": s.path, # 6) 元数据:可溯源"version": version, "effective_date": eff, # 冲突时定优先级"perm": acl_tags, # 权限过滤,漏了就是事故},}for s in split_by_semantic(sections, soft_min=300, soft_max=800)]return chunks # 7) 进评测集回归
注意这里三个关键设计:页眉页脚不进检索、表格整表保留 + 表头继承、每个 chunk 带章节路径和版本。这三条能直接消灭前面说的五类失败中的四类。
五、方案怎么选:四类文档,四条路线
怎么选?一句话:能拿到文本层就别上模型,版式复杂就先做版面,扫描件才上多模态,表格永远单独处理。不要为了"统一技术栈"把所有文档都塞进一个 VLM,那是成本和准确率的双重浪费。
⚠️ 一个重要提醒:用多模态模型解析扫描件时,它可能"补"出文档里根本没有的数字。关键字段(金额、日期、编号、规格)必须做二次校验——要么规则校验(格式/范围/校验位),要么交叉验证(同一数字在文档内出现多次)。
六、今天就能做的五件事
按投入产出比排序,不用等排期:
- 随机抽 10 条知识库里的 chunk,人读一遍。
读不懂的,就是失败的解析。这一件事就能让你知道问题有多严重。 - 把"按字符数切块"改成"按标题层级切块"。
这是回报最高的一次改动,通常半天能上线。 - 给每个 chunk 补上
章节路径和页码。引用可追溯性立刻从"没有"变成"有"。 - 把页眉页脚页码从索引里剔除。
顺手治掉一批"神秘噪声答案"。 - 建 20 条真实问题的回归集。
一个表格 + 一个脚本就够,从此所有优化都有裁判。
实测场景:某制造企业的设备维修知识库,原先用的是最朴素的 PDF 文本抽取。把切块改成按"章节 + 表格整表"之后,同样的模型、同样的检索参数,人工抽检 50 个问题的正确率从 62% 提到 84%。模型一行没改。
七、避坑清单
⚠️ 不要只测"能不能抽出文字",要测"人能不能读懂"。解析质量的第一裁判是人类读者。 ⚠️ 不要迷信单一方案。一份文档里可能同时有文本页、扫描页和表格页,路由 + 回退才是正解。 ⚠️ 不要让表格散成文本行。表格的价值在结构,拆了就一文不值。 ⚠️ 不要忘记权限标签。解析阶段不打权限,检索阶段就可能把别的部门的文档喂给模型。 ⚠️ 不要把 OCR 结果当成"已知事实"。关键数字必须有校验,尤其是金额和日期。 ⚠️ 不要一次改多个变量。版面、表格、切块分开上,否则你不知道收益来自哪一层。
八、速查表:现象 → 病因 → 处方
九、小结
2026 年,模型能力的差距在收窄,数据供给能力的差距在拉大。
同样是接一个模型,有人做出来的是"演示很惊艳、上线就翻车",有人做出来的是能进生产、能被审计的系统。区别往往不在模型,而在文档进知识库那一步,有没有被认真对待。
如果你现在只做一件事,就做这个:从知识库里随机抽 10 条 chunk 打印出来,一条一条人读。读不懂的,就是你要修的地方。
答案会比你想象的更容易优化。
📌 把数据喂对了,只解决了"答得准"。下一条战线是"跑得住"——Agent 上线之后,你怎么知道它在生产环境里到底干了什么?下一篇我们聊 AgentOps:AI 应用上线之后的可观测性。
*本文数据与产品信息来自公开资料,文档解析工具的定价、模型能力可能随时调整,请以厂商官方文档为准。*