ARTICLE · 1240055
美团晋升新规背后:AI 落地能力的度量架构
美团晋升新规背后:AI 落地能力的度量架构大家好,我是玄姐。 最近,“美团晋升大调整”的消息在技术圈传得很广。据网传信息,今年晋升通过者的调薪幅度普遍在 10% 到 20%,校招背景从 L5 冲 L6 的门槛明显抬高,AI 方向的探索与实践被纳入晋升评估的核心维度。 这类内部政策没有官方公告,具体口径大家以内部为准。但我关心的不是数字本身,而是一个更硬核的问题: “会用 AI”是一句口号,“AI 落地能力”却必须是一组可采集、可归因、可审计的数据。度量做不出来,晋升评估就只能回到答辩 PPT 和 leader 印象。 这两年我带团队给 70 多家头部企业做 AI 落地,几乎每个 CTO 和 HRBP 都问过我同一个问题:“全员都在用 AI 了,怎么区分谁用出了结果?”今天就借美团这个案例,从架构视角把这件事拆开讲。 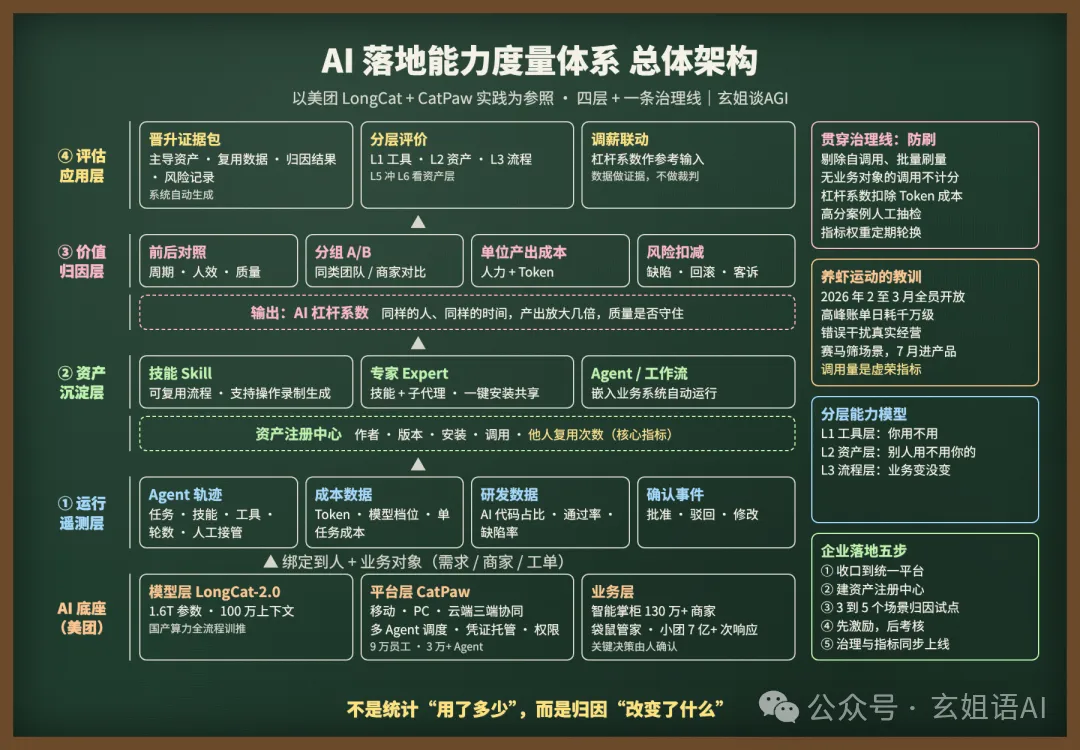
过去大厂的晋升,本质是一个惯性系统:到了年限,绩效过线,leader 提名,答辩走流程。这个系统的输入是“时间”和“稳定性”,它奖励的是不出错。 AI 进入日常工作流之后,同样一个人在同样的时间里,产出可以相差几倍甚至十几倍。公司要买的就不再是“时间”,而是“撬动产出的方式”。 所以门槛抬高和调薪拉高,两件事其实是同一个逻辑的两面: 这不是个例。海外 Meta 已经公开把 AI 使用情况正式纳入绩效评估;国内各家大厂也都在调整激励结构。当 AI 从少数人的工具变成全员的基础设施,“用没用 AI”不再有区分度,“用出了什么结果”才是新的筛选维度。 问题是,这个维度要怎么量出来?先看美团的 AI 底座长什么样。 要度量 AI 落地能力,前提是 AI 真的跑在可观测的平台上。美团恰好有一套比较完整的三层底座。 美团在 2026 年 7 月开源了万亿参数大模型 LongCat-2.0。据新华网报道,它总参数 1.6T,原生支持 100 万 Token 上下文,是在万卡级国产算力集群上完成全流程训练和推理的开源万亿参数模型。 自研模型对“度量”有一个常被忽略的价值:调用链路、Token 成本、效果数据都在自己手里,不用依赖外部厂商的账单。 CatPaw 最早在 2023 年以编辑器插件的形式在美团内部上线,2026 年 7 月 27 日升级为全场景 AI Agent 平台,对外开放。公开数据是: 从架构看,它有几个关键能力,每一个都和后面要讲的度量有关: 智能掌柜(堂食餐饮):服务超过 130 万家餐饮商家,累计解决商家问题 860 万个; 袋鼠管家(外卖餐饮):菜单优化、经营诊断、评价管理、门店巡检; 小团(消费者侧):覆盖找餐厅、做攻略、帮预订、点外卖等 12 类需求,累计响应超过 7 亿次。 有一条设计原则值得注意:CatPaw 不做最终经营决策,调价、发布活动这类关键操作由经营者确认。这和我们一贯讲的“模型提议,人和代码决定”是同一个思路。 讲度量之前,必须先讲一个反面教材,而且就发生在美团自己身上。 2026 年 2 到 3 月,美团在内部发起了全员“养虾运动”:大规模引入 OpenClaw 这类开源 Agent 框架,开放模型调用。员工热情很高,坊间流传两周沉淀出海量技能。 但据公开复盘报道,结果并不全是正面的: 美团随后用“赛马机制”筛选出少数真正可用的场景,到 7 月才让 AI 进入真实产品流程,纠偏用了四个多月。复盘的结论是:AI 落地是业务、组织、技术三位一体的系统工程。 这段经历对晋升评估极有参考价值。它说明三件事: 所以,一个靠谱的 AI 落地能力度量体系,核心不是统计“用了多少”,而是归因“改变了什么”。 结合美团的实践和我们在客户那里落地的经验,我把 AI 落地能力度量体系拆成四层,外加一条贯穿的治理线。 所有 AI 行为必须跑在统一平台上,才能被采集。这也是 CatPaw 这类平台对企业的意义:平台化是度量的前提,散落在个人电脑上的“野生龙虾”是量不出来的。 需要采集的数据: 关键设计:遥测数据要绑定到具体的人和具体的业务对象(需求单、商家、工单),而不只是账号。 个人用 AI 提效,价值只在自己身上;把能力沉淀成可复用资产,价值才会在组织里放大。这一层需要一个统一的资产注册中心,登记三类资产: 每个资产都要记录作者、版本、被谁安装、被调用多少次、在哪些业务里跑。最有价值的指标是“他人复用次数”:一个技能被 500 个同事用了一年,比自己写了 50 个没人用的技能有价值得多。 这是整个体系最难、也最关键的一层。要把 AI 行为和业务结果连起来,常用四种方法: 归因的最终产出是一个“AI 杠杆系数”:同样的人、同样的时间,借助 AI 之后产出放大了多少倍,同时质量有没有下降。 度量数据最终要服务于晋升和调薪,但我的建议是:数据只做证据,不做裁判。 只要指标和钱挂钩,就一定有人刷。必须在架构上做防护: “AI 落地能力”不能一刀切。我建议按职级拆成三个层次: 对应初级到中级。看的是:能否把 AI 稳定用在日常工作里,个人周期和质量是否有可量化的提升。这一层在全员普及后只是门槛,不是加分项。 对应中高级,也就是 L5 冲 L6 这一档最关键的分水岭。看的是:能否把自己的工作方式沉淀成技能、专家或 Agent,并且被团队广泛复用。只会自己用、不会沉淀的人,在这一档会越来越难。 对应资深和专家。看的是:能否把 AI 嵌进核心业务流程(比如调度、商家运营、履约),改变流程本身,而不是只在原流程上加速。“养虾运动”纠偏后真正进入产品流程的场景,就是这一层的典型。 一句话总结:L1 看你用不用,L2 看别人用不用你的,L3 看业务因为你变没变。 给想借鉴的企业一个五步路线: 对技术人个人,我的建议也很直接: 第一,AI 落地能力本质上是一个工程问题,而不是态度问题。没有平台、没有遥测、没有归因,“AI 能力纳入晋升”最后只会变成新的答辩话术。 第二,美团的“养虾运动”是一笔很值的学费。它证明了全员开放调用能快速建立认知,但只有赛马筛选、进入真实流程、质量有人兜底,才能变成业务结果。 第三,未来的职级,本质是“杠杆等级”。你个人的产出多少已经不是重点,重点是有多少事情因为你沉淀的能力而变得不一样。AI 是当下最长的那根杠杆,但杠杆要用在对的支点上。 如果你对企业级 AI 原生研发体系(Skills、SDD、Harness、Loop、知识飞轮、评测、治理度量)感兴趣,去 AITutor 领取福利。 AITutor 福利:AITutor 每个人的 AI 原生学习伙伴,业界最丰富 AI 实践和案例,4500+ 门多模态 AI 课程、7×24 小时 AI 导师已全面开放,快来免费体验吧。 
扫码直达: 
PS:1024 福利专场点击预约直播。
当一家公司说“AI 落地能力决定晋升”,它在技术上到底怎么度量?
PS:AI 更多案例深入免费学习去这里,扫码直达:
1.打开 AITutor 新一代 AI 原生学习伙伴:www.aiaitutor.com2.在首页输入你想学习的AI知识” 就能看到更详细更丰富案例。3.包含了图文、视频、播客、闪卡、代码、测验等9种学习模态。
1. 信号解读:晋升逻辑从“时间惯性”切换到“产出杠杆”
1.1 旧系统:年限 + 绩效的惯性模型
1.2 新系统:单位产出的放大倍数
门槛抬高:熬年限的路径被关掉,筛掉还在用旧方式工作的人; 调薪拉高:资源集中给能把 AI 变成业务结果的人。
1.3 不只是美团
2. 美团的 AI 底座:模型、平台、业务三层
2.1 模型层:LongCat
2.2 平台层:CatPaw
内部覆盖约9 万名员工,搭建了超过3 万个 Agent; 研发渗透率超过95%,增量代码中 AI 生成的比例超过50%。
三端协同:移动端发起和确认,PC 端做本地深度执行(文件、浏览器、终端),云端 7×24 小时跑长程任务; 多 Agent 调度:复杂任务拆解后交给多个带专属工具的 Agent 并发执行,进度可见,结果自动汇总; 专家与技能体系:“AI 专家”集成多项技能和子代理,可以一键安装,也可以把个人工作方式封装成专家给团队共享;内嵌浏览器还能录制操作流程,自动生成可复用技能; 企业级管控:运行环境隔离、凭证托管(Agent 不直接接触敏感资产)、分级权限、团队用量和消耗统一管理。
2.3 业务层:商家与消费者侧的 AI 应用
3. “养虾运动”的教训:使用量不等于产出
3.1 发生了什么
高峰期 AI 账单每天烧掉上千万元; 部分“养虾”产生的错误开始干扰真实经营; AI 大量用在日常琐事上,没有触及核心业务。
3.2 对度量的启示
调用量是虚荣指标。如果按“谁用 AI 多”来评,你会得到一张巨额账单,而不是业务结果; 技能数量也是虚荣指标。十万个技能里,真正被反复复用、跑进生产流程的可能只是一小部分;
必须有质量和风险的负向指标。AI 产出的错误干扰了经营,这部分必须扣分,而不是只算产出。
4. 核心架构:AI 落地能力度量体系的四层设计
4.1 第一层:运行遥测层(采集“发生了什么”)
Agent 运行轨迹:任务、调用的技能、工具、轮数、耗时、是否人工接管; 成本数据:Token 消耗、模型档位、单次任务成本; 研发数据:增量代码的 AI 生成比例、AI 代码的评审通过率和缺陷率; 人工确认事件:哪些操作被人工批准、驳回或修改。
4.2 第二层:资产沉淀层(衡量“留下了什么”)
技能(Skill):一个可复用的工作流程,比如“门店差评诊断”; 专家(Expert):多个技能加子代理的组合,对应一个岗位能力; Agent 与工作流:嵌入业务系统、自动运行的智能体。
4.3 第三层:价值归因层(回答“改变了什么”)
前后对照:同一流程引入 AI 前后的周期、人效、质量对比; 分组对照:同类团队或同类商家,用与不用的 A/B 对比; 单位产出成本:每完成一个需求、一个工单、一份报告的综合成本(人力 + Token); 质量与风险扣减:AI 产出导致的缺陷、回滚、客诉、经营错误,按严重度扣减。
4.4 第四层:评估应用层(用于“怎么评”)
晋升证据包:系统自动生成候选人的 AI 实践档案,包括主导的资产、复用数据、归因结果、风险记录; 答辩聚焦:答辩不再讲“我做了什么”,而是讲“我用什么方式让产出放大,凭什么可以复制”; 分层评价:不同职级看不同维度(见第 5 节); 调薪联动:杠杆系数和资产复用度作为调薪的参考输入,而不是唯一公式。
4.5 贯穿治理线:防止指标被刷
反刷规则:剔除自己调用自己、短时间批量调用、无业务对象绑定的调用; 成本约束:杠杆系数里扣除 Token 成本,避免“堆算力换产出”; 抽样审计:对高分候选人的关键案例做人工抽检; 指标轮换:定期调整权重,避免大家只优化单一指标。
5. 分层能力模型:不同职级看什么
5.1 L1 工具层:个人提效
5.2 L2 资产层:能力沉淀
5.3 L3 流程层:业务重构
6. 落地路线:企业怎么搭这套体系
先收口到平台:把分散的 AI 使用收拢到统一的 Agent 平台,没有平台就没有遥测; 建资产注册中心:技能、专家、Agent 统一登记、版本化、可安装、可追踪复用; 选三到五个核心场景做归因试点:不要一上来就全面考核,先用赛马机制找到真正产生价值的场景; 先用于激励,再用于考核:第一年只作为加分证据,跑顺之后再进入晋升硬指标; 把治理前置:成本、质量、反刷规则和指标同时上线,而不是出了问题再补。
把你最擅长的一件事,封装成一个别人能直接用的技能; 盯住复用数据,而不是你自己用了多少次; 每次 AI 带来的改进,都留下前后对照的证据; 主动找一个核心业务流程,尝试用 Agent 重构其中一个环节。
7.写在最后:三点思考
打开 AITutor,新一代 AI 原生学习伙伴:www.aiaitutor.com 在首页输入「你想学习的 AI 知识」,就能看到更详细、更丰富的案例 包含图文、视频、播客、闪卡、代码、测验等 9 种学习模态
PS:1024 福利专场点击预约直播。
8. 加我微信
扫码加我👇有很多不方便公开发公众号的我会直接分享在朋友圈,欢迎你扫码加我个人微信来看👇
加星标★,不错过每一次更新!
⬇戳”阅读原文“,立即体验 AITutor