ARTICLE · 1240744
【AI工具链】跟着敲一遍⑤:Open WebUI 搭 RAG 跑通
 .
 .
 阅读本文

系列:21 天本地 AI 工具链 ·Day 5(第 5/5 篇) 前情回顾:Day 1-4 已经把 Docker、Ollama、Web UI、Python API 全部跑通;Day 5 让模型"懂你的文档"。实测环境:openEuler 22.03 SP4 / x86_64 / 虚拟机 4GB / Open WebUI 0.11.0 / bge-m3
"把 PDF 传上去,它就能回答"——这句话只对了一半。RAG 不是"上传即生效",它是一条链:切分 → 向量化(embedding)→ 检索 → 拼进提示词 → 生成并标注来源。任何一环没配好,模型都会退回"通用闲聊"。本文用 5 段命令把这条链跑通,重点讲清三个最容易踩的坑。
Ollama 监听 0.0.0.0:11434Open WebUI 容器 open-webui在 3000 端口embedding 模型二选一:
| bge-m3 | |||
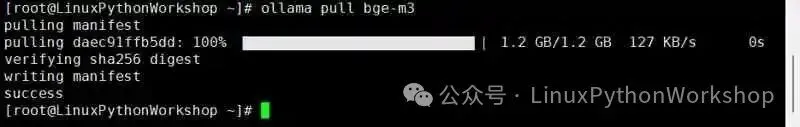
[root@LinuxPythonWorkshop ~]# ollama pull bge-m3[root@LinuxPythonWorkshop ~]# ollama list | grep bge-m3

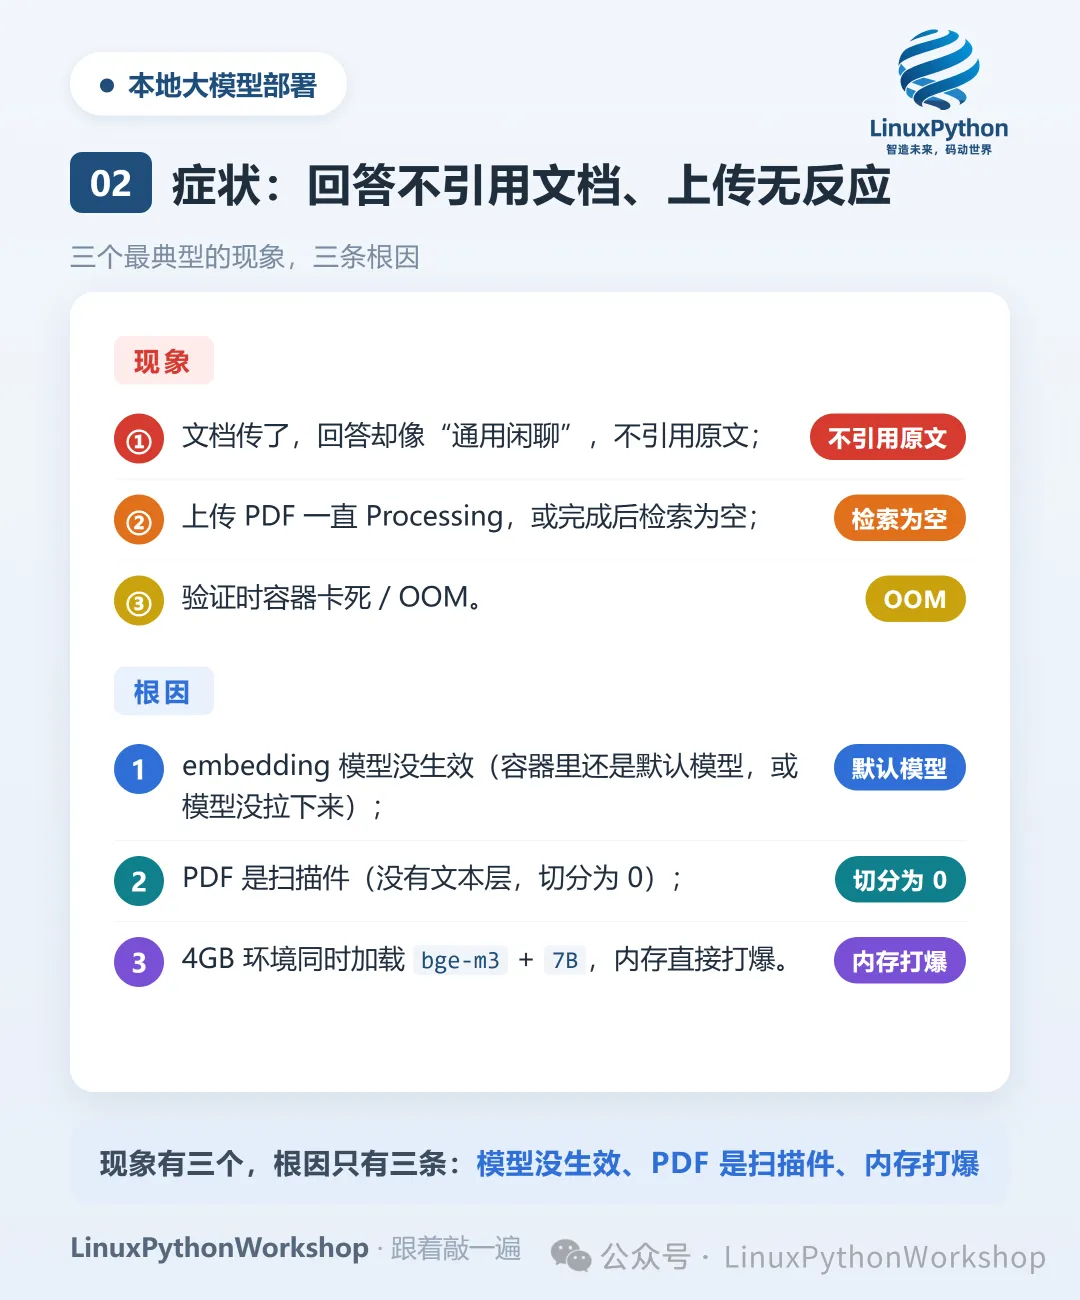
三个最典型的现象:
文档传了,回答却像"通用闲聊",不引用原文; 上传 PDF 一直 Processing,或完成后检索为空; 验证时容器卡死 / OOM。
根因:
- embedding 模型没生效
(容器里还是默认模型,或模型没拉下来); - PDF 是扫描件
没有文本层,切分为 0; 4GB 环境同时加载 bge-m3+ 7B,内存直接打爆。
① 拉 embedding 模型
[root@LinuxPythonWorkshop ~]# ollama pull bge-m3[root@LinuxPythonWorkshop ~]# ollama list | grep bge-m3
📖 初学者讲解:bge-m3 是中文检索的首选,向量维度 1024。它和聊天模型是两回事——聊天用 qwen2.5:0.5b,向量化用 bge-m3,两个都要在。
② 重建容器,启用 RAG
[root@LinuxPythonWorkshop ~]# docker rm -f open-webui 2>/dev/null || true [root@LinuxPythonWorkshop ~]# docker run -d --init --name open-webui --restart always \ -p 3000:8080 -e OLLAMA_BASE_URL=http://192.168.149.132:11434 \ -e RAG_EMBEDDING_ENGINE=ollama -e RAG_EMBEDDING_MODEL=bge-m3 \ -v open-webui:/app/backend/data open-webui:day3 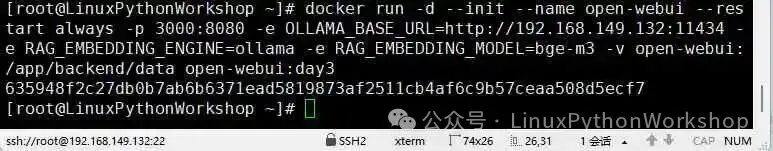
📖 初学者讲解:只删容器,绝不删数据卷open-webui——用户、对话、已建知识库都在里面。RAG_EMBEDDING_ENGINE=ollama 告诉 Open WebUI 用 Ollama 做向量化,而不是内置的 SentenceTransformers。--init 会注入一个轻量 init 进程(tini),负责回收子进程——本次实测中旧容器正因 PID 1 僵尸而无法 rm -f,只能整机重启才清掉。
想调分块参数,再追加:
-e CHUNK_SIZE=1000 -e CHUNK_OVERLAP=150 -e RAG_TOP_K=5。默认值接近,先跑通再调。
③ 校验 embedding 与容器环境
[root@LinuxPythonWorkshop ~]# docker inspect open-webui \ --format '{{range .Config.Env}}{{println .}}{{end}}' | grep RAG 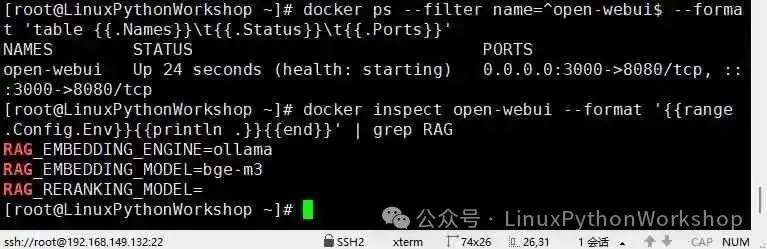
[root@LinuxPythonWorkshop ~]# curl -s http://127.0.0.1:11434/api/embed \ -d '{"model":"bge-m3","input":"测试文本"}' \ | python3 -c 'import sys,json;d=json.load(sys.stdin);e=d.get("embeddings",[]);print("向量数:",len(e),"维度:",len(e[0]) if e else 0)' 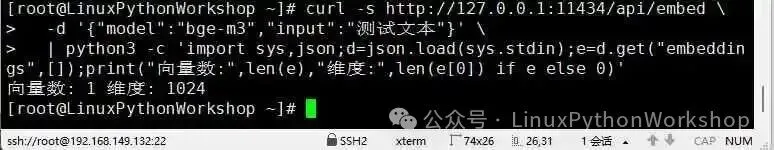
📖 初学者讲解:第一条确认容器里真的带着 RAG_EMBEDDING_MODEL=bge-m3;第二条直连 /api/embed,看到 维度 1024 才算向量化链路通(也可直接跑 python3 day5_rag_verify.py,输出等价)。
④ 建知识库并上传文档
Open WebUI → 工作空间 → 知识库 → 新建集合 day5_rag_test → 上传一份中文 Markdown / 文本型 PDF → 等待状态从 Processing 变为完成 
📖 初学者讲解:优先用 Markdown 或文本型 PDF。扫描件没有文本层,切分出来是空的,传了也检索不到。
⑤ 对话中引用知识库
新建对话 → 输入框输入 # → 选择 day5_rag_test → 提问:"Keepalived 负责什么?" → 回答应引用文档原文,并标注来源 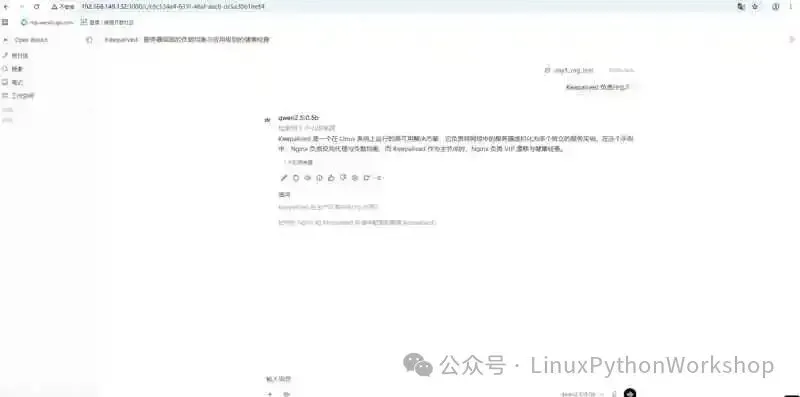
📖 初学者讲解:# 是 Open WebUI 的"挂载知识库"语法。不选集合,模型不知道要去哪检索——这是"回答不引用文档"最常见的原因。
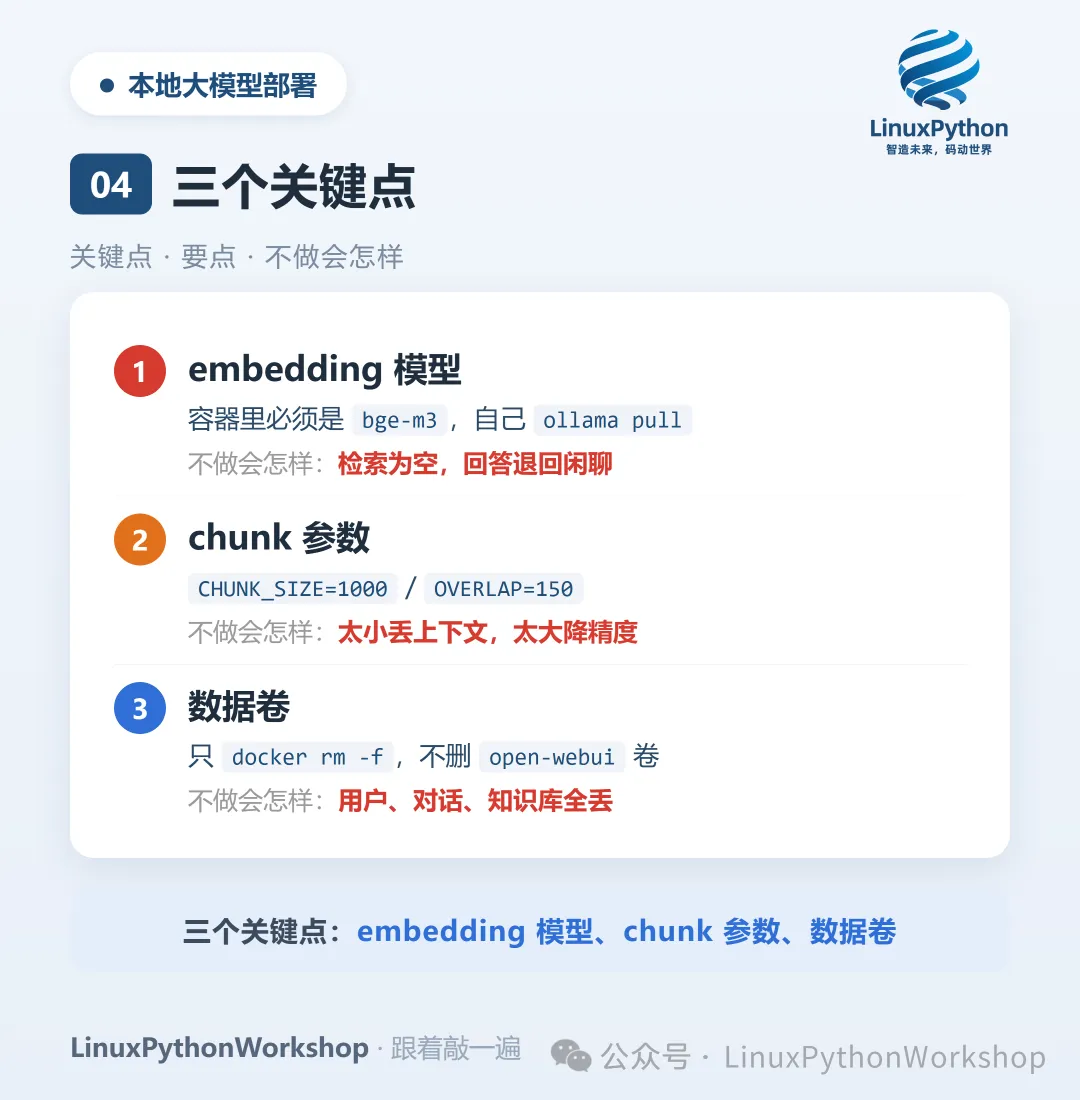
bge-m3,且已 ollama pull | ||
CHUNK_SIZE=1000OVERLAP=150 | ||
docker rm -f,不删 open-webui 卷 |
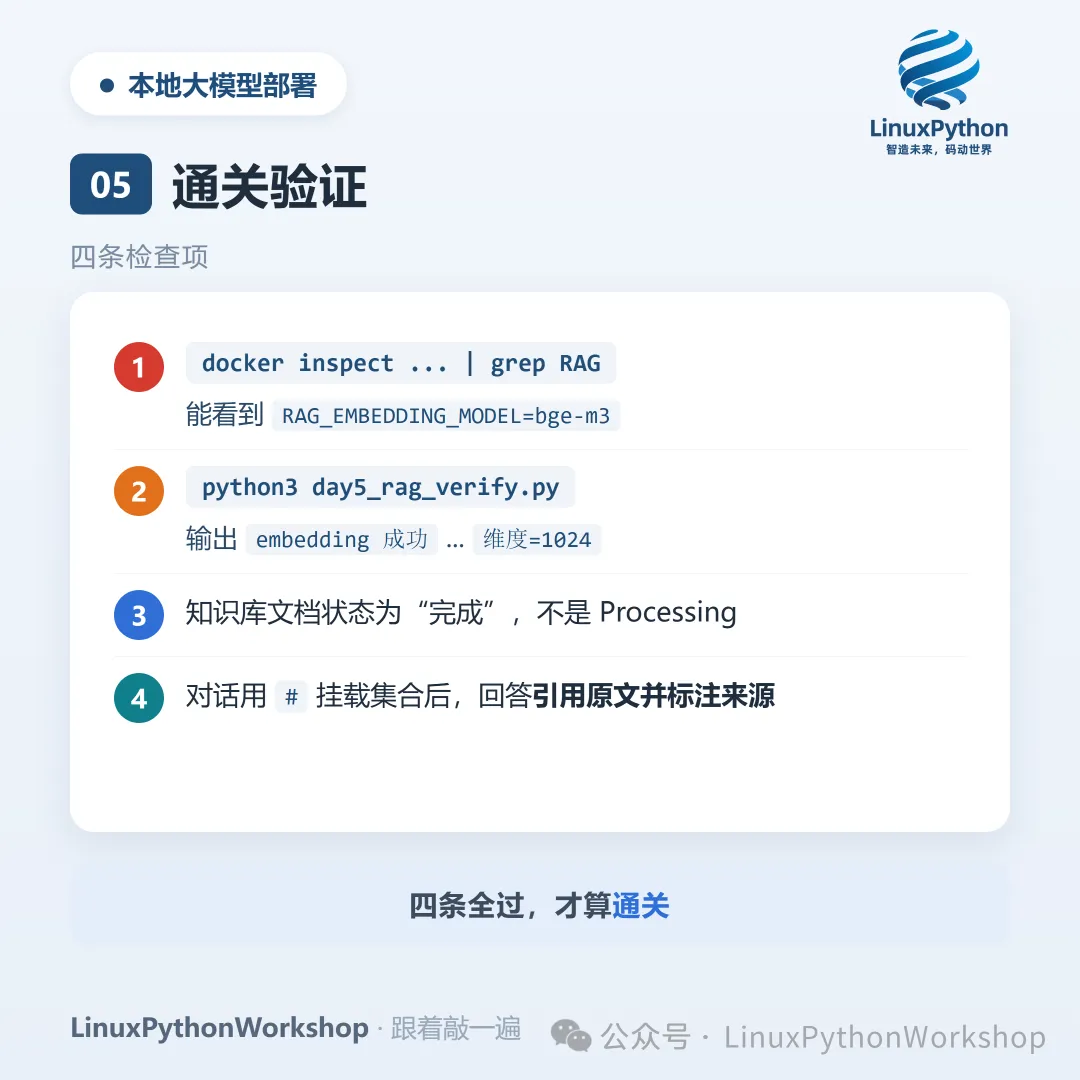
docker inspect ... | grep RAG能看到 RAG_EMBEDDING_MODEL=bge-m3python3 day5_rag_verify.py输出 embedding 成功 ... 维度=1024知识库文档状态为"完成",不是 Processing 对话用 #挂载集合后,回答引用原文并标注来源
# 集合 | # 选知识库 | |
ollama pull bge-m3 | ||
open-webui 卷 | ||
bge-m3 重建容器 |
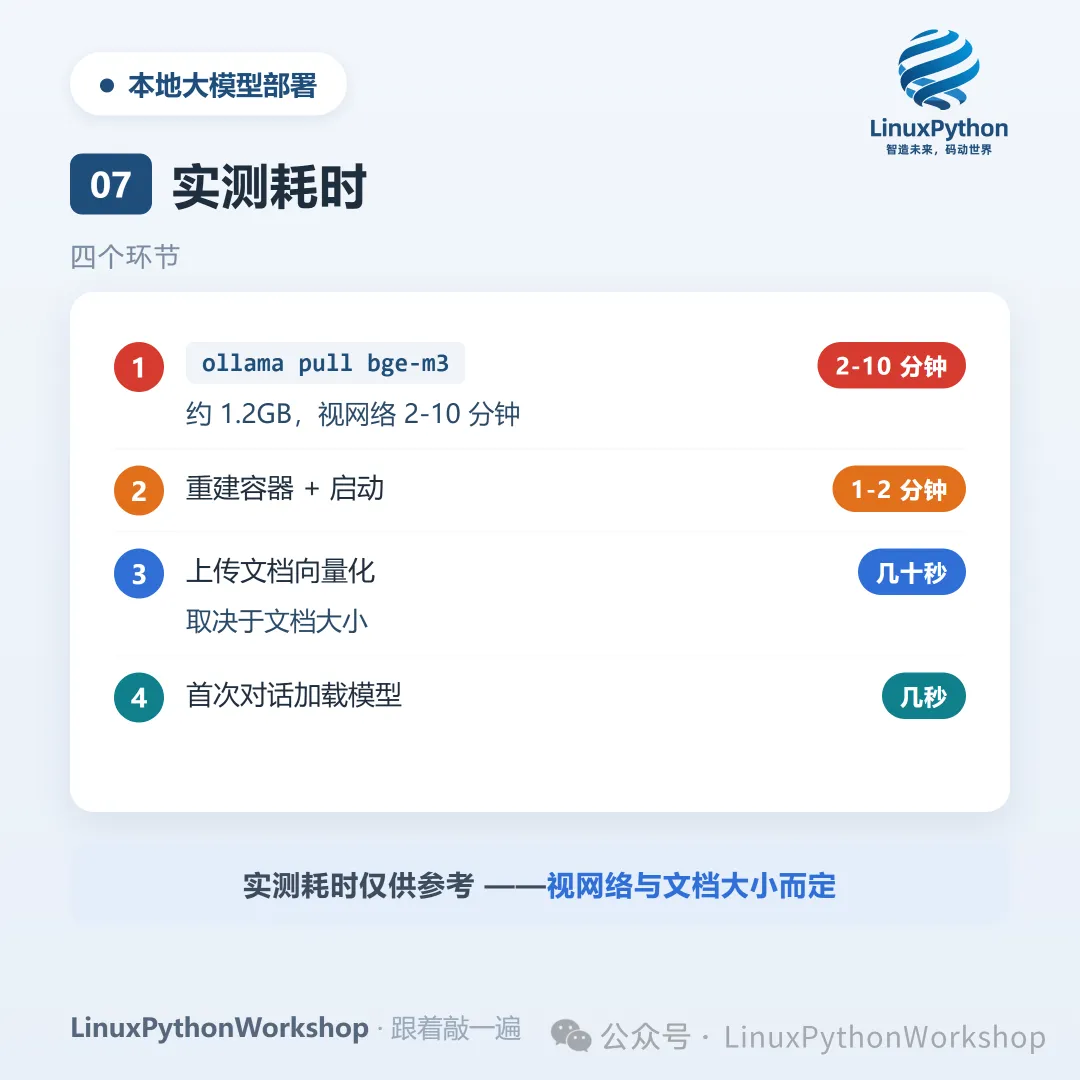
ollama pull bge-m3约 1.2GB,视网络 2-10 分钟 重建容器 + 启动:1-2 分钟 上传文档向量化:几十秒(取决于文档大小) 首次对话加载模型:几秒
本文正文为核心命令;完整脚本(110 行部署 + 131 行验证,含 bge-m3/nomic 回退、集合创建与检索校验)已上传网盘,与前四篇共用同一入口:
链接:https://pan.baidu.com/netdisk/share?surl=BOHEWiHa8UQXHR2g6RpJOg 提取码: ai25
一、选择题(每题4个选项)
1. RAG 里负责"把文档变成向量"的模型是?
A. qwen2.5:0.5b
B. bge-m3
C. nginx
D. keepalived
2. 对话时让模型检索知识库,需要输入什么符号?
A. @
B. #
C. /
D. $
3. 上传 PDF 后检索为空,最可能的原因是?
A. 文件太大
B. 扫描件没有文本层
C. 模型太小
D. 端口错误
4. 重建容器时,哪个操作会导致知识库丢失?
A. docker rm -f open-webui
B. docker volume rm open-webui
C. docker restart open-webui
D. docker stop open-webui
5. bge-m3 的向量维度是?
A. 256
B. 512
C. 1024
D. 2048
二、填空题(2 题)
1. 让 Open WebUI 用 Ollama 做向量化的环境变量是 RAG_EMBEDDING_ENGINE=________。
2. 中文检索效果差时,应把 embedding 模型从 nomic-embed-text 换成 __。
🎁 答对粉丝福利:
将答案按顺序发至评论区, 全部答对的前50位粉丝,将获得:
✅ 赠送完整的《21天工具链接实验手册 》
#RAG #OpenWebUI #bge-m3 #知识库 #AI工具链