ARTICLE · 1242804
AI地基篇:(八)tool use 协议
AI地基篇:(八)tool use 协议 AI地基篇第八篇:tool use 协议 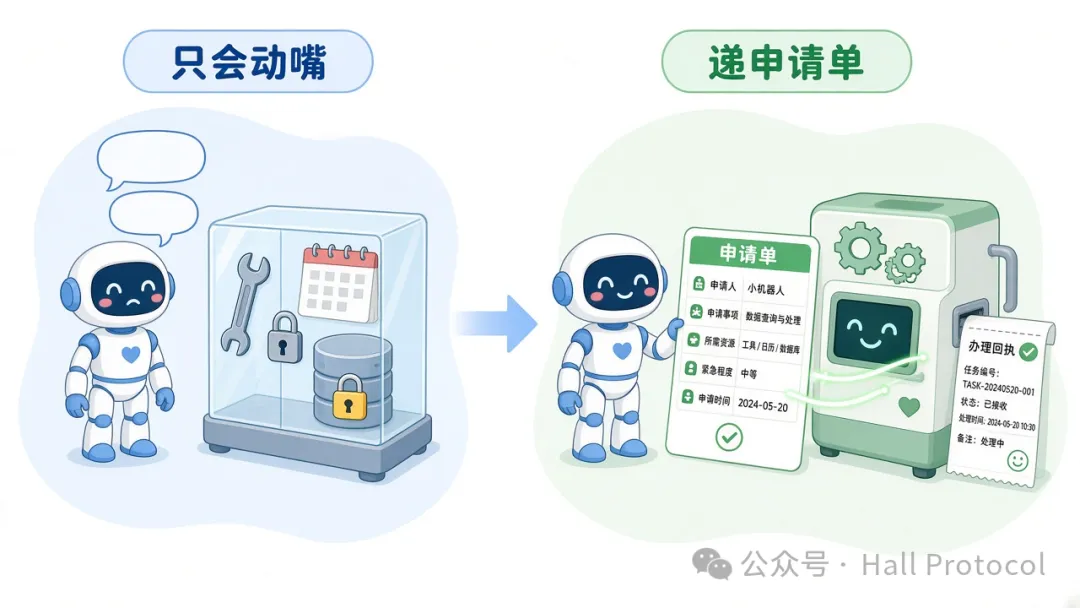
模型只递申请单,真正动手的从来是你的代码!!! 第七篇结尾留了个扣:进入 tool use(工具调用)之后,assistant 不再只吐自然语言,而是按 schema(规定表格每一格填什么、什么类型的格式说明)发起工具调用。这篇就来还这个扣。很多人听到「模型会调用工具」,脑子里浮现的是模型自己伸手按按钮、开数据库、跑命令。实际画面差得远:模型从头到尾只会一件事——接着写文本。它摸不到网络、碰不到文件,连一个真实的计算器都按不了。 tool use 协议做的事,是给「只会说的模型」配一套申请—回执制度:你想用工具,可以,别用嘴喊,填表。你的代码看到表,去执行,把结果作为回执塞回对话,再让模型接着写。这样一来,「会不会做」就被切成了两半:模型负责决定做什么、填什么参数;你的工程负责真的做。两边只靠那张申请单接头。AI 地基篇第八篇,只啃 tool use 协议。 第一篇讲 message 数组时留过一句:工具场景下还会有 tool 专用字段,留到 tool use 篇展开。现在兑现。前七篇里,数组里的戏份基本由三种角色分担:system(系统)、user(用户)、assistant(助手)。tool use 加了两样东西: assistant 消息里的 tool_calls 字段 → 申请单本体role 为 tool 的新消息 → 执行结果回执 一次完整的工具往返,数组会这样涨: 你:声明 tools(工具清单 + 说明书)user:今天北京多少度?assistant:不直接答,吐 tool_calls(工具调用申请)你的代码:真的去调天气接口tool:回执消息,装着执行结果assistant:拿到回执,写出最终回答 注意最后一行:拿到回执之后,还是要再请求一轮模型。模型不是「顺便」知道结果的,是下一轮读数组时才看到的。 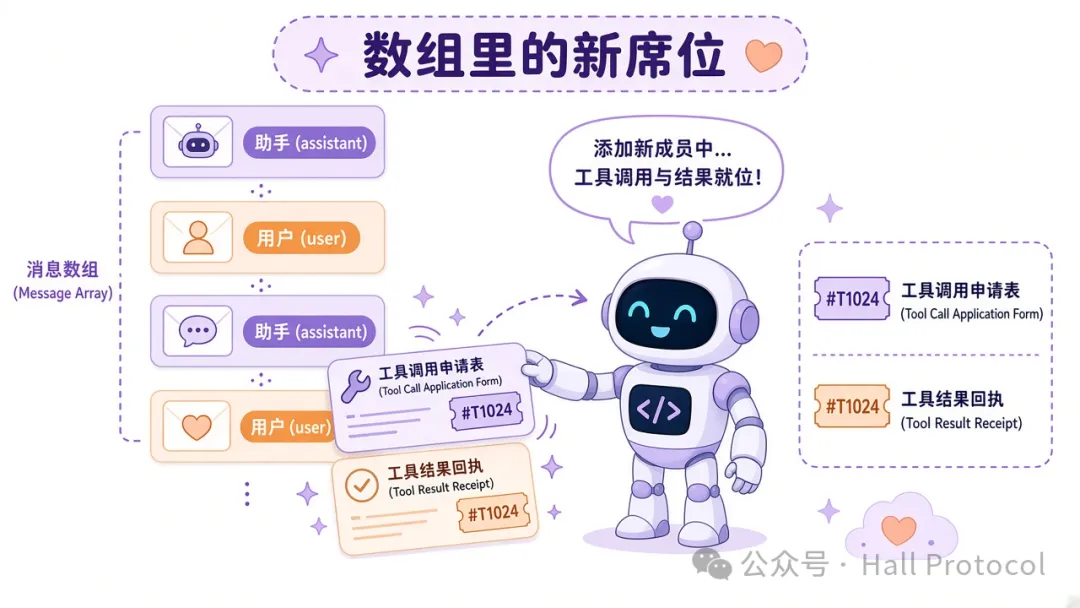
第二个常见误会:以为接工具是把一个可执行的东西「插」进模型。实际是:你在请求里带一个 tools 参数(工具清单),每个工具就是一张「表单模板」,常见长这样: name get_weatherdescription 查某城市当前天气,含温度parameters 按 JSON Schema 描述: city 是字符串,必填 unit 是枚举(摄氏/华氏),可选 JSON Schema(用 JSON 格式写的表格规定:每格叫什么、什么类型、必不必填)就是工具的参数说明书。要点在于:这一切都是文本。模型拿到的不是可执行的天气插件,而是几张写了字段和说明的表格。它「会用工具」,指的是它读得懂说明书、会照着填表。所以 description(工具用途描述)写得清不清楚,直接决定它选不选、选得对不对。这份描述本质上是写给模型看的提示词——和第三篇系统提示、第五篇 few-shot 范例是同一门手艺。还有一笔容易漏算的账:tools 清单每轮请求都要随数组一起送进去,说明书本身也占输入 token、也计费。工具堆得越多,这份固定开销越大——第二篇窗口的账,这里又要算了。 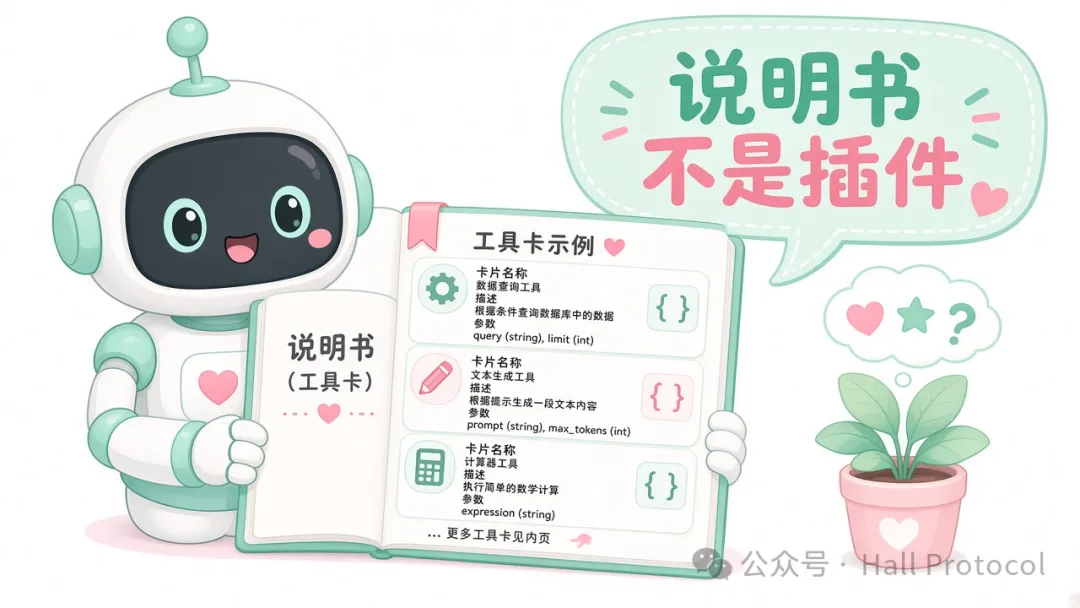
声明了工具之后,模型的回答方式多了一种选择:不写自然语言,改填申请单。assistant 消息里会多出一段结构化字段,常见叫 tool_calls(工具调用申请),里面三样东西: 工具名 get_weather参数 {"city": "北京", "unit": "摄氏"} ← 通常是 JSON 文本回执编号 id:call_001 三个硬要点: 这里正好接第七篇的问题:tool use 里 assistant 该在哪停? 答案是分两种。原生 tool_calls 模式下,引擎把申请单作为结构化字段单独切出来,字段边界就是天然刹车,不用你手工设 stop。而文本模板模式(自己约定「输出一段 JSON」或 ReAct 格式)下,分界要自己管:prefill 定好开头,stop 卡在闭合括号或下一个分界词前——第六篇加第七篇的那对旋钮,在这里正好派上用场。 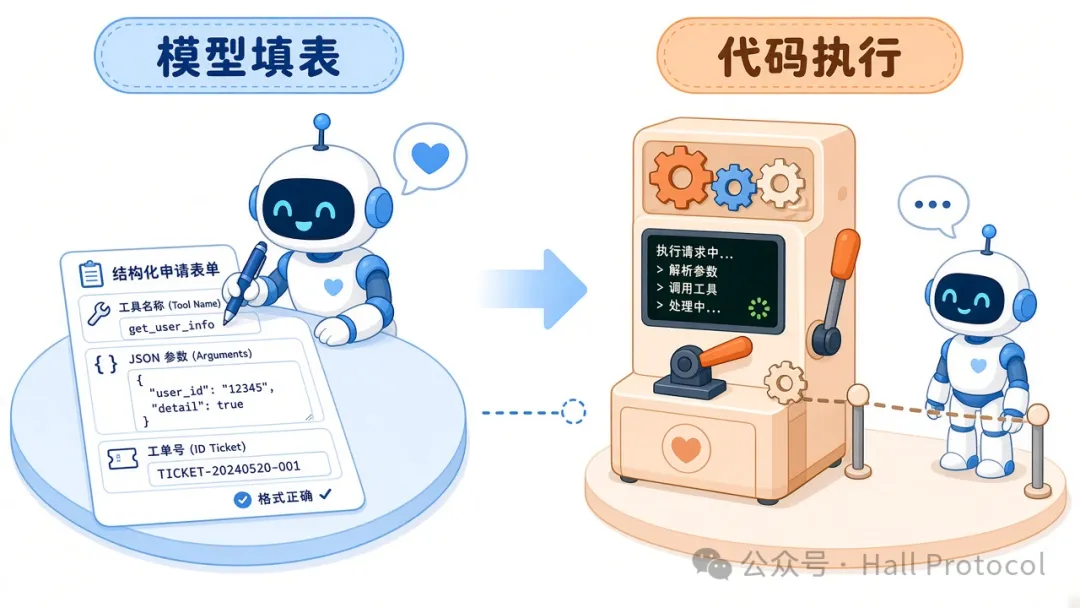
你的代码执行完,结果怎么给模型?不是「替模型回话」,而是往数组里新增一条 tool 角色的消息(有的实现放在 user 消息的专用块里,语义等价),带上对应的回执编号: role: tooltool_call_id: call_001content: {"temp_c": 14, "condition": "晴"} 配对是硬要求。申请单没回执、回执对不上编号、顺序错乱,下一轮请求大多直接报错——各家 API 对这套对账都校验得很严。回填之后,再请求一轮。模型读着更新后的数组,有三种走向: 又递一张申请单 → 继续循环(多步任务常态)给出最终回答 → 循环出口,任务完成卡住或跑偏 → 超时、步数上限、人工介入 这个「申请—执行—回执—再生成」的循环,就是后面 Agent 篇章里所有「模型动手干活」的骨架。所谓 Agent 用工具,底层都是这个循环在转。还有第二篇的老账:每一轮回执都留在数组里占窗口。网页全文、长日志、大查询结果直接塞回去,几轮就能把窗口吃满——截断、摘要、只回填需要的字段,是工程上必须做的事。 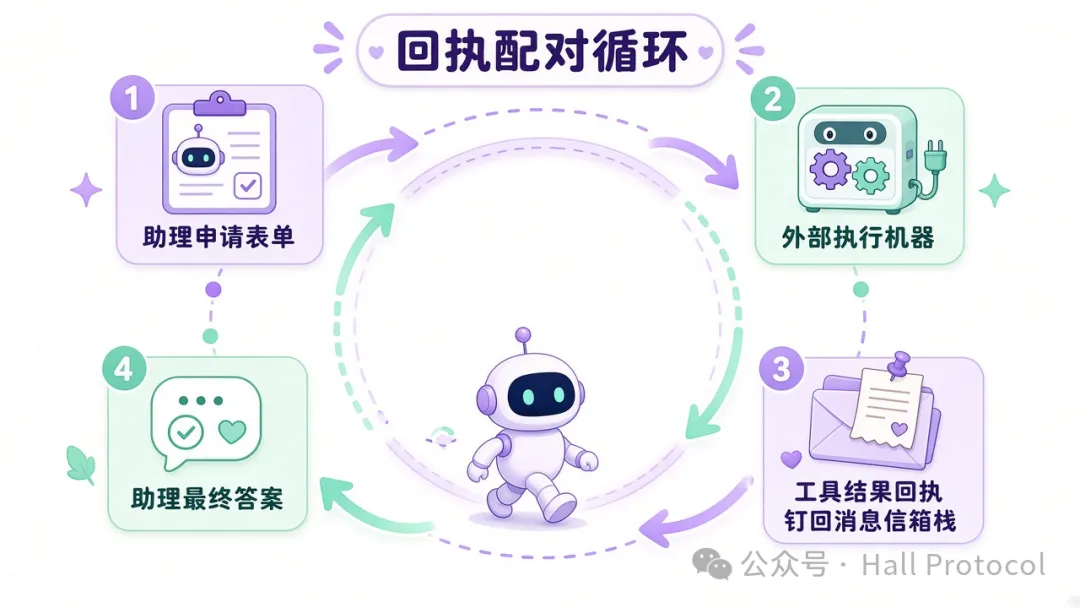
模型执行工具? → 它只填表工具越多越好? → 先写准三五个说明书随便写? → 它就是提示词参数直接用? → 先校验再执行拿到结果就完? → 回填再转一轮 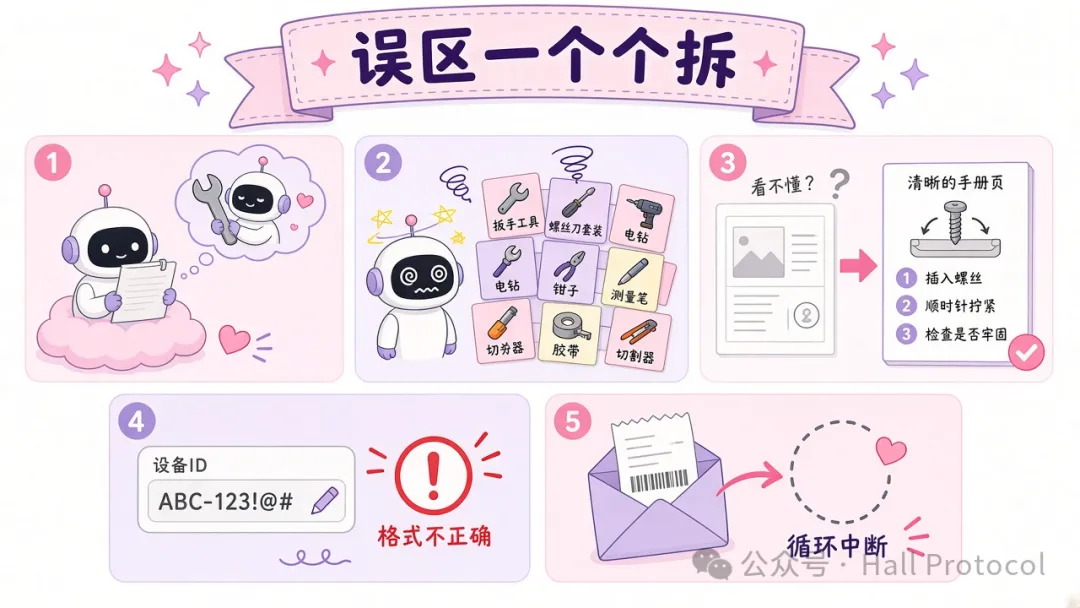
tool use 不是孤岛,它把前七篇几乎全用上了: message 数组 → tool 消息也是数组一员(兑现第一篇的扣)系统提示 → 工具使用的规矩写在哪一层few-shot → 说明书写作与范例同源prefill → 文本模式强制开头;原生模式有 tool_choice(指定用哪个工具的开关)stop → 文本模板模式下的手工分界上下文窗口 → 说明书与回执都占窗、都计费 第十篇 ReAct 会接上另一条线:在原生 tool_calls 协议出现之前,大家用纯文本约定 Thought、Action、Observation 来模拟这套循环——你会认出,那正是本篇协议的手写前身。自检接着上一篇往下编号: 写到最后 tool use 协议把「想」和「做」切开了:模型负责想——决定调什么、填什么参数;你的工程负责做——执行、校验、回填。中间那张申请单,就是两个世界的接口。所以别再问「模型会不会用工具」了,改问「我的说明书写清楚了没、我的循环闭好了没」。模型的智力在填表那一步已经给足了,剩下的都是工程活。下一篇是 RAG(检索增强生成,先去外部资料里找出相关内容、再拿找到的来回答):模型缺的往往不是动手能力,而是它没见过的资料。怎么检索、检索回来的内容以什么身份进数组——你会看到,检索器在工程上常常就注册成一个工具,本篇的循环直接复用。
你认同这样的表达,欢迎把文章转发给身边正在学习 AI 的朋友。愿每一次阅读,都不是信息的堆积,而是真正理解的开始。
01 承接前七篇:tool use 给 message 数组添了新席位
02 工具是怎么递给模型的:说明书,不是插件
03 模型吐回来的不是答案,是申请单
模型只填表,不执行。表递出来那一刻,它的工作就暂停了,球在你手上。 参数是它生成的文本,就可能编。城市名拼写错、枚举值瞎填、必填项漏掉,都真实发生,执行前要校验。 那个 id 是回执编号。回填结果时要对着它配对,下一节细说。
04 回填与循环:回执要对号,循环有出口
05 常见误区:五个,一个个拆
误区一:模型执行了工具它连网都摸不到。执行永远发生在你的代码里,模型只负责填申请单。安全边界因此清晰:能执行什么、能碰哪些路径,全是你的代码说了算。 误区二:工具越多越强清单越长,模型选择越难,描述越占窗,名字相近的工具还会互相干扰。先把三五个工具的说明书写准,比堆三十个有用。 误区三:说明书随便写description 是给模型看的提示词。写「查天气」和写「查某城市当前实时天气,不支持预报,传城市中文名」,调用质量天差地别。 误区四:参数照单全收参数是生成出来的文本,会幻觉。执行前按 JSON Schema 校验类型、枚举、必填,不过就打回去重填——把错误信息也作为回执填回去,模型自己会改。 误区五:拿到结果就当完事回执不 append(追加)回数组、不再请求一轮,你就拿着半截流水线当答案。循环没走完,任务就没闭环。
06 和前七篇对齐,然后自检
打印 assistant 原始响应,检查 tool_calls 的参数是不是合法 JSON 把某个工具的 description 写含糊,观察选错率;再写具体对比一次 数一轮多步任务里数组涨了多少条,说明书和回执各占多少 token