ARTICLE · 1244714
从「智能体写代码」到「软件工厂」:通往 L4 软件工程之路
从「智能体写代码」到「软件工厂」:通往 L4 软件工程之路
#AI编程 #软件工程 #AI智能体 #软件工厂 #LLM #研发效能 #自动驾驶分级
最近,Qodo 联合创始人兼 CEO Itamar Friedman(@itamar_mar)发布了一篇在开发者社区引发热议的长文《The Path to L4 Software Engineering》(通往 L4 软件工程之路)。他的核心观点非常犀利:当智能体(Agent)覆盖了软件开发生命周期的各个阶段,我们离真正的"软件工厂"还差得很远——而这段距离,恰恰是工程团队未来最重要的护城河。
这条推文的原话是:
"覆盖 SDLC 各环节的智能体,是迈向软件工厂的一步。但更难的工作,是工程化构建智能体周围的整个系统。这是我对通往'有边界的 L4 软件工程'之路的看法,以及为什么工程团队需要构建并拥有那个系统。"
文章观点切中当下 AI 编程热潮的盲区:大家在比拼谁家的 Agent 能写更多代码,却很少有人认真思考"系统"本身。下面我们来拆解这篇文章的核心内容。
一、Agentic SDLC ≠ 软件工厂
一个智能体可以写代码、跑测试、回应评审意见、提交 PR——而此时工程师正在做别的事情。把多个这样的智能体连接起来,似乎就能覆盖软件开发生命周期(SDLC)的大部分环节:规划变成智能体的活,实现变成智能体的活,评审和测试也变成智能体的活。
这在 Itamar 看来是一个"有意义的改变",但他提醒:我们正太快地从"智能体参与 SDLC 各阶段"滑向"我们有了软件工厂"的结论。
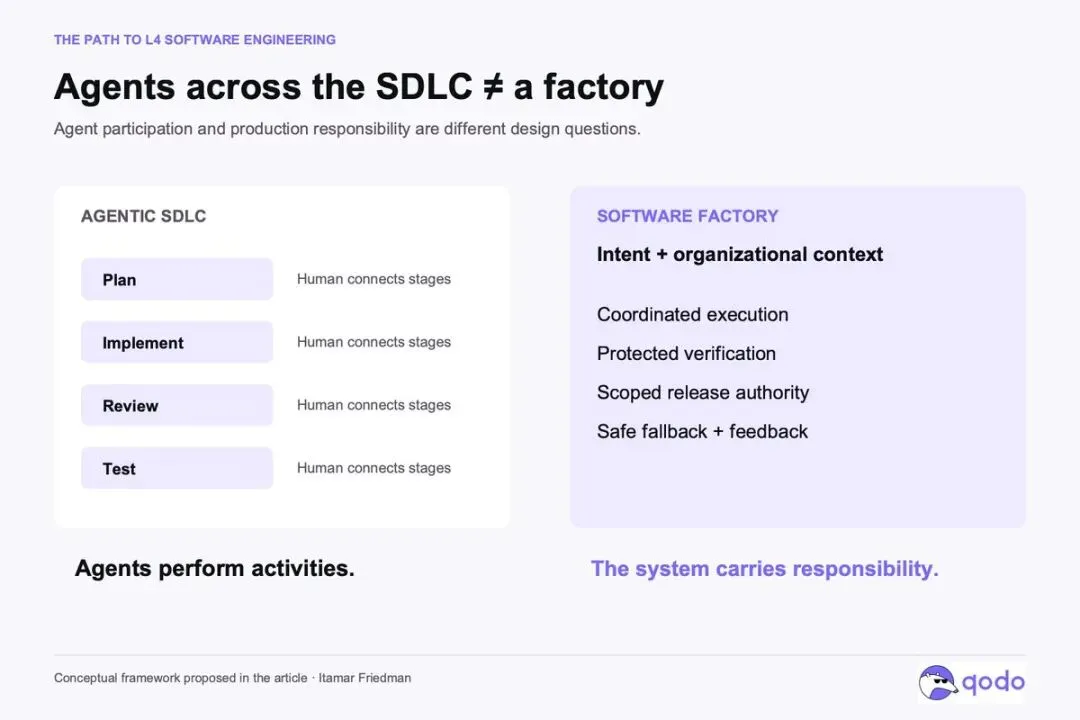
这两者之间的差别在于"责任":
- Agentic SDLC 描述的是"参与"
:每个阶段都有智能体干活,但人类仍然是串联各阶段、解决疑难判断的依赖——澄清需求、纠正计划、解读失败的测试、确认下游依赖、决定变更是否就绪。 - 软件工厂定义的是"责任"
:它是围绕这项工作的生产系统——输入、上下文、执行环境、验证、权限、交付机制和反馈闭环。工厂可以在不同的自主度下运行,关键是系统能否在"授权的生命周期"内独立承载一类变更。
Stripe 的 Minions 项目是一个很好的例子:无人值守的智能体把任务从实现、CI 一路带到"等待人类评审"的 PR。这是相当可观的自动化,但人类评审被明确保留——它仍处于"参与"层面,而非工厂层面的自主。
二、为什么"工厂"才是正确的改进单元
实现速度变快了,交付却未必变好。如果生成一个变更只要几分钟,而理解它的后果需要几个小时,那只是加速了一条长链路中的一环。剩下的工作——决定该改什么、守住架构约束、检查下游影响、确认对用户是否有效——都还在原处。
工厂化思维让这条更大的链路变成可以被刻意工程化的对象:需求如何变成可执行的检查、组织知识如何抵达正确的智能体、变更如何被验证、失败如何转化为下一次运行的教训。对系统的一次改进,可以惠及未来成千上万次变更。
这也解释了为什么 OpenAI 的 harness engineering(工具链工程)报告中,工程师们把精力投入到编码智能体周边的环境、仓库知识、架构约束和反馈回路上——工程投入的复利位置发生了转移。
Itamar 给出的优先级非常明确:System > Agents > LLMs。模型能力重要,智能体设计重要,但系统决定了这些能力接到什么样的活、能用什么信息、能采取什么动作、以及在输出进入生产前需要什么证据。更强的模型可以让系统更好,但它自己决定不了组织能接受的风险。
三、借鉴自动驾驶:L0 到 L5 的软件工程分级
文章借用了自动驾驶的 SAE 分级来定义软件工程的自主度(这是作者提出的概念框架,并非行业标准):
最关键的区分是 L3 与 L4 的分界线:
- L3
:运行遇到失败 → 必须由人来解读和处置 → 然后才能遏制或恢复。失败的遏制依赖人类的及时介入。 - L4
:运行遇到失败 → 系统先安全地停止/隔离/恢复 → 然后才上升给人类判断。人类帮助可以来得晚,但失败的遏制不能依赖有人立刻接管。
这就是"L4 不等于无所不能"的含义——运行边界本身就是 L4 能力的一部分。一个团队可以针对"成熟内部服务的例行变更"追求 L4,同时对"支付授权核心的变更"保持紧密的人工控制。把整个组织笼统地称为"L4",恰恰掩盖了真正重要的区别。
四、最难的一步:工程化"边界"
从 Agentic SDLC 走向 L4,需要明确回答:什么条件下才允许自主执行?
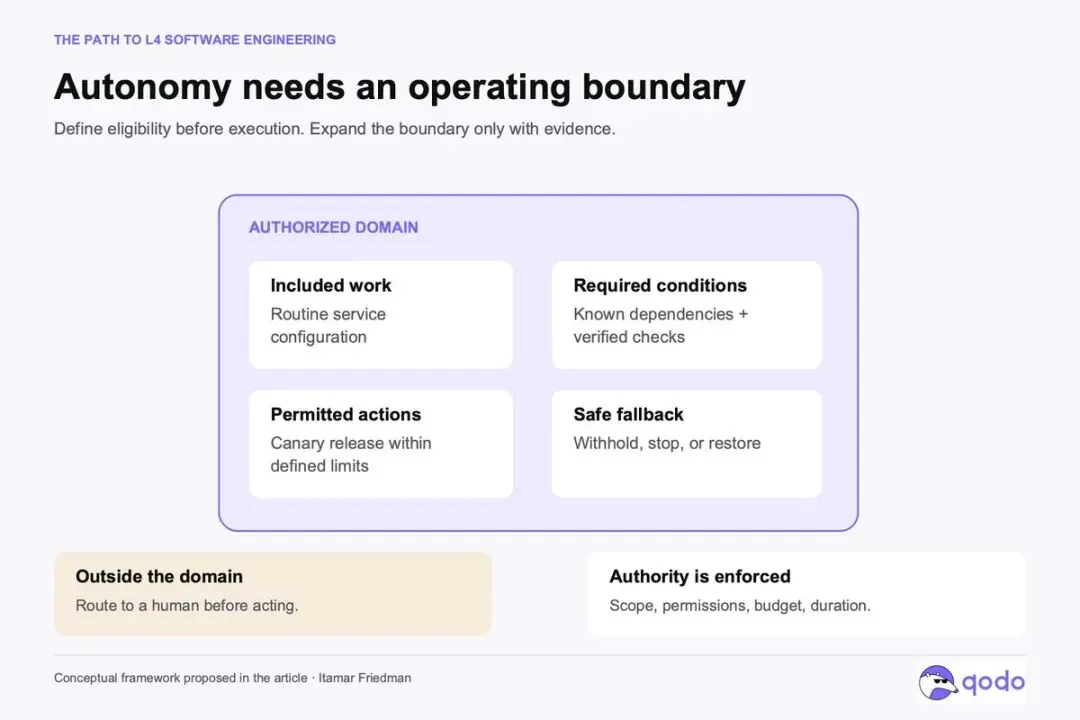
首先是圈定授权域:哪些仓库、变更类型、依赖、环境被纳入?适用什么权限和支出上限?什么任务不具资格?例行依赖升级和核心授权模型的变更,不应该仅仅因为"同一个智能体都能尝试"就继承同样的权限。
其次是把成功定义成系统可评估的形式。一张工单很少是完整的规格说明——相关需求可能藏在架构决策、事故历史、客户承诺甚至工程师的记忆里。工厂需要能访问这些上下文,并在实现把"假设"变成"行为"之前暴露歧义。
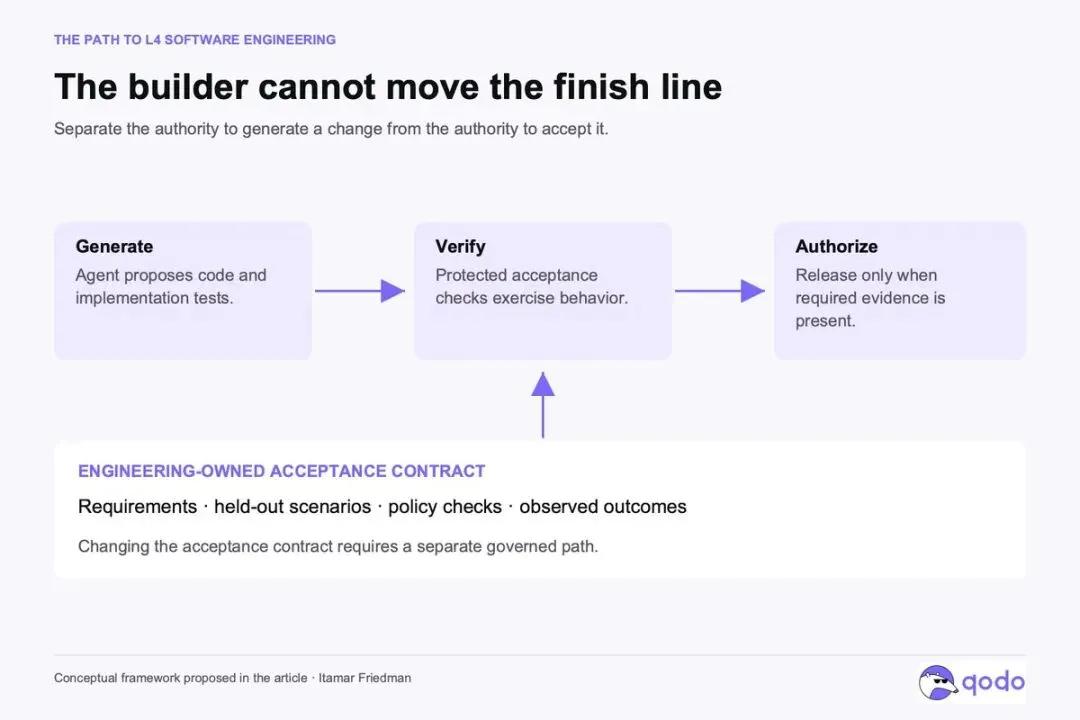
再者是独立验证。StrongDM 的软件工厂实践提出了两条挑衅性的规则:"代码不得由人类编写"、"代码不得由人类评审"。但更有启发的是规则背后的机器:代码库之外的场景库、验证工具链、外部依赖的行为副本——为的是不给智能体"应付测试而不交付预期行为"的机会。
核心原则是:产出变更的智能体,不能悄悄重新定义这个变更通过验收的条件。 给第二个智能体安上"评审员"的头衔并不构成独立性——两个智能体可能共享同一个错误假设。Anthropic 关于生成器与评估器工具链的研究也表明:分离评估有帮助,但评估器本身仍需要校准、仍有局限。验证本身就是一个需要被评估的工程系统。
还有一个值得警惕的挑战(来自 Dex Horthy 的 "Harness Engineering is not Enough"):短期任务通过率和代码库长期可维护性是两个不同的目标。今天的绿色测试,并不能证明工厂在保护系统"明天的可变更性"。架构与程序设计需要显式约束,且 successive 变更的累积效应需要长期观察。
五、证据 > 自信声明
L4 类比中最有价值的部分是:当一次运行出错时,工厂靠什么自保?
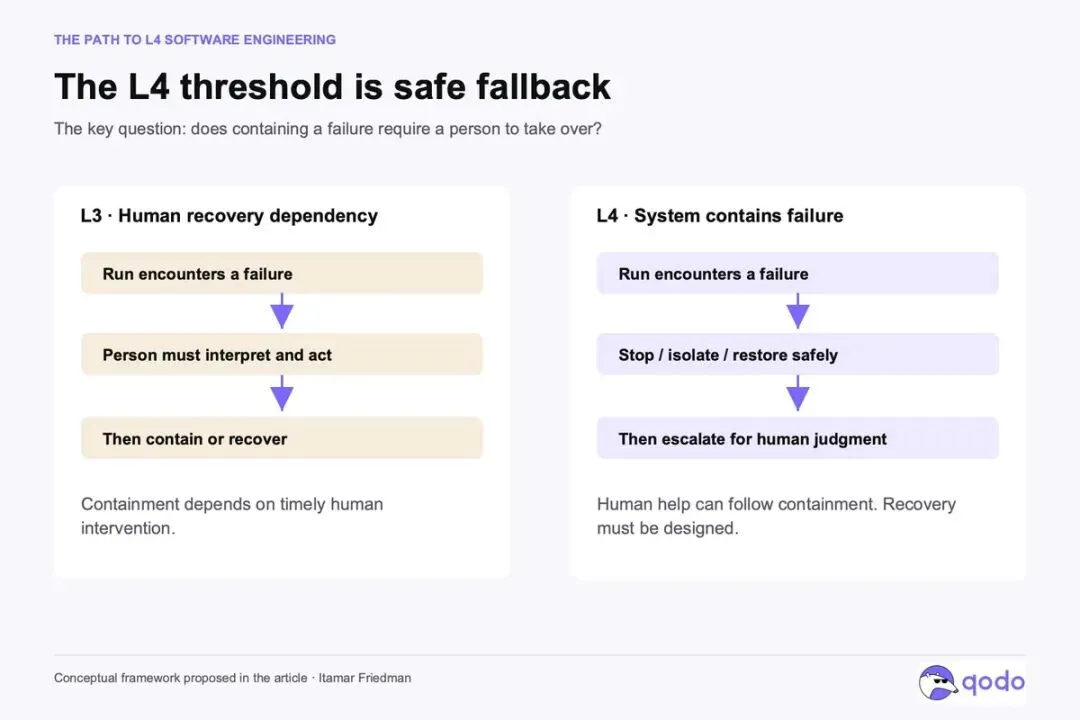
工厂应该为每个放行的变更产出一份可检视的账目:它响应的需求、通过的检查、适用的约束、部署结果、未解决的不确定性。这些证据有的来自确定性检查,有的来自仿真、对抗测试、模型辅助评审和生产观测——没有任何单项能普遍证明正确性,但组合起来足以支撑"特定边界内的特定决策"。
这套纪律同样适用于对工厂自身的宣传:智能体数量、生成代码行数、无人值守运行时长,这些只是"活动量"。真正该问的是:合格任务一次通过率多高?还剩多少人工投入?多少问题逃过了验证?失败付出了什么代价?被拒任务和紧急人工干预都应该记入这本账。
安全回退可能是:暂缓发布、叫停上线、下线功能、回滚版本。注意回滚并非总是可用——破坏性的数据库迁移可能让回滚变得不可能,运行边界必须在工厂启动前就把这一点考虑进去。系统能在到达安全状态后再向人类求助,这才是有意义的 L4。
这是一个比"让智能体通宵干活" demanding 得多的标准。
六、所有权 > 实现
如果这是方向,那么结论就是:工程团队需要拥有自己的软件工厂。
这里的"拥有"指的是控制那些决定"工厂产出什么、产出何时算合格"的决策:组织上下文、架构、验收标准、权限、证据、运行边界——以及诊断失败并改进产生失败的系统的能力。
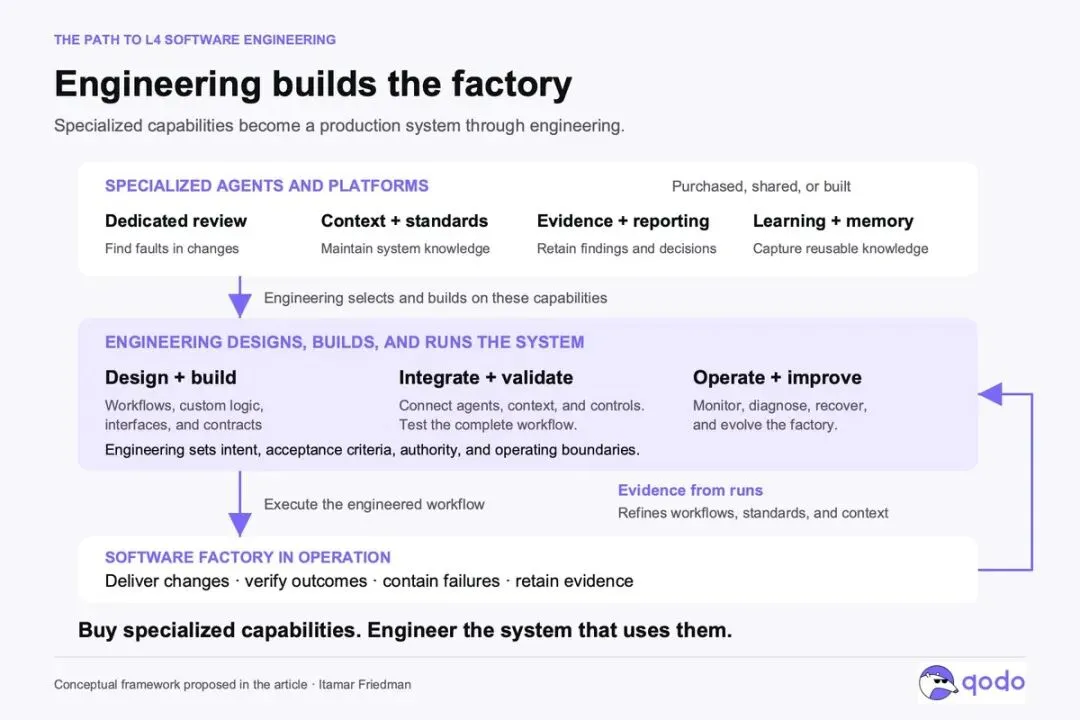
一个务实的工厂会组合自建工作流与外部专业能力。购买专门的代码评审智能体、维护上下文的平台、沉淀证据的基础设施,都是合理选择——就像购买云服务后,工程师仍然负责设计架构、连接组件、编写应用逻辑和运维结果一样。购买的是积木,工厂本身必须由团队来搭建和运营。
工程组织需要:设计并实现连接这些能力的工作流、供给上下文、把发现转化为行动;测试完整系统;为每一步定义证据与权限;建设监控与恢复机制。产品团队贡献领域知识与结果责任,平台与安全团队提供共享基础设施与管控。
这与 Kief Morris 在 Martin Fowler 站点上提出的 "on the loop"(人在环上而非环中)一脉相承:工程师改进的是产生工作的机制。失败发生时,修掉眼前的变更只是工作的一部分,更深的机会是改进上下文、约束、验证或工作流,让未来的运行表现更好。
反复出现的人工判断,应该尽可能变成规则、测试或持久化的上下文。 如果同一条架构纠正每次运行都要人工重复,说明工厂还没有吸收团队已知的经验。这些知识是战略资产——它记录了组织如何构建软件、从失败中学到了什么、愿意在哪些环节授权。当智能体接管越来越多的实现工作,对这些知识的所有权就愈发重要。
七、落地建议:构建"有边界的 L4"
文章最后给出了务实的行动路径:
- 从一类有价值的工作开始
,其需求与风险已被充分理解; - 定义资格规则、建立验证、约束权限、设计回退
; - 在人类监督下运行
,并测量人们在哪些环节仍需介入; - 把每次人工干预当作证据
——它要么指向缺失的能力(补工具、补上下文),要么证明该工作暂时不该进入自主运行; - 凭已证明的表现逐步扩大边界
,在后果严重或不确定性高的地方保留更窄的限制。
每家公司的系统、义务和对失败的容忍度不同,边界划在哪里必然不同。正因如此,Itamar 主张以"有边界的 L4"而非"投机性的 L5"作为实践目标:它给工程团队一个具体的系统去构建,也给了评价这个系统的具体标准。
Agentic SDLC 让生命周期中更多的环节可以被智能体执行;软件工厂则把这些能力组织成一个有明确授权、证据与恢复机制的生产系统。工程团队的战略机会,在于拥有并持续改进这个系统——未来的竞争优势,将越来越取决于它把意图转化为软件的可靠程度,以及每一次结果能在多大程度上改进下一次运行。
参考链接(原文与引用)
原推文:https://x.com/itamar_mar/status/2113255396299128887 长文《The Path to L4 Software Engineering》:https://x.com/i/article/2112960939901480961 OpenAI《Harness Engineering》:https://openai.com/index/harness-engineering/ Stripe《Minions》:https://stripe.dev/blog/minions-stripes-one-shot-end-to-end-coding-agents Dan Shapiro《The Five Levels》:https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/ SAE J3016 自动驾驶分级标准:https://saemobilus.sae.org/standards/j3016_202609-taxonomy-definitions-terms-related-driving-automation-systems-road-motor-vehicles StrongDM 软件工厂:https://factory.strongdm.ai/ Anthropic《Harness Design for Long-Running Apps》:https://www.anthropic.com/engineering/harness-design-long-running-apps Dex Horthy《Harness Engineering is not Enough》:https://www.youtube.com/watch?v=Ib5GBkD555M Kief Morris《Humans and Agents》:https://martinfowler.com/articles/exploring-gen-ai/humans-and-agents.html