ARTICLE · 1245249
让 AI 连改 10 个文件,第一个就错了——Claude Code 真实工作流实战
我回了句:会用工具和会用工具干活,中间隔着一套工作流。
这就是这一篇要聊的:把 Claude Code 放进真实的开发场景,新功能、修 Bug、重构、审查,每一步该怎么配合、谁负责什么、哪里必须亲手把关。工具是前三篇的事,这篇是心法。
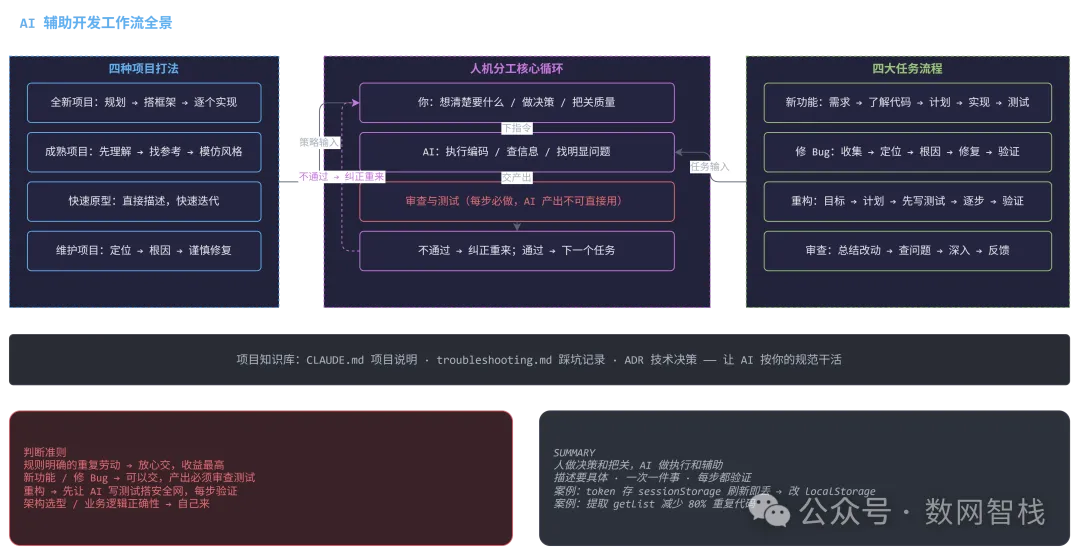
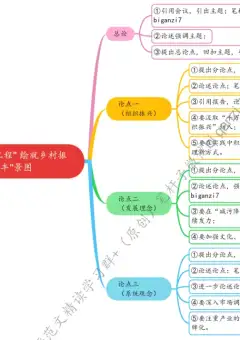
图1:左边四种项目打法,中间人机分工的循环,右边四大任务的流程骨架。
一、先认清 AI 的能力边界
跟 AI 协作效率上不去的头号原因,不是它不够强,是你对它的预期错了。
它擅长什么?有明确规则、能自动化的活:按描述生成代码框架、几秒扫完几千行代码找到你要的部分、发现语法错误和常见安全漏洞、批量重命名、格式化、补文档注释。这类活交给它,又快又稳。
它不擅长什么?你的业务逻辑——你不说,它不知道公司订单流程怎么走;技术选型和架构权衡——这需要你的经验和对项目的理解;团队的暗规矩——"所有 API 都要加日志""错误码必须用枚举",它不知道,除非你写进 CLAUDE.md 或者明确告诉它。最要紧的一条:它生成的代码不能直接用,必须审查和测试。它可能写出看起来对、跑起来错的东西,也可能漏掉边界情况。
认清边界之后,分工就顺了:你想清楚要做什么、做决策、把关质量;它执行编码、查信息、找明显问题。就像带一个初级开发者——你交代任务,他去实现,你审查。区别是它快得多,判断力也弱得多。
二、四种项目,四种打法
不同项目用 AI 的策略完全不一样,用错打法是最常见的翻车点。
全新项目:没有历史包袱,重点是先把规矩立好。分三步:让它推荐技术栈、设计目录结构、规划数据库表;再让它搭基础框架和配置文件;最后按优先级逐个实现功能。关键是一开始就定好代码规范,每完成一个模块立刻测试,文档跟上。
成熟项目:代码量大、有既定风格,重点是"先理解再动手"。加新功能前,先让它分析项目结构、找到相关代码、看看类似功能怎么实现的;再找参考实现;最后模仿现有风格来做。硬规则只有一条:保持代码风格一致,别让 AI 自由发挥。
快速原型:追求速度,不在意质量。直接一句话描述需求("做个待办应用,能增删改、本地存储、能用就行"),然后快速迭代:"加个搜索功能""改成深色主题"。原型验证成功后再考虑重构。
维护项目:修 Bug 为主,改动要谨慎。流程是定位问题(贴上报错信息和复现路径)→ 分析根因 → 实施修复并加防御性代码 → 充分测试。修复一处,顺手把类似问题也检查一遍。
三、四大高频任务的标准流程
新功能开发,五步走。第一步理解需求是你自己的事:输入输出、边界条件、性能安全要求,想清楚。第二步让 AI 了解现有代码。第三步和它一起定计划,让它帮你查漏补缺。第四步 AI 生成、你审查。第五步测试验证是你自己的事——主流程、边界情况(空内容、超长内容)、权限控制(不能删别人的评论),自动化测试可以交给它写。
修 Bug,五步走,给足上下文。收集信息(报错、复现步骤、出现时间、影响范围)→ 贴给它定位 → 一起分析根因 → 它修复你审查 → 你按原步骤复现验证。一个真实案例:用户登录后刷新页面就退出,AI 检查后发现 token 存在 sessionStorage 里,刷新即清空,改成 localStorage 解决。你自己排查可能要一下午,它两轮对话就定位了——前提是你把"刷新后退出"这个现象和代码位置讲清楚了。
重构,最忌讳直接动手。五步里最重要的一步:先写测试,搭安全网。三个函数 getUserList、getArticleList、getCommentList 重复度很高,都是分页排序筛选。让 AI 分析重复部分、提方案(提取通用 getList 函数,差异部分参数化),然后先写测试用例,再逐步重构,每步验证,最后跑全量测试。这个案例里重复代码减少了 80%。
代码审查,AI 查常规,你查业务。让它总结 PR 改动、查四类问题(安全、性能、明显 Bug、风格);你自己负责业务逻辑、边界情况、实现方式是否更优。它有它的强项:XSS、SQL 注入、N+1 查询、200 行的巨型函数,这些它扫得又快又全。但"这个业务逻辑对不对",只有你知道。
四、给项目建个知识库
前面说的"它不知道你的业务",解法就在这里。三样东西,成本很低,收益持续:
CLAUDE.md(或 AGENTS.md),项目说明书:技术栈、目录结构、代码规范、开发流程、常用命令、注意事项(API 必须加错误处理、用户输入必须转义、SQL 必须参数化)、数据库表结构。每次启动它都会读,等于给新来的 AI 发了入职手册。
docs/troubleshooting.md,踩坑记录:npm install 失败是 Node 版本问题、数据库连不上是环境变量没配、刷新退出是 sessionStorage 的锅。每解决一个问题记一笔,下次它自己会查。
docs/decisions/ 目录,技术决策记录(ADR):为什么选 PostgreSQL 而不是 MySQL、理由和后果都写下来。三个月后有人问"当初为什么这么选",让 AI 去翻这个目录,比翻聊天记录靠谱。
五、六个协作技巧,从翻车现场总结的
描述要具体。"这个功能有问题,帮我优化一下"是废话;"点击提交按钮后表单没提交,控制台报 Cannot read property 'value' of null,错误在 form.js 第 23 行,另外列表有 1000 条数据加载慢,请加分页,每页 20 条"才是能干活的需求。错误信息、期望结果、上下文,三件套。
一次只做一件事。"帮我实现登录、注册、找回密码、个人中心、修改密码、邮箱验证"这种一句话要六个功能的,必然翻车。拆开:先登录,测试通过,再注册,以此类推。
及时验证。让它连续改 10 个文件,最后发现第一个就错了——这就是开头朋友的教训。改一个文件,立刻测试,没问题再继续。小步快跑,对 AI 的输出保持"每步都要验"的怀疑。
善用上下文。"按照刚才的方案实现""参考 getUserList 函数的风格"——它在会话内是有记忆的,别浪费;贴现有代码给它做风格参照;一句话交代项目背景("电商项目,React + Node.js,已有用户和商品系统,现在加购物车")。
保存有用的对话。解决一个复杂问题(比如 N+1 查询,JOIN 改造后查询从 2000ms 降到 50ms),把方案写进 docs/solutions/。一次解决,终身受益,团队共享。
学会提问。三个高价值问法:问"为什么"(为什么这段代码会内存泄漏)、要多个方案(认证有哪几种实现,各有什么优缺点)、要解释(这个算法怎么工作的)。问得多,你成长得比它快。
六、两个必须想清楚的问题
AI 生成的代码能直接用吗?不能。它可能有逻辑错误、边界处理不当、不合规范、安全隐患、性能缺陷。你必须读、必须懂、必须测。这是底线,没有例外。
怎么避免过度依赖?保持学习。理解它生成的代码而不是盲目复制,遇到不懂的概念主动学,定期复习基础,先自己尝试解决再用 AI 验证。它是工具,不是替代品——这句话老套,但翻车的人都是忘了它。
七、该不该把活交给它:一张决策表
最后一句话:前三篇讲的都是给 Claude 加能力——命令、外接、技能包。这一篇讲的是给自己加能力:一套知道什么时候放、什么时候收的工作流。会用工具的人很多,会用工具干活的人不多,差的就是这个。