ARTICLE · 1269656
AI 变化检测 2026:从 TGS-Net 到开放词汇检测
变化检测的老问题
10-11 那篇讲过:两期影像一对比,差值超过阈值就是变化。传统方法的痛点很实在——伪变化:光照变了、阴影移动、季节物候、辐射偏移,都会制造假差异,阈值调高漏检、调低误报,怎么调都别扭。
2026 年论文在解决什么
第一,伪变化识别。 遥感学报 2026 年刊出的《面向高分辨率遥感影像变化检测的可信差异筛选与结构细化方法》(TGS-Net)直接对着这个问题打:以 ChangerEx 双输入编码-解码为框架,加一层可信差异筛选,把光照、阴影、物候、辐射引起的伪差异在特征层面筛掉;再配合结构细化,修复建筑边界、小目标、狭长区域的破碎问题。核心思路:不是提高阈值,而是让网络学会「哪些差异可信」。
第二,开放词汇检测。 arXiv 2026 年 8 月的 Zero-OVCD 做了一件以前要标数据的事:不预先定义变化类别,模型自己「看懂」变了什么。在 LEVIR-CD、WHU-CD 上 F1 达到 88.65% 和 88.85%,比同批监督方法高。意义在于:训练数据不必为每个区域重新标注「变化类型」。
第三,轻量化与工程化。 遥感学报的《联合遥感影像配准与变化检测的轻量级网络》把「配准」和「检测」放进一个网络——以前两期影像没对齐是检测失败的头号原因,现在一起优化;武汉大学学报基于武汉一号卫星影像的智能变化检测,覆盖建筑、交通、水体、耕地、绿地 5 类典型变化,平均精度比次优方法提升 6.8%。国内业务卫星+深度学习的组合,已经从论文走向了型号应用。
一个框架图记住 2026 的进展
怎么评估一个变化检测模型
落到「该不该用」之前,先看三组指标:
- F1 / IoU
检出区域和真实变化区域的重合度。Zero-OVCD 报的 88.65% F1 就是在 LEVIR-CD 上按 IoU 阈值算的 - 漏检 vs 虚检
漏检(真实变化没标出)在违建、灾损场景不可接受;虚检(没变化说成有变化)在地籍场景麻烦。多数网络在两者间折中,看你的业务偏向哪头 - 类别粒度
只报「变了」还是能报「变了什么」(建筑变绿地)。开放词汇模型能报类别,但类别错误率目前高于二分类——先用二分类看位置,再人工定类别,比直接信类别稳
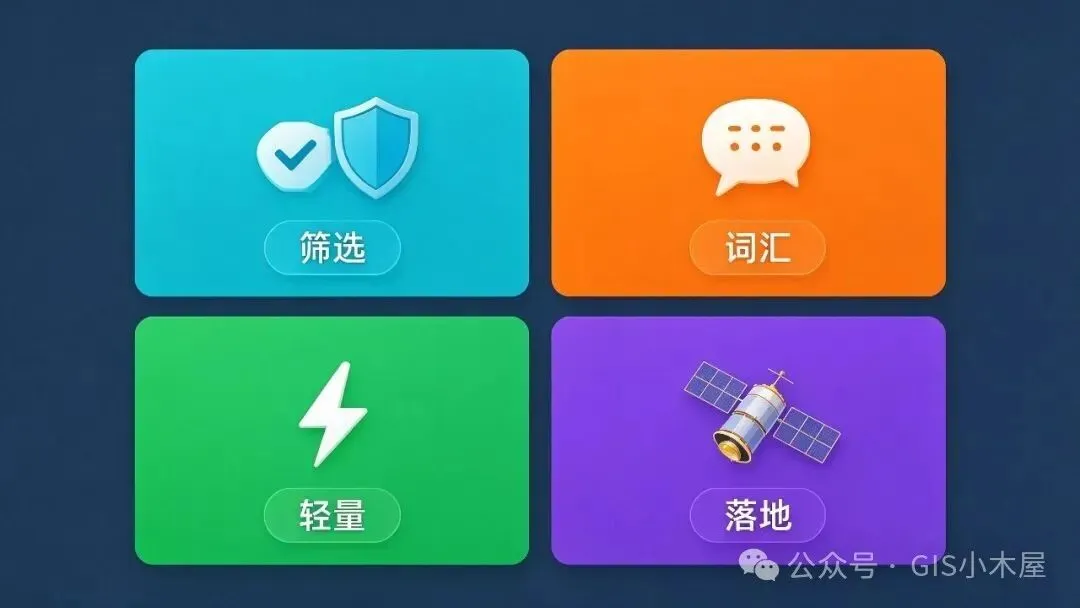
2026 年变化检测四条线:可信筛选、开放词汇、轻量网络、业务卫星落地
从业者能落地什么
第一步:传统工具先兜底。 小范围、单时相差异明显的场景,10-11 那篇的差值法+转移矩阵仍然够用,成本最低。
第二步:用开源模型跑初稿。 变化检测的开源模型(基于 ChangerEx、Siam 系列的权重)能直接跑两期影像,输出变化图斑;显存 8GB 可推理。跑出来当初稿,人工修边界和误检。
第三步:别急着标注训练。 除非业务区域差异类型特殊(比如只关心违建),否则先评估开源模型表现;模型效果够就微调收敛,不够再考虑自建数据集——自建标注成本远高于预期,能借用预训练就借用。
三个坑
第一个坑:两期影像没对齐,模型再强也白搭。 配准误差会直接变成「变化」输出。用前先检查:同一天获取、传感器一致、已做几何校正;武大学报那篇把配准并进网络,就是在回应这个问题——你自己处理时也要先对齐。
第二个坑:开放词汇≠零成本。 Zero-OVCD 免的是「变化类别标注」,推理还是要基础模型和伪标签流程,本地部署有显存门槛(基础模型编码器通常在 8GB+)。小团队先跑社区微调版。
第三个坑:指标好看≠区域适用。 LEVIR-CD 是城市建筑数据集,F1 88% 不代表在山地、沙漠、农田同样成立。区域换掉,效果先降一半再评估。
小结
2026 年 AI 变化检测的四条线:可信差异筛选(伪变化)、开放词汇(免标注)、轻量级(工程化)、业务卫星(落地)。对从业者,落地路径是「传统差值法兜底 → 开源模型跑初稿 → 人工复核修边界」,并把「AI 输出当草稿」当成默认习惯。变化检测的本质没变——把「哪里变了」找出来;2026 年只是让「找得准、找得快、不用标数据」往前迈了一步。