ARTICLE · 1277381
为什么 AI 生成的语言如此难以理解?
为什么 AI 生成的语言如此难以理解?
这句话是纽约大学和得州大学奥斯汀分校的三位研究者故意写的。 作者说,如果你在网上看到这句话,多半会怀疑是 AI 写的。一句话里就叠了4 种前沿大模型偏爱、又会让人读着更费劲的写法。 很多人用 AI 写文章、查资料时都有同一种感受:AI的回答每句话都对,但是读一会就累。 这篇论文把这种累拆成了能数出来的语言特征。 作者收集了 14 个模型的输出。 9 个前沿和准前沿模型:Claude 的 Sonnet 5、Opus 5、Opus 5.5、Fable 5,GPT-5.6 的 Luna、Terra、Sol,以及 GLM 5 和 Kimi K2.5。 5 个对照小模型:Llama 和 Olmo 两个系列。 测试分三个场景: 和模拟用户闲聊 12 轮; 给 5 个真实 GitHub 项目找 bug、修 bug; 按美国中学生作文题写议论文。 结论是,大多数前沿模型会系统性地多用一批写法。心理语言学几十年的研究早已发现,这些写法会增加人的阅读负担。 作者推测的原因是:模型的训练目标越来越偏向"答对、写短",而不是"让人听懂"。 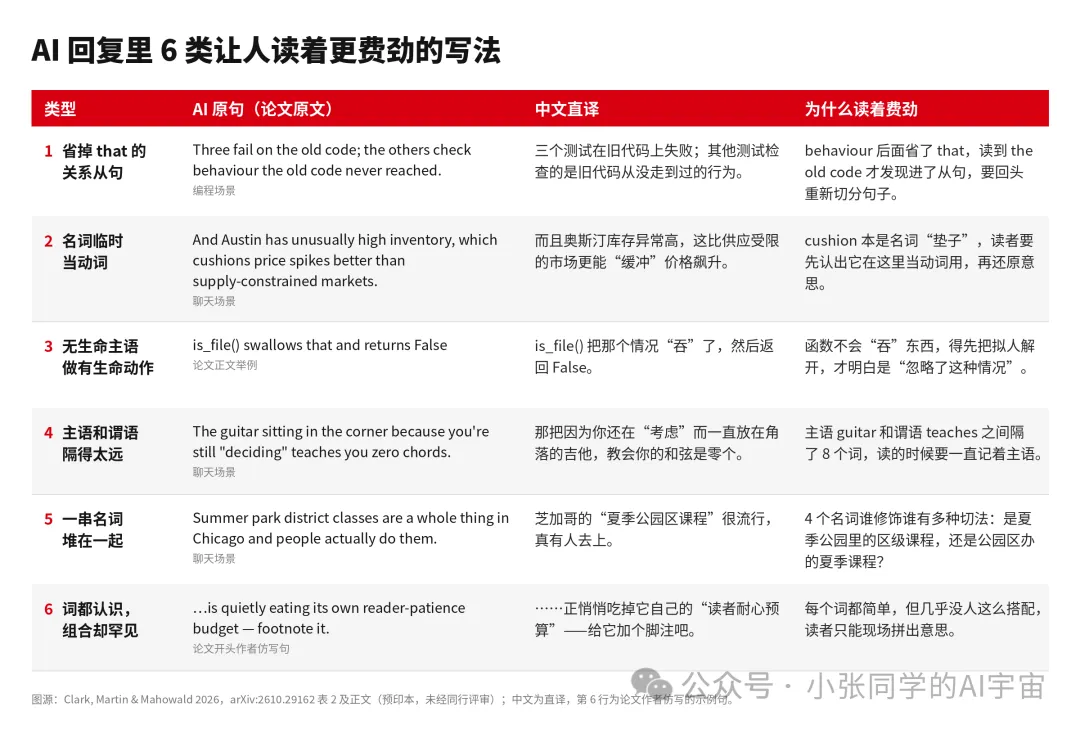
这 6 类写法在英语语法上都没错。问题在于,它们会把还原意思的工作留给读者。 也就是 AI 写得回答读起来费劲这个问题,是因为这个意思本来就只能这么写,还是明明有可读性更轻松的方式,AI没有选呢? 作者用了一个巧办法,转述一遍,来证明这就是AI的问题! 把 AI 写的每句话交给翻译软件,先译成日语,再译回英语。(原作者是国外的,所以这里作者的测试是以英文为主) 翻译软件习惯用人话翻译,所以就能得到 同一个意思的说人话版本。 举个例子(这是为了给大家讲明白编的,不是论文里的句子): AI 原句:这一步吃掉了一半预算。 转述后:这一步花掉了一半的预算。 意思不变,但AI会把"花掉了"写成“吃掉”,这样会更紧凑,但人类读的时候,会多一步拟人的思考。 AI 原句:老板交代周五前要交报告还没写完。 普通说法:老板交代周五前要交的那份报告,还没写完。 (少了「的那份」,读到「要交报告」会以为话已经说完,只好倒回去重读。) AI 原句:这个小漏洞迟早会咬人。 普通说法:这个小漏洞迟早会惹麻烦。 AI 原句:那台你上个月说等打折再买、后来又因为搬家一直没顾上、现在还躺在购物车里的咖啡机,降价了。 普通说法:你购物车里那台咖啡机降价了。上个月你就说等打折买,后来搬家一直没顾上。 AI 原句:小区物业夏季停车收费调整通知已发。 普通说法:物业发了通知,小区夏天的停车费要调了。 AI 原句:这次沟通我们的信任余额不太够。 普通说法:这次聊下来,对方还不太信得过我们。 结果是,几乎所有前沿和准前沿模型在三个场景里都是这样, 还有一个对比值得注意。 小模型 Llama 系列,以及 Olmo 的基础版和指令版,转述一遍前后的变化最小。 但同属 Olmo 系列的推理版,这种倾向就明显得多,接近前沿模型。 作者据此认为,这些写法主要来自预训练之后的后训练阶段,而不是模型从人类文本里原样学来的。 不过议论文场景里的差别整体小得多。 作者推测,写作文是一问一答,而聊天和改代码是多轮来回,长对话可能更需要压缩信息。 人类语言长期受"要让对方听懂"这个压力塑造。 比如,人说话会尽量让相关的词靠近,也会把信息摊得比较均匀,不在一处塞得太满。 作者推测,如今的大模型在预训练之后,还要大量练数学、代码和推理。这类训练奖励的是答案对不对,并不专门奖励表达清楚。再加上模型能处理的上下文长度有限,用更少的字说完同样的事就成了一种压力。 为了验证这个想法,他们拿一个 1.5B 参数的小模型 Qwen2.5-1.5B 做实验。任务是把结构化的事件描述改写成一句英文,同时对答案长度扣分。 结果,在不加额外约束时,有两种英语句式里的 that 可省可不省,模型选省掉的比例都超过 98%。人类会看上下文决定要不要加 that,模型则几乎一律省掉。这种偏好还迁移到了一些训练时没见过的句式上。 需要说明两点: 这只是在一个小模型、一个简单任务上做的概念验证,向远处句式的迁移也很有限。 商用大模型的训练过程,作者无法直接干预。所以"后训练压力导致 AI 难读"目前仍是作者的推测,没有被证明。 这篇论文受关注,是因为它说中了很多人的感受。 今年 8 月,有人发帖问:"是不是只有我觉得 Claude 最近越来越难懂?" 截至 10 月 30 日,帖子拿到 546 分。 第一作者在 X 上补充过一个区分。"三连排比""不是 X,而是 Y"这类口头禅,只会让文字听起来像 AI,并不一定难懂。这篇论文关心的是心理语言学上会增加处理负担的结构。 不同模型之间差别很大。 最直接的例子是 Claude Opus 5.5 和上一代 Opus 5:在 21 项和阅读难度相关的比较里,Opus 5.5 有 19 项更低。 作者据此认为,在训练中奖励模型"好好沟通"是做得到的,Opus 5.5 的改进就是一个例子。 作者在结论里还提到,这件事不只关系到人类读者舒不舒服。 模型的推理过程也是用文字写出来的,如果越来越多地用人读着费劲的写法,人类检查它"在想什么"也会更难。
先读一句话:
"你的直觉没错;你正在读的这句绕来绕去的话,正悄悄吃掉它自己的'读者耐心预算'——给它加个脚注吧。"
论文结论总结
让人读着费劲的写法