ARTICLE · 1287618
AI越来越像人了怎么办?——Nature最新研究:7万多次判断实验背后的信任难题
一张沙滩上的照片,一个男人背对镜头,身旁露出一个孩子的脑袋。由于拍摄角度巧妙,两个人的身体仿佛拼在了一起,看上去就像男人把自己的头摘下来,拿在手里。
让AI描述这张照片,它说得很准确:男人坐在沙滩上,面向大海,旁边有个孩子,画面营造出一种有趣的视觉效果。
换成真人,描述就不一样了:这男人的脑袋哪去了?怎么好像把自己的头拿下来了?
AI并非没有发现画面的趣味,但真人一下子抓住了让人发笑的关键。
两种描述都没错,只是关注的东西不太一样。
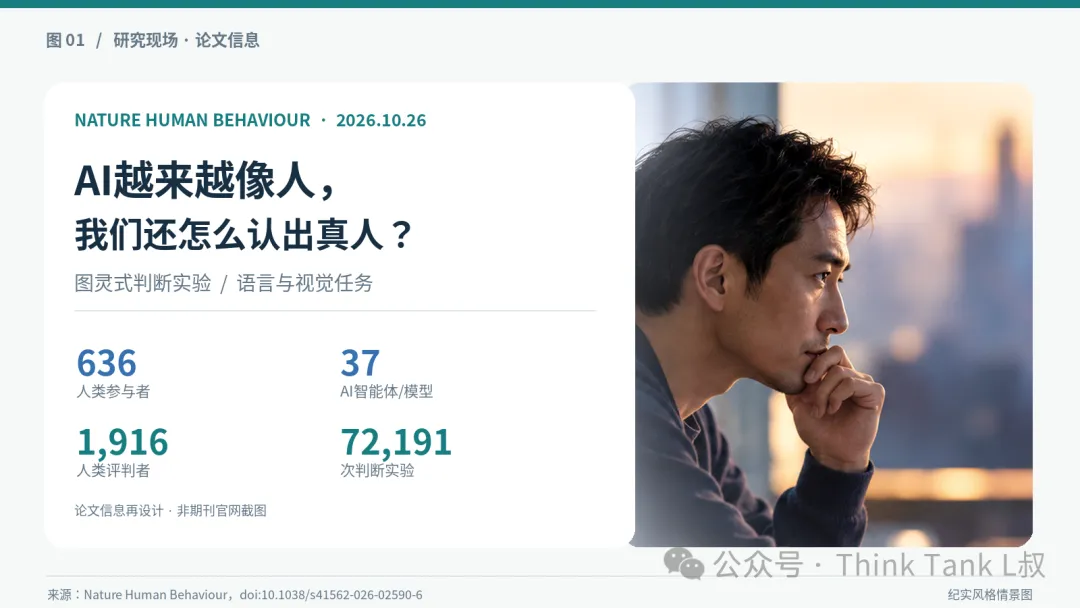
这个例子,来自10月26日发表在《Nature Human Behaviour》(《自然·人类行为》)上的一项研究[1]。
研究人员想回答一个看似简单的问题:
当机器越来越像人,我们还有多大把握分辨,眼前的回答究竟来自真人,还是AI?
一、7万多次判断,人类表现得怎么样?
研究人员找来了636名人类参与者、37个AI智能体或模型,又邀请1916名人类评判者,以及10种AI评判器,进行了72191次类似图灵测试的判断实验。
实验分成六类,包括图片描述、词语联想、对话,以及颜色估计、物体识别、视觉注意预测。
规则并不复杂:给你看一段回答,或者一组视觉判断结果,让你猜它来自人还是机器。
结果有些出人意料。
在三项语言任务中,人类评判者的综合识别准确率分别约为57%、53%和57%。
如果把猜硬币的50%当作参照,这些成绩确实算不上出色。
不过,实验里还有一个更有意思的结果。
在图片描述任务中,一个经过专门训练的简单机器学习分类器,综合识别准确率达到约77.5%,明显超过人类评判者的57%。
也就是说,在这个实验条件下,机器比人更擅长识别哪些话是机器写的。
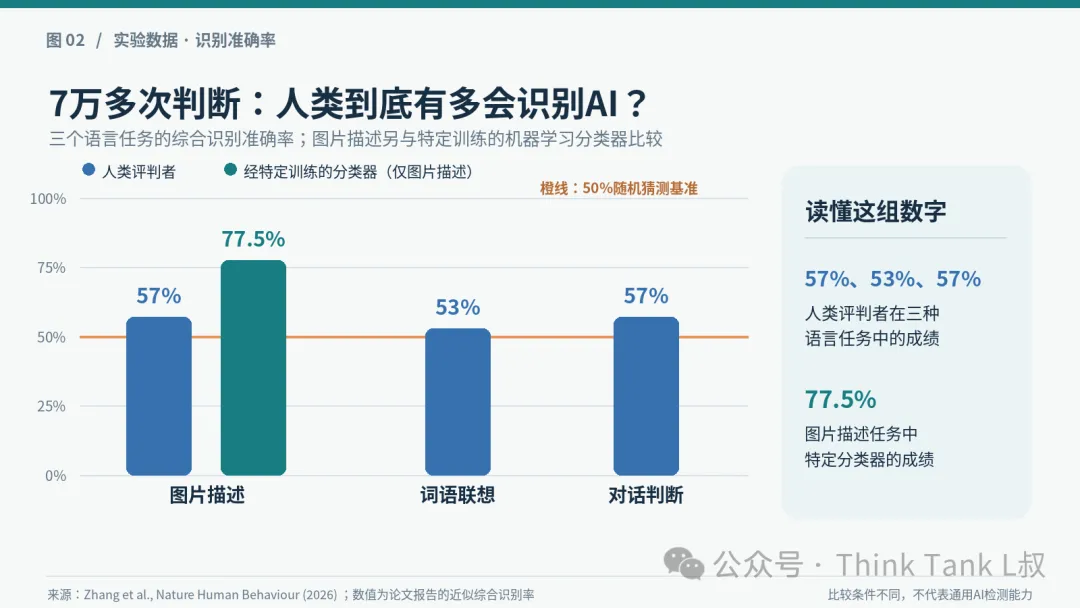
当然,这不代表任何AI检测软件都比人可靠。实验中的分类器使用了特定训练数据,换一批模型、换一种文字、换一个场景,效果可能完全不同。
研究人员也发现,主动提问会改变结果。
在另一组互动实验中,人类可以自行设计问题,向真人和GPT-3.5-Turbo发问。这时,评判者在特定测试条件下实现了100%的正确识别。
为什么?
因为他们不再只是读一段现成的文字,而是有机会追问个人经历、观察回答方式,甚至利用对方的反应速度寻找线索。
但换成另一种关闭部分安全防护的Llama模型后,识别就不再完美。
这其实比“AI骗过了人类”更值得琢磨。
我们不是完全没有办法识别AI,而是过去习惯依靠的某些判断方式,越来越不可靠了。
二、AI说得像人,不代表它真的更懂人
回到开头那张沙滩照片。
论文里还有一个很重要的发现:一个AI模型在常规任务上的表现好坏,与它模仿人类的能力,并没有表现出很强的相关性。
一个模型可以把图片描述得十分准确,却不像普通人那样描述。
反过来,一个模型即使判断错了,也可能因为犯错方式像人,被评判者认为是真人。
这就产生了一个值得区分的问题:
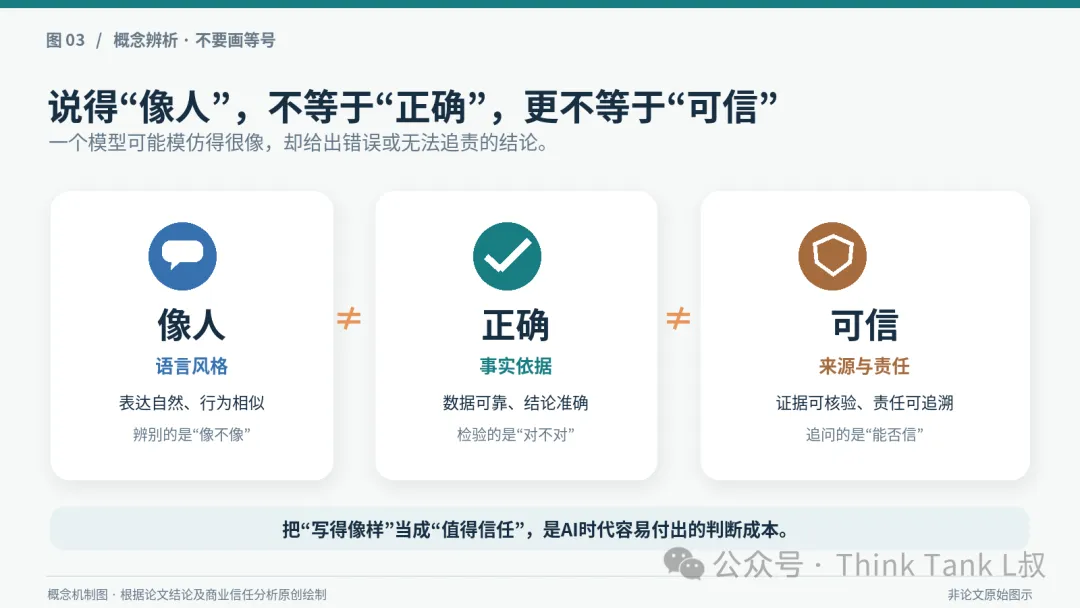
说得像人、说得正确、真正理解问题,其实不是一回事。
日常使用AI时,这种区别并不陌生。
让它写一封道歉信,措辞可能很周到,但究竟错在哪里、怎样补救,还得由当事人自己面对。
让它写一份行业研究报告,目录齐全、观点完整、语言流畅,也可能掩盖了关键数据未经核实、行业假设不成立的问题。
有时,最令人警惕的不是AI说得不对,而是它把一个未经验证的判断,说得特别像那么回事。
这里还有一个容易被忽略的变化。
过去我们判断一个人是否专业,往往会看他的表达:语言是否流畅、逻辑是否清晰、术语是否熟练。
这些标准并没有失效,但单独依靠它们,越来越不够了。
因为让表达显得专业的成本,正在迅速下降。
三、当人人都能说得漂亮,谁来承担信任的成本?
不妨想象这样一个场景。
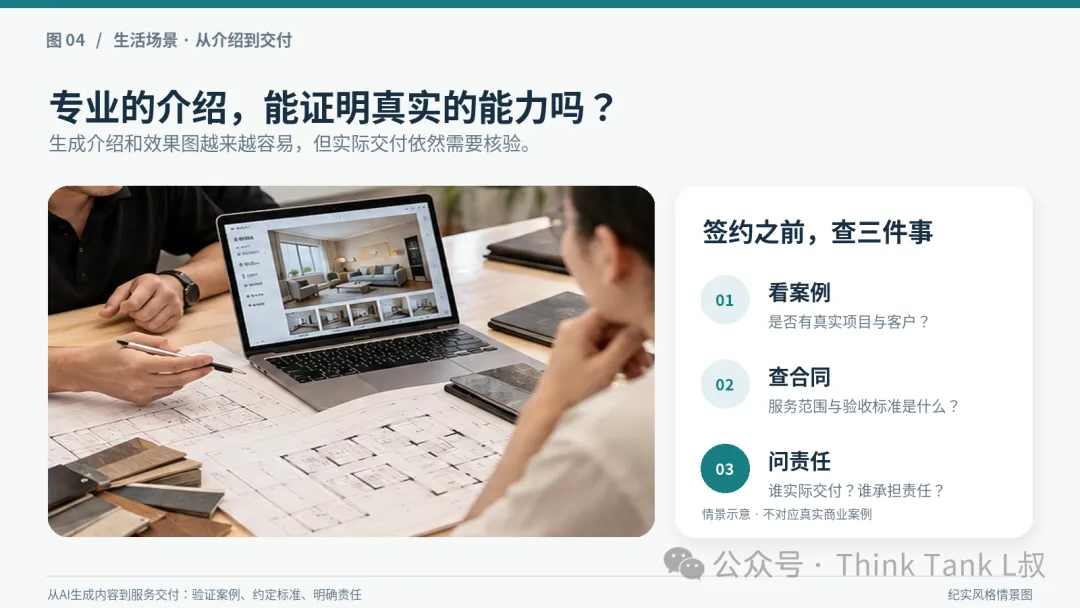
以前你在网上找装修公司,先看看介绍、案例照片,再和设计师聊一聊。对方讲得专业,回答又快,你可能就愿意继续谈。
现在,一家没有多少实际经验的公司,也可以借助AI写出漂亮的介绍,生成逼真的效果图,甚至全天候回答客户问题。
这当然有好处。小公司可以降低服务成本,消费者也能更快获得信息。
但问题来了:
介绍写得好,是否意味着工程做得好?
效果图漂亮,是否代表真的有过类似项目?
回答足够专业,是否意味着背后有人能承担责任?
消费者最后仍然得去核实案例、查看合同、了解施工团队,甚至找以前的客户打听。
AI降低了制造可信外观的成本,却未必同步降低验证真实能力的成本。
这不是论文直接证明的商业结论,而是它引出的一个现实问题。
从商业角度看,这种变化可能带来一次价值重新分配。
首先受到影响的是内容平台。
以前,平台需要解决的是内容够不够多、分发够不够快。现在,还要考虑信息来源、身份真实性,以及如何处理AI生成内容带来的混淆。
其次是专业服务行业。
咨询、设计、法律、教育等行业,过去有相当一部分价值体现在知识表达上。AI提高了这部分工作的效率,但客户最终购买的并不只是文字,而是解决问题的能力与履约保障。
一份漂亮的研究报告可以很快生成,可其中的数据从哪里来、判断是否站得住脚、建议能否执行,依然需要有人负责。
更深一层,个人信誉也可能发生变化。
过去,一份精美的履历、一段得体的自我介绍,能够帮助别人快速形成第一印象。
将来,这些东西依然有用,只是证明能力的分量可能下降。
真实项目经历、可以核验的成果、长期合作关系,以及遇到问题时愿不愿意负责,可能更加重要。
这里不能简单理解成“AI让信任必然变贵”。AI也能帮助识别异常、核验材料、降低审查成本。
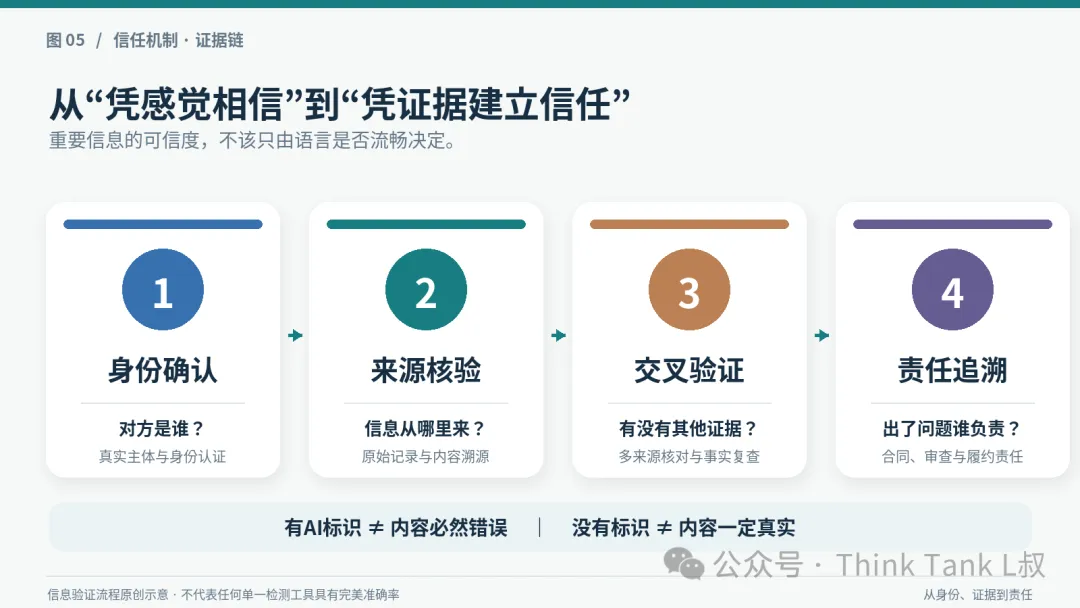
真正的变化在于:信任不再只是表达带来的印象,而越来越需要证据和制度来支撑。
四、我们正在重新学习怎样相信别人
其实,这种变化已经进入现实规则。
我国《人工智能生成合成内容标识办法》已于2025年9月1日起施行[2],对相关场景下AI生成的文字、图片、音频、视频等提出了显式和隐式标识要求。
显式标识,是让人能够看见的提示;隐式标识,则可以记录在文件元数据等信息中。
这意味着,判断内容来源不能总靠用户自己猜。
当然,标了“AI生成”不代表内容一定有错;没有发现AI标识,也不代表内容一定真实。
标签解决的是一部分来源识别问题,不能替代事实核验,更不能替代责任。
未来或许会形成一套新的信任方式:
先确认对方是谁,再核实他提供了什么证据,最后看有没有人对结果负责。
对于普通人,我觉得没有必要每天训练自己,去猜每篇文章、每段聊天到底是不是AI写的。
这种游戏可能永远没有终点。
更有用的办法,是改变提问方式。
看到一条重要消息,不妨先问:原始出处在哪里?
面对一个专业建议,不妨追问:依据是什么?有没有不同证据?
准备为一项服务付费,不妨确认:谁来执行?结果不好怎么办?
对于自己的工作,也可以多留下一些真正能够证明能力的东西,而不仅仅是漂亮的表达。
1950年,图灵提出那个著名的模仿游戏时,讨论的是机器能否表现得像人。
七十多年后,越来越多的机器正在接近这个目标。
但对生活在今天的我们来说,也许更重要的问题已经发生了变化。
一段话是不是人写的,当然值得知道。
但它是不是真的、有没有用、出了问题谁负责,可能更加重要。
当机器越来越擅长表现得像人,我们或许更需要学会的不是识破机器,而是重新认识什么值得相信。
资料来源 / 参考资料
[1] Zhang, M., Pavarino, E., Liu, X. et al. Turing-like tests for language and vision demonstrate a narrowing gap between humans and AI. Nature Human Behaviour,2026年10月26日。https://www.nature.com/articles/s41562-026-02590-6
[2] 国家互联网信息办公室、工业和信息化部、公安部、国家广播电视总局:《人工智能生成合成内容标识办法》,2025年3月发布,2025年9月1日起施行。https://www.cac.gov.cn/2025-03/14/c_1743654684782215.htm