ARTICLE · 1287813
端侧AI工具链原理(07):PTQ、QAT与混合精度:量化不是把FP32改成INT8
本文是端侧 AI 工具链原理第 7 篇。上一篇完成 Tiling 和内存规划,这一篇讨论低位宽:怎样建立校准、量化、逐层定位和任务精度回归的完整流程。
开篇:模型能运行,输出也很像,为什么业务指标仍然掉点
量化后中间 Tensor 的余弦相似度可能都很高,检测 mAP 却明显下降;另一模型单层误差较大,最终分类 Top-1 反而稳定。
原因是量化误差会沿图传播,任务对不同层和不同通道的敏感度不同。量化不是格式转换,而是带约束的数值设计。
一、线性量化的基本公式
从实数到整数:
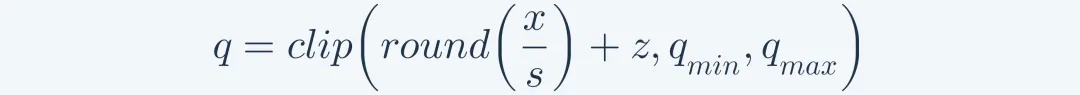
反量化:
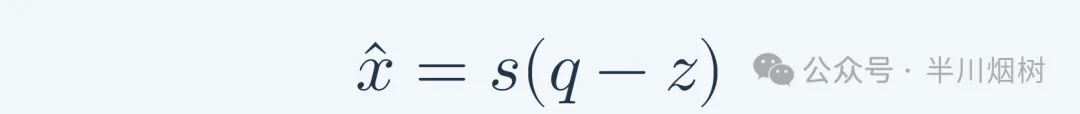
s决定量化步长,z让整数零点对应实数零。范围过宽,步长变粗;范围过窄, Outlier 被截断。
二、对称、非对称与 Per-channel
对称量化通常令z=0,硬件计算简单;非对称量化可以更充分利用偏移分布的整数范围。
权重 Per-channel 量化为每个输出通道设置s_c,能适应不同通道范围,通常比 Per-tensor 精度好,但需要硬件和 Kernel 支持 Scale Axis。
对于矩阵乘,Accumulator 近似为:
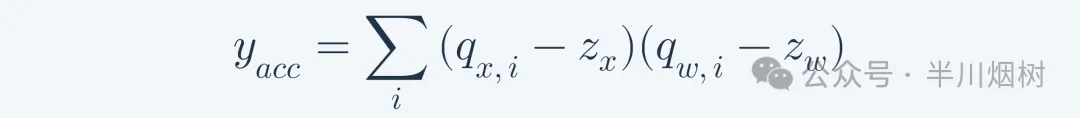
输出还需乘s_xs_w并 Requant。Accumulator 位宽不足会发生溢出,即使输入量化误差很小也无法恢复。
三、 PTQ 的关键是校准,不是点击转换
Post-training Quantization 使用训练后模型和校准数据估计 Activation 范围。常见策略包括 MinMax、Percentile、KL Divergence 和 MSE。
校准集必须覆盖真实分布:
几十张“看起来正常”的图片可能得到稳定转换,却不能代表量产数据。
四、 QAT 什么时候值得做
Quantization-aware Training 在训练前向中模拟量化,反向通常使用近似梯度,让参数适应误差。
适合 QAT 的情况:
如果 Fake Quant 配置与目标 Kernel 的 Rounding、Clamp、Axis 不同,QAT 学到的是错误硬件模型。
五、混合精度是离散优化问题
设每层可选精度p_i,目标是:
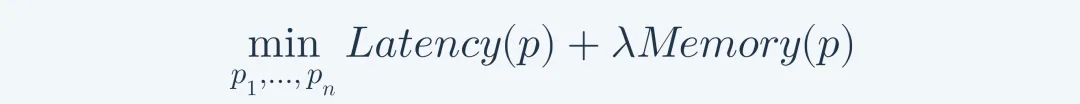
满足:
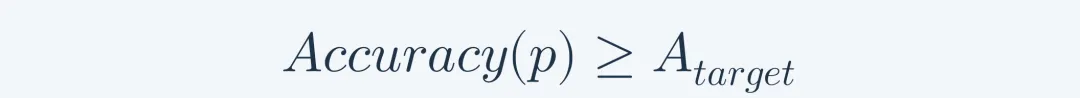
穷举组合不可行,工程上可使用敏感度分析、逐层回退和 Cost Model 。先量化全图,再把最敏感层恢复为 FP16 或更高位宽,直到精度达标。
但恢复高精度会引入 Cast 、分图或不同 Kernel ,必须同时测端到端性能。
六、 Weight-only 与 W8A8 不是同一种路径
Weight-only 量化压缩权重,Activation 保留 FP16/BF16,主要降低容量和权重带宽。W8A8 同时量化权重与 Activation,有机会提高计算密度,但校准和误差控制更困难。
对 LLM Decode,Weight-only INT4 常能直接减少每 Token 读取字节;对 CNN, W8A8 更容易发挥密集 INT8 阵列吞吐。选择应由算术强度和硬件原生路径决定。
七、逐层定位需要三条基线
建立:
若第 1 与第 2 已经偏差,问题在转换;第 2 与第 3 偏差才主要属于量化或目标 Kernel。
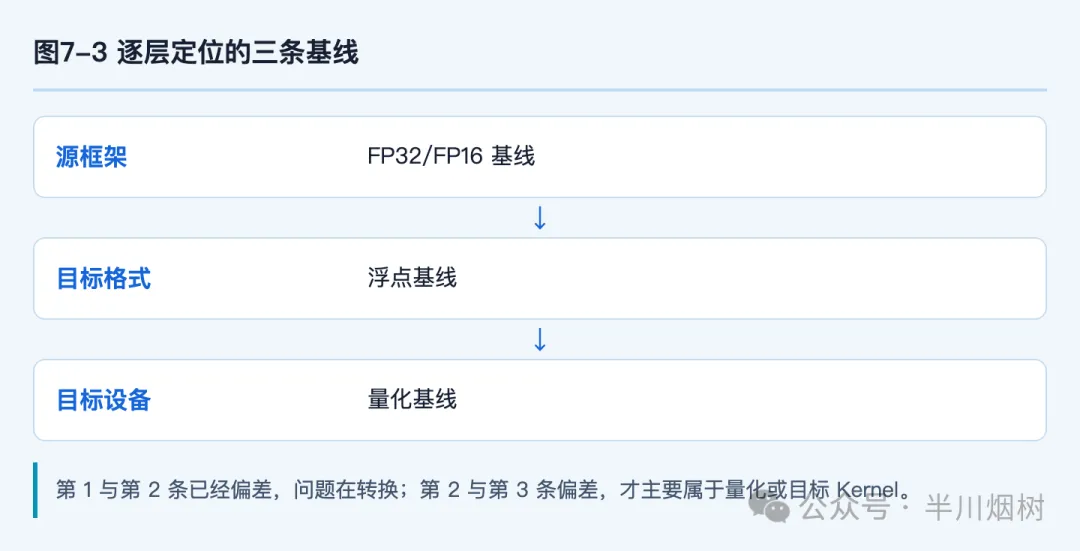
对每层记录:
八、 Outlier 怎样处理
少量极值会扩大 Scale,压缩主体分布的有效整数级。可选方法包括:
任何处理都要在完整任务集上验证,不能只看 Histogram 变得“更漂亮”。
九、量化收益也要验证硬件兑现
模型文件变小不等于推理更快。需要确认:
真实性能收益为:
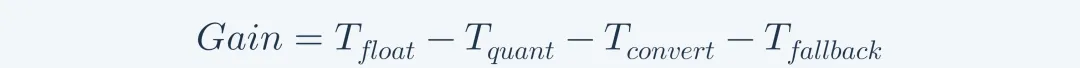
十、一个检测模型量化失效案例
假设检测模型分类分支量化后 Cosine 为0.999,Box 回归分支为0.992,看起来都很高,但 mAP 下降4个百分点。进一步分析发现,Box 输出经过 Decode 后,小坐标误差在大分辨率上被放大,NMS 又会改变候选排序。
定位过程应为:
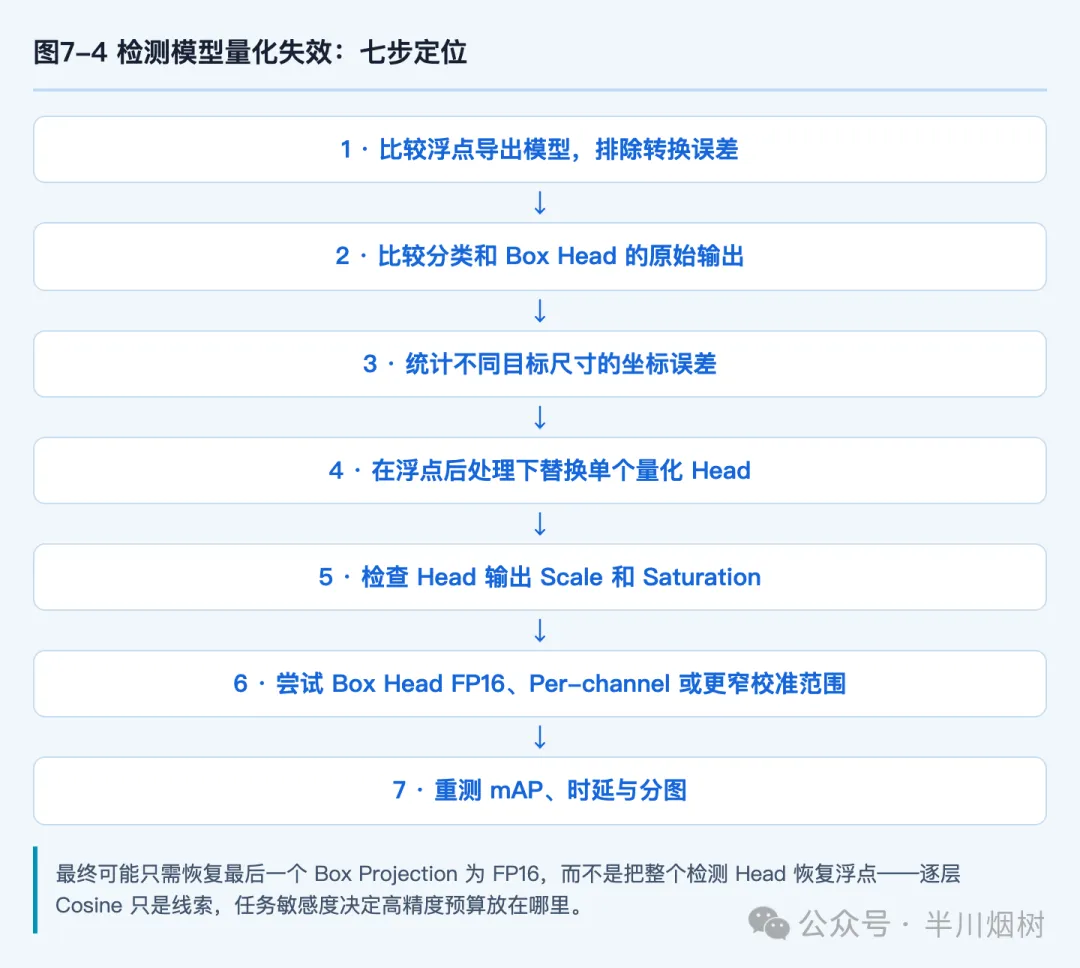
最终可能只需恢复最后一个 Box Projection 为 FP16,而不是把整个检测 Head 恢复浮点。这个案例说明,逐层 Cosine 只是线索,任务敏感度决定高精度预算放在哪里。
十一、校准数据应该怎样分层抽样
以相机检测为例,可按光照、目标尺寸、目标数量、运动、设备和场景构建 Stratum。每层抽样数量不必相等,应覆盖量产概率和高风险长尾。
对分层i,可以设权重p_i和样本数n_i,校准集满足:
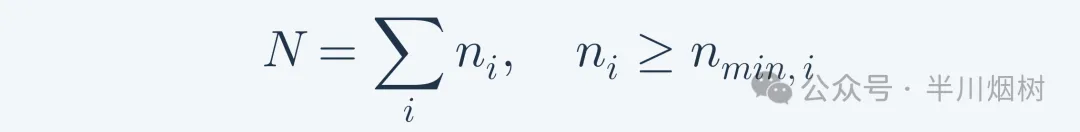
高风险小概率场景即使p_i低,也设置n_min,i。否则纯随机采样很容易漏掉夜景高 ISO、极端高光和小目标。
校准集、精度验证集和量产监控集职责不同:校准集估计范围,验证集决定任务指标,监控集发现分布漂移。三者不能使用同一小批样本替代。
十二、低比特硬件契约应写到什么程度
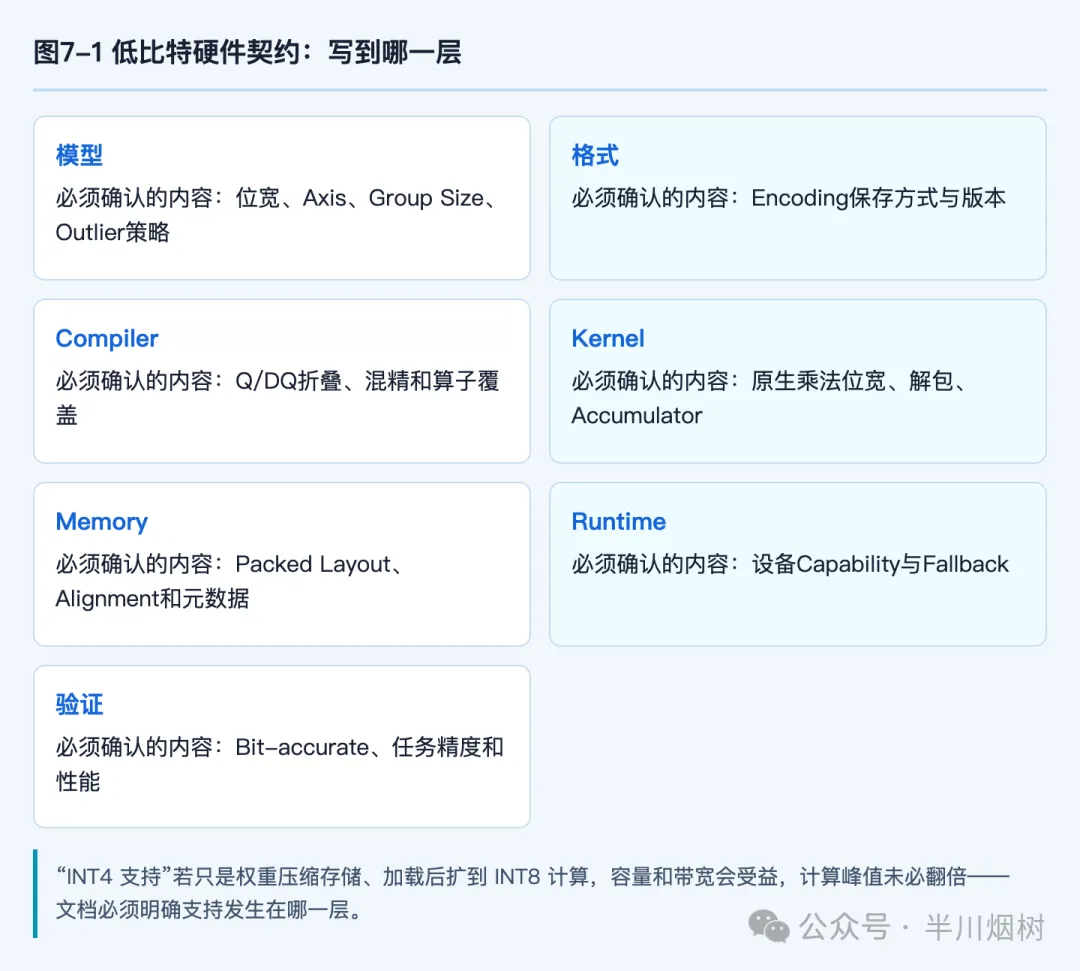
例如“INT4 支持”若只是权重压缩存储,加载后扩展到 INT8 计算,容量和带宽会受益,但计算峰值未必翻倍。文档必须明确支持发生在哪一层。
十三、 QAT 训练与部署回归闭环
QAT 每次更新后,自动导出目标格式、运行 Compiler 并在代表设备验证。若训练只看 Fake Quant 精度,可能在最后才发现某层无法按训练配置部署。
门禁包括:训练任务指标、导出格式指标、目标设备指标、NPU 覆盖、P99、Peak Memory 和资产体积。QAT 不是算法团队单向交付,而是训练与工具链持续联调。
十四、 AIISP 暗部量化案例
降噪网络使用 Residual 输出,暗部有效残差可能集中在[-0.02, 0.02],但少量高光让全 Tensor 范围扩展到[-1, 1]。若使用对称 INT8 Per-tensor,步长约为:
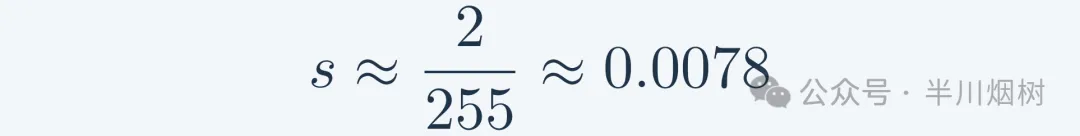
暗部残差只有几个量化级,容易出现 Banding 和色块。可选策略包括:限制校准 Percentile、对高光分支单独处理、使用 Per-channel、保持输出 Head FP16 或对 Residual 重新缩放。
判断方案时需要同时观察暗部 Patch 的误差分布、最终视频闪烁和目标 NPU 的 Cast 成本。只把 PSNR 提高0.1 dB,却让输出大 Tensor 在 NPU 和 GPU 间转成 FP16,可能不符合实时预算。
十五、量化回归报告应怎样写
报告不只列“INT8 精度下降0.3%”,还要包含 Float 基线、Quant Sim、导出模型和真机四阶段;每层 Encoding 与 Saturation;敏感层回退历史;任务分桶指标; NPU 覆盖;Q/DQ 节点;资产大小、P99、Peak Memory 与能耗。
这样下一版模型或 Compiler 才能复用结论,而不是重新猜测哪些层敏感。
还应保存量化失败样本及对应中间 Tensor。分类模型按类别和置信度分桶,检测模型按目标尺寸和场景分桶,AIISP 按亮度、ISO 和纹理分桶,LLM 按语言、Prompt 长度和任务分桶。平均指标相同的两个方案,可能在产品最关心的长尾场景上完全不同。
最终签字不应由算法精度单方完成。模型 Owner 确认任务质量,Compiler Owner 确认 Encoding 被正确 Lower,Runtime Owner 确认目标设备没有 Fallback,系统 Owner 确认 P99 和能耗。低比特是跨团队契约,也需要跨团队验收。
十六、四类校准算法到底在优化什么
MinMax
直接使用观测最小值和最大值。实现简单、保证样本不截断,但对 Outlier 敏感。一个极端值会扩大步长,让主体分布只占少量整数级。
Percentile
截去极少比例尾部,例如保留99.99%范围。它主动交换少量 Saturation 和更细步长,适合长尾但主体集中的分布。Percentile 不是固定经验值,应按层和任务验证。
MSE
搜索截断阈值,使原值与量化重建值均方误差最小:
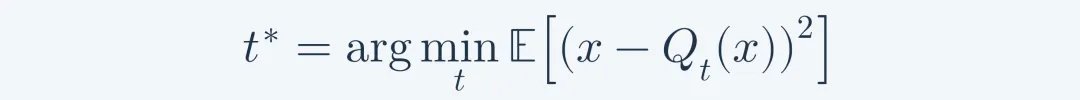
它优化 Tensor 重建误差,却不保证最终任务最优。少数高敏感元素可能在平均 MSE 中权重很低。
KL Divergence
比较原分布与量化后分布,常用于 Activation 校准。Histogram Bin、样本数和分布漂移都会影响结果。
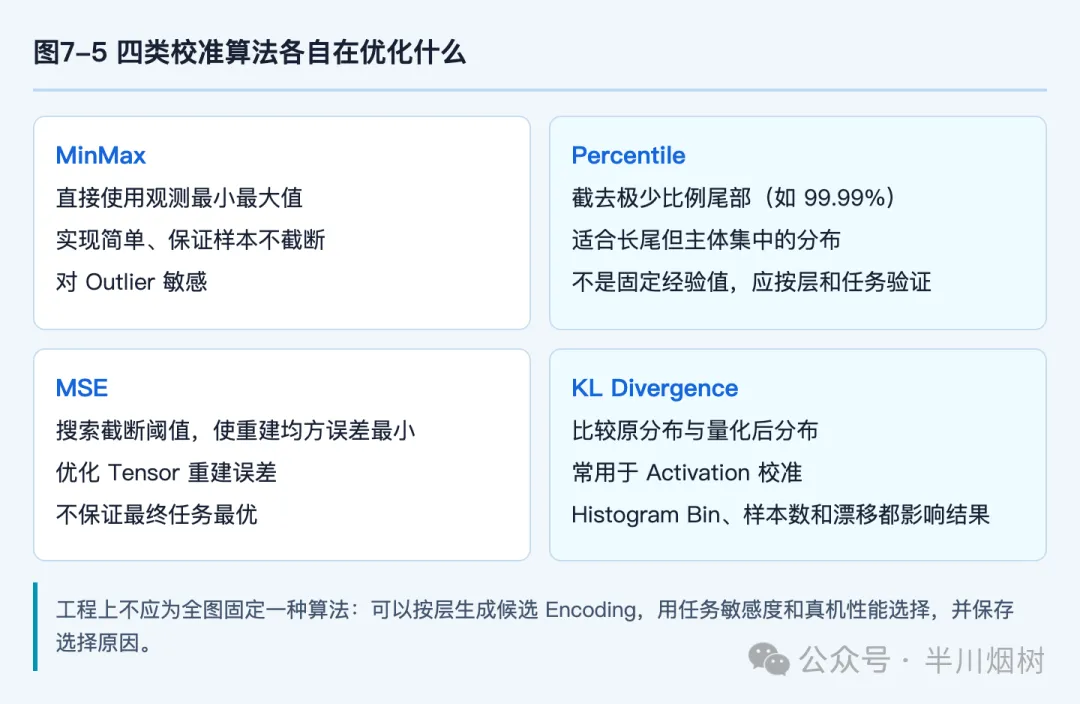
工程上不应为全图固定一种算法。工具可以按层生成候选 Encoding,用任务敏感度和真机性能选择,并保存选择原因。
十七、 QAT 中的 STE 和训练稳定性
Round几乎处处梯度为0,QAT 常使用 Straight-through Estimator,在反向近似:
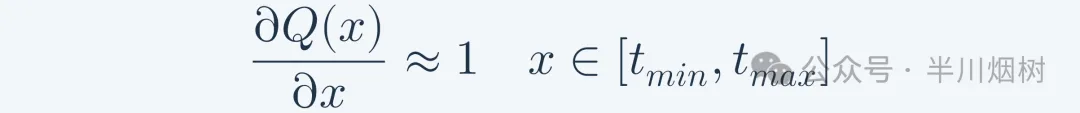
超出 Clip 范围时梯度可能设为0。这只是训练近似,不意味着硬件量化可微。
稳定流程通常是:从收敛浮点模型开始;先插入 Fake Quant 并短期冻结 Encoding;再逐步更新权重/Encoding;使用较小学习率;监控 Saturation、Scale 漂移和任务指标;最后冻结并导出。
若从头 QAT 或 Scale 持续震荡,模型可能把参数推到量化边界附近,在训练模拟中正常,设备 Rounding 差异却放大。
十八、混合精度搜索怎样降低组合爆炸
n层、每层k种精度共有k^n组合。实用方法分阶段:
单层敏感度并非完全可加。两个 Residual 分支分别量化可能稳定,同时量化却导致 Scale 不匹配。因此,对 Add、Concat、Attention 和共享权重建立 Group Constraint。
十九、 LLM 低比特的 Group-wise 代价
Weight-only INT4 常按 Group 共享 Scale。权重矩阵有P个元素、Group Size 为G、每个 Scale 为b_s字节,元数据约为:
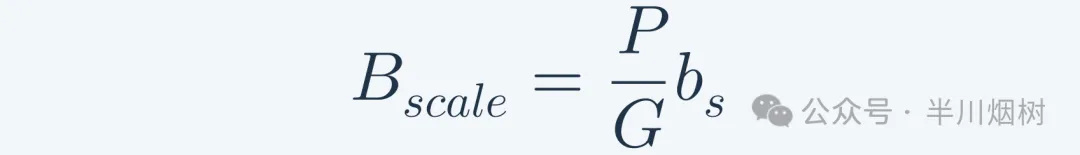
G越小,精度通常更好,Scale 元数据和反量化频率越高。Kernel 需要按 Group 加载 Scale,并可能在 Tensor Core 前解包与转换。
评估 Group Size 时同时测:模型体积、Perplexity/任务质量、Decode Token/s、Scale 带宽和本地 Workspace。仅比较权重位宽会高估收益。
二十、量化适用域也会随输入漂移
Calibration 在S≤512、普通 Prompt 上完成,不保证S=4096、代码或多语言输入仍有相同 Activation 范围。AIISP 模型在实验室25 °C标定,也不保证高温高 ISO 分布。
量产监控可以记录匿名化的 Range、Saturation 和 Fallback 统计,发现漂移后重新校准或调整混合精度。Encoding 是一份有适用域的模型参数,不是永久常量。
二十一、一份量化方案怎样通过准入
量化验收必须建立四层证据,任何一层失败都不能用另一层的成功掩盖。
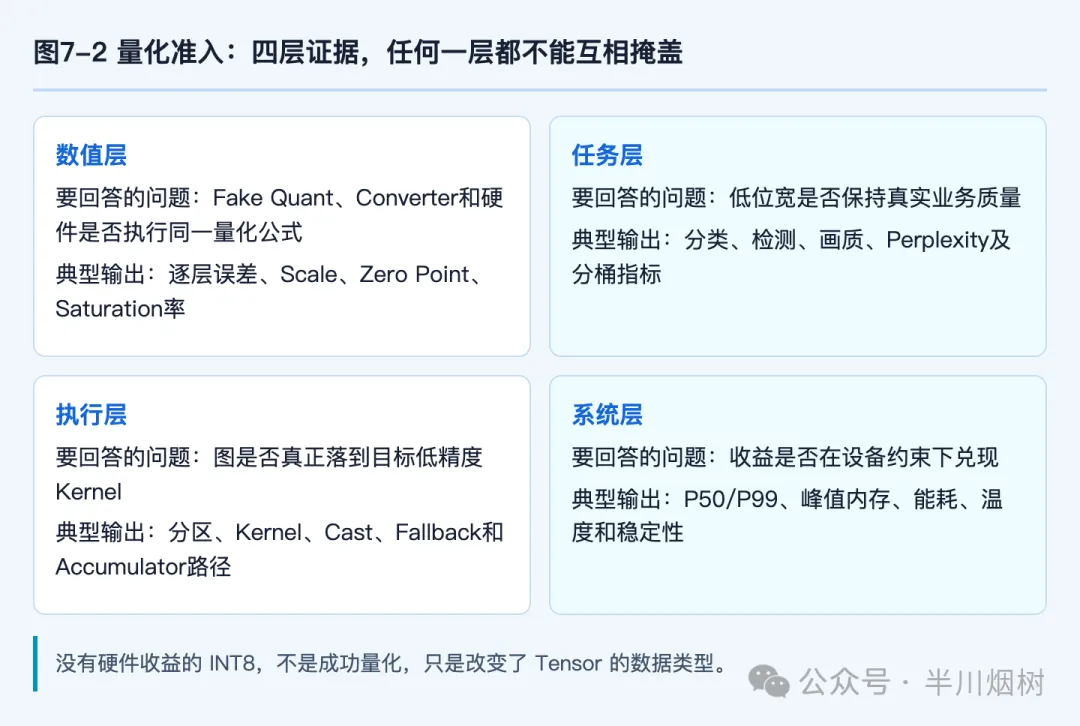
推荐使用三条 Reference 逐层收缩:FP32 Framework 作为算法基线;带目标 Rounding 和 Saturation 的 Bit-accurate Reference 作为数值基线;目标设备输出作为实现结果。若前两者已经明显偏离,问题在量化策略;若 Bit-accurate 正常而设备偏离,问题更可能在 Layout、Scale 索引、Kernel 或 ABI。
准入阈值还要按场景分桶。检测模型不能只看总体 mAP,还要检查小目标、暗光和边缘类别;LLM 不能只看平均 Perplexity,还要覆盖长上下文、多语言和代码; AIISP 需要关注暗部噪声、饱和区、运动区域和时序稳定性。最终报告必须同时列出“精度损失多少”和“换来了什么”,包括模型体积、时延、内存、能耗以及新增 Cast 或 Fallback。没有硬件收益的 INT8,不是成功量化,只是改变了 Tensor 的数据类型。
工程检查清单
结尾:低位宽是一份软硬件数值契约
PTQ 解决快速部署,QAT 解决模型适应,混合精度解决精度与性能的局部冲突。它们都必须与目标硬件的位宽、Scale 粒度、Accumulator 和 Kernel 路径对齐。
下一篇将从图级优化下沉到后端:Code Generation 怎样把 Tensor 与 Loop 语义变成 ISA、DMA 命令或 Kernel 调用。
参考资料
参考链接
[1] MLIR Quant Dialect: https://mlir.llvm.org/docs/Dialects/QuantDialect/
[2] PyTorch Quantization: https://docs.pytorch.org/docs/stable/quantization.html
[3] ONNX Runtime Quantization: https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html
--------------------------------
我是半川
一个偏爱在芯片底层与光影算法里死磕细节的工程师