ARTICLE · 1288919
浙江大学尹建伟教授:量子计算体系结构与软件理论研究及实践
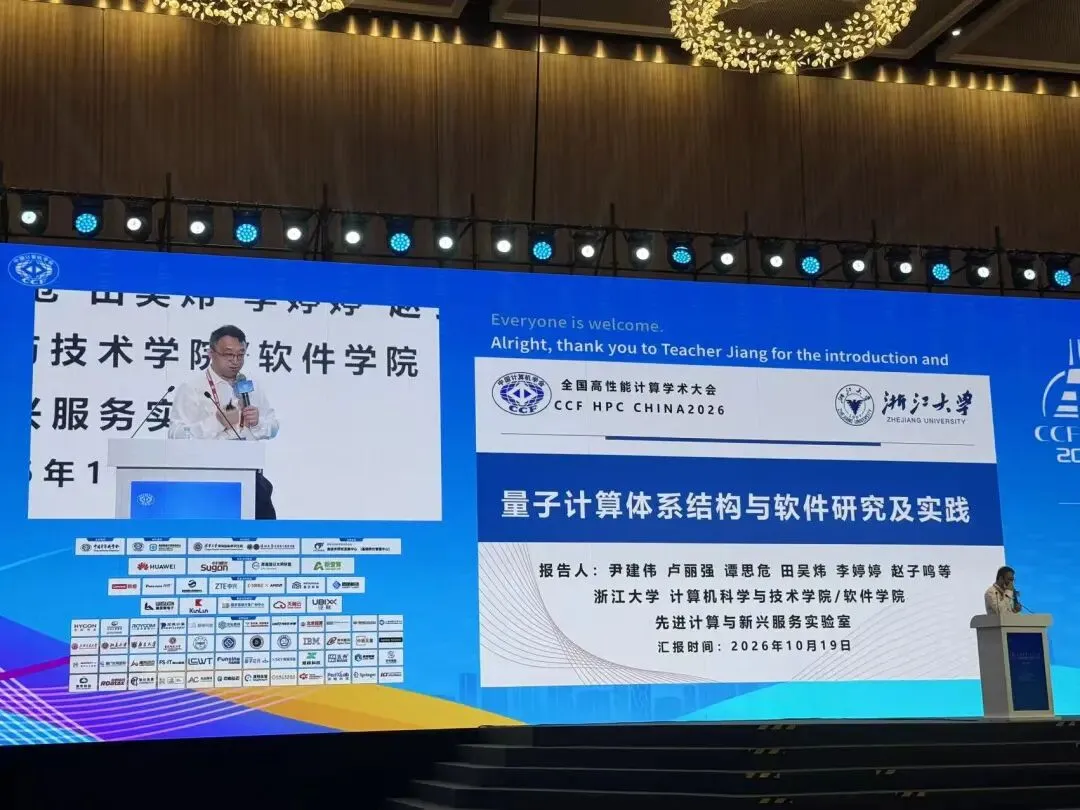
尹建伟,浙江大学特聘教授,计算机学院院长、软件学院院长,宁波国际科创中心主任,国家杰出青年科学基金项目、国家重点研发计划项目、国家重大专项项目负责人,国家重点研发计划文化科技与现代服务业专家组副组长,量子融合关键技术专家组专家,国务院学科评议组成员,教育部软件工程教学指导委员会副主任,工信部工业互联网战略咨询委员会委员,世界数据组织、数据开源专业委员会主任委员,中国计算机学会服务计算专委原主任委员。长期从事量子计算、数字服务、软件工程等方面的研究,获国家科技进步二等奖一项,省部级一等奖八项。尹建伟教授的报告题目是「量子计算体系结构与软件理论研究与实践」。
以下为尹教授在CCF HPC2026上的演讲实录:
今天我想主要给各位报告三个方面内容。第一个主要讲讲从科普的角度,来稍微谈谈对量计算的一点认知和认识。第二个就是从整个我们最近几年研究方面一些工作。因为时间我看了一下,可能只有半个小时,可能第二部分我可能挑重点,讲一下比较偏技术的内容。第三个主要汇报一下就是最近几年我们在量子计算方面一些实践方面的工作。
第一部分我讲讲计算机要讲量子计算机,但我想谈谈计算机的一个本质,这是一个认知,当然认识也不一定对,请各位批评指正。就是在座各位都是做计算机的,计算机的本质是什么东西?我认为计算机的本质是有三个字,就是计算机就记+算+机,什么意思?计就是信息编码。第二就是算-预算规则,第三个机就是整个的物理装置。
我们所有的计算机,从算盘然后到经典计算,到量子计算,实际上都是这三个字。计算机这三个字,就是我们要把我们的信息编成一个百千万,下面是1,上面是5,这样的一个编码规则。所以第一步是计,第二步是算。算就是运算规则。我们算盘就是三下五除二等等一系列规则的算。第三个就是我们的机,就是我们的装置。算盘子就是一个木头疙瘩,它就是我们计算的计算机,而且我发现这个算盘它是存算一体的,当时最先进的存算一体的计算机,所以这是算盘。
我们经典计算机和我们量子计算也一样的,我们经典计算机也是三个字计算机。机我们把所有的信息变成0和1,就是量子计算机我们把不是变成0和1,是把变成0和1的一个概率就是用布尔克球来做信息的一个编码。
第二就是算就是规则。我们今天计算机是有各种逻辑,量子计算也一样的,它也有与门分码与毫米分mer让XMY然后polymer等各种门。同时我们今天计算机都是通用图灵机,来作为整个计算的保障。
我们是通用量子图灵机,这两个是等价的,所以这是算。机就是我们各种装置。我们知道今年计算机我们有真空管,有电子管,然后有集成电路与超大规模集成电路,一代一代演化。量子计算也一样的,我待会讲我们八种实现方式。
所以计算机本质它就是计算机,就三个字,它的本质是这样的。它为什么能搞量子计算呢?我认为关键是四个特性,是因为量子的四个特性,决定了我们可以做量子计算。
第一,因为量子的一个特性,是一个叫纠缠。纠缠啥意思?就是两个量子,这边是0,另外就是1,这个是1,另外一个就是0。这个特性是什么意思?这就是二极管,因为有了二极管,那我们就可以做各种三极管,我们可以做各种逻辑门出来。所以量子为什么可以做计算?是因为量子纠缠,所以我们可以实现各种计算的逻辑,所以这是第一个特性。
第二个特性是叠加,什么叫叠加?就是从一个态到另外一个态,那么它是一叠加态。叠加态就像一个硬币一样,我在旋转过程中是正面还是反面我是不知道的,是0和1的概率,是正面反面的概率。1因为有了叠加态我们信息表示,我们可以同时表示多个信息,我们可以做并行计算。所以量子的第二个特征就是叠加,叠加使得我们可以做并行计算,这是第二个关键点。
第三个关键点就是量子隧穿效应。量子隧穿效应,它可以保证我们的量子在物理上可以实现。因为我们知道,我们的量子算法是干嘛呢?是啥东西?是基层能量。所以量子的算法是这样的过程,下面的一个曲线,然后的话通过我们的算法,要找到最优。在算法实现过程中,我们要穿越一个风,一个风一个风要穿越,从物理上保证了量子隧穿效应。因为有了隧穿效应之后,我们就可以这个点到下面一个点。如果没有这个隧穿效应我们就做不到。
第四个就是坍塌,就是量子测量,一测量然后它就没了,探讨一个具体的态。那这时候的话就是我们的安全计算。所以量子的话有四个我觉得最最本质的一个特征,纠缠叠加、隧穿和坍塌。这四个本质的特征就决定我们可以做计算,我们可以做并行计算,我们可以实现我们的算法,我们可以实现我们做安全计算。所以我觉得这四条八个字是比较关键的。
第二就是量子计算,我觉得和精准计算一样的。我们精准计算就是从物理的原理设备到逻辑结构,然后到微体系结构,大家都比较清楚这样的一个栈。量子也一样的,我们也需要建立这样的一个栈。目前实际上这个栈还没那么完善。所以我们做量计算,我们干这些就是要把这个栈站一样建立起来。在这个过程中,我们要做体系结构的研究。我们要做量子的软件,量子软件我认为一样的也要也包括系统软件、基础软件和应用软件,也需要这样的一个工作。这个工作实际上现在目前来看还是一片蓝海。
大家实际上未来都可以做的工作,我觉得是非常多的。因为这个是我们过去经典计算机做了几十年的工作。未来量子计算机也要做这个工作,所以未来的这个事情可以很多,这是整个架构。
量子的实现方式我们现在看并没有收敛,就像我们过去有真空管,有各种实现方式一样,现在一样的。因为量子计算机现在目前还是处于再造二极管、三极管的状态。二极管、三极管到底怎么造比较好?现在有大致有8种实现方式。我们知道超导,IBM和谷歌搞超导,中性原子今年比较火,今年比较火looking,哈佛的looking,他们的这个中性原子这块的也公主戴尔福特都在。自旋量子原IBM今天还压了一个自旋量子,光量子、离子、拓扑量子健康信息等等大致的有这种方式。到底哪种方式比较好?现在不好说,各有各的优势,各有各的特色。可能量子计算未来多种方式会并存,可能不会收敛,而且可能也没必要收敛。因为不同的实现方式它有不同特色,超导量子可以实现复杂逻辑,中性原子可以规模现在目前做的比较大,自旋现在有很大突破。光量子目前它比较适合做神经网络的模拟,所以不同的实现方式,它有不同应用的背景。可能未来不需要收敛,这是大致整个装置。
量子计算它不是所有的事情都可以干的,它有它的优势。现在一个误导就是量子计算来了之后啥都想干,不是这回事,量子计算是只适合它比较适合干的一些事情。
我认为量子计算大致适合两类问题,比较适合来做。第一类就是我们输入比较简单的计算,比较复杂类型NPR的问题。因为原先的NPR的问题,我们经典计算机做不到。但是量子计算机它有高并行性,它可以做暴力搜索。依然很多的一些IP hard的问题,比方说SIT问题、背包问题等等。为什么可以破解密码?只是说分解问题,这些问题它可以比较适合。
第二类就是比较符合量子计算、量子力学规律的这些微观世界以及宏观世界的像湍流,刚才黄院士讲的,现在大气预报也有人在做用量子来做这方面的工作。因为它力学的一些模拟,团体的模拟和微观世界的力,它的规律是比较类似的。比较符合量子力学原理的问题,可以用量子计算来做。所以这是我认为的量子计算适用的范围。这是第一部分,主要向各位简单报告一下,我对量子计算的一些认识。
第二部分我想报告一下量子计算整个体结构方面一些研究探索。量子计算最近还是比较火热的。我们知道资本界现在今年特别火,反正今年一系列的各种投资,一系列的各种动作。学术界这两年比较热的,你可以看伊斯卡、马克尔和HBCA这三大会议,它专门一个check,就是专门做量子这一块专门提出来。原先是没有的,现在专门做了一个check。我们对这四大顶会相关的论文也做了一个统计。可以看到的话就是量子这一块基本上是还在稳步的提升。四大会议加在一起,从2019年到十多篇,现在到每年大约四十几篇。这样的论文的总体趋势,我们也对这个方向做了一个相关的梳理。
我们对四大顶会所有的会,我们发现最近几年的热点一直在变。过去大家关注的超导,现在比较关注,可以看到这四个方面大家比较关注。第一个就是现在中性原子离子阱这一块,新的量子计算的实现方式,这是一个方向。第二就是纠错,因为纠错是关键,因为现在量子计算面临最大问题就是因为我们只能做到99.9左右。然后上周我们知道谷歌刚刚说做到99.99,就是刚刚是上周的这个natural一篇文章,就是讲在谷歌刚刚做了一个工作,原先基本上是只能做到3个9,那我们要做计算,我们知道至少6个9,12个9到10的-6或者10的-12才做计算。所以你真正的技术还有很大的一些距离,所以纠错是关键。所以这是第二个纠错。
另外就是指令集架构,就是量质、量超智融合这一块的一些工作。还有一个问题就是算法优化,所以这是目前整个研究的一些热点。围绕整个量子的硬件软件、应用,我们团队实际上在五年前我们就在做这方面的一些工作。我们围绕着硬件这一块,我们对车控做了优化,对纠错做了一些工作。在量子计算的软件优化方面,然后在整个的一个算法优化等等一个方面,做了相关的工作。最近几年也在四大顶会上面也做了一些相关的成果,这些论文都是公开的,也可以去看,因为这个内容还是比较多的。我就从三个角度简单的向各位报告一下其中一些工作的思路和想法。
第一个角度就是量子计算整个架构的优化,因为量子计算整个架构和过去的架构还不太一样,这里面涉及到很多的一些架构优化的问题。第一个问题就是整个超导量子,它的布线系统的优化。因为我们知道超导量子它一个量子比特,大致需要三根线来做整个信号的传递。X、Y、Z,3根线,同时两个一量子的耦合纠缠又需要一条线。那这样的用的线还是比较多的,但是线实际上是蛮贵的。我们以公开价格做了一个分析,我们可以看到,一台150比特的量子计算机,500万美金。这里面50%是个布线和测控相关,占了50%这样的一个价格。我们最先进的最多也就是4000根线。按照现在目前的如果按照布线方式的话,也就一千多个量子比特,而且是逻辑比特,而且这是物理比特,那不是逻辑比特。这样使得你的整个制造过程受限了。这么多线有两种复用的方法。一种是评这个评分的复用,但平分复用的话串扰。第二复用,复用就会降低整个复杂度,那怎么办?所以说我们在提这个工作,就是怎么样把整个布线降下来,做的方法首先要对我们整个串扰进行建模,然后把距离和串扰之间建立这样关系。
那有了这个关联关系之后,我们就可以对我们整个怎么分组。因为每个量子的控制最终是一个波形,不同频率,不同的振幅,不同的频率,不同的强度来生成不同的一个门。这些门怎么进行组合优化,然后使得我就一根线,然后我就可以把所有信号传过去,这就是一个复用的问题,这方面做了大量工作。
第二就是在时间我怎么把它错开,不能闲着,那个线很贵,一根线我们算了一下,一个量子比特需要二十多万人民币,一百多个,布线算下来就很贵,所以这方面做了一些工作。这个工作做完之后的话,可以使得我们整个的可以看到IBM,谷歌是用150个比特的量子计算机。谷歌是用了152根线,我们把它降到49根线,可以把它降到很低,有时候成本可以降很多,同时这个方法架构的适应性也比较广,这是第一个工。
第二个工作就是这是natural physics今年的一篇工作。也是全世界第一次实现了我们在量子真机上实现QM,量子数据存储器相当量子内存。量子内存因为原来量子就是把数据加载,是所有的计算的模式都需要的工作,就是我要把所有的数据先load进来。load的传统方法的话就是那他的这个计算复杂度是ON的计算复杂度,QM可以使得降低很多,变成这个ON,为什么?是因为我们做了结构化的处理。原先数据直接加进来,直接进行表示。现在我们要按照一定数据结构来进行处理,因而可以把复杂度给它降下来。
但是面临的问题就是因为QM,我们内部表示可能是二叉树。但是我们量子的整个芯片,你可以看IBM的,可以看我们潘老师的,可以看浙大的,这些包括戴尔福特的。这些量子芯片它内部不是这种二叉树来进行连的,物理上它的微体结构可能是网格状的,或者像一个六边形的或者网格状等各种方式。另外的一个难点就是两个东西,数据表示和你的物理实现是不一样的,我怎么样做映射,这个是一个难点。
第二个就是噪声积累,噪声多了之后,做了几步之后,然后就出现各种错误,这是它实现的一个难点。为了解决这些问题,我们做了一些尝试,就是要做一定的优化,把我们的逻辑表示和你的物理表示要能够尽量近似。把你的物理整个体结构的特征来做。同时的话我们用了传态,用他的方法,原先是一个一个传,效率太低,我们用传态技术,代替IBM,可以使得我们整个计算的深度可以大幅降低,另外运用各种优化的技术可以大幅的降低。我们可以看到实验结果,我们和MIT相比,我们比MIT它整个路由的保真度,然后查询的保证度,整个计算复杂度,都有相关的提升。同时对于刚才讲的一个误差处理的问题,我们也找到了我们整个误差传播的这种规律。然后用规律使得我们整个寻址的速度、精度得到大幅的提升。
还有对整个分布式计算的,因为在量子计算它现在面临问题,这是同一个问题。同一个芯片上,你用的比特数越多,它的噪音降低特别多。在一个芯片用得比较少比特,主要是制造水平的限制。在这个限制情况下,一个芯片是不够的,差很远,因而我们要做分布式,怎么把一个复杂的电路怎么切得更加好,要保证通信的效率比较低,要保证精度算得出来,一系列的问题,这里我们也做了一些相关的问题,怎么切的问题,就是要对整个系统建模,然后找到一些规律,这个就是图的分割问题,怎么把它优化,怎么来干这个事情,这个方面也做了一些工作,我们和普斯顿芝加哥大学、阿贡实验室和他们相比,我们有了相关的一些提升。我们和这个相比,也有相关的提升,这是一个怎么切的问题,最关键的问题,怎么进行纠错是最关键的问题,纠错也是最难的问题。纠错方面我们也做了不少工作,原先的方法纠错,要么是快而不准,要么是准而不快。因为纠错是一个计算的问题,怎么办?所以这方面我们做了一些怎么快,提出一些方法,这些方法怎么来做,首先做离线做很多工作,把一个比较复杂纠错矩阵的预算,通过SMT的求解器,求出一个变换矩阵和一个值换矩阵,有了这个矩阵之,稀疏的矩阵,我们第二步在线的时候对矩阵进行分解,一小块一小块来算,把它并行化。并行化之后速度可以提升很多,所以这是第一步。
第二步我们把软硬件进行协同,就是设计针对我算法的硬件FBGI。这样可以大幅提升,我们在和最先进的相比,我们精度得到提升的,实现了8倍的到1.49倍的加速。而且进行实现叫1微秒以内的。因为我们的方法都在纳秒级。因为量子纠正时间推荐的时间是很快,微秒级,所以你要算的特别快才行。不然等你纠完错的时候,它已经过去了。有时候所以你的速度一定要求特别高,就是要到纳秒级,要到纳秒级的纠错,所以这是纠错的一个速度问题。
第二个是精度问题。针对我们精度问题,我们也做了相关的一些工作。因为精度问题就是存在量子的兼并性,量兼并性就存在着一个错误,可能是多个逻辑错误怎么来找的问题。怎么快?两周之后在希腊的工作,我们这方面也做了不少的工作。这方面工作也可以使得我们和IBM这些公司相比,和英伟达相比,我们在整个计算的解码精度,在线的延迟,一个计算的量。计算量可以大幅降低,计算量可以最多可以降17次方倍,因为原来没人干,所以我们去干了,存储量可以降2000倍以上,所以这是这个工作。
还有中性原子,因为现在中性原子现在是非常火。中性原子的问题就是我们原子会丢失,就算的过程突然原子找不到了,就是没了。那么怎么进行纠错?纠错我们怎么来做呢?我们就把中性原子的纠错,转化成我们经典那种这种纠错的模式,所以这方面也是今年micro的工作。这个工作当然有各种理论证明,我就不讲了。
这个工作相对于现在最新的,也可以使得我们整个的纠错时间。你可以看到,现在中性原子他们两百多微秒,一百多微秒,我们现在是37微秒,中性原子的时间可以放长一点,因为中性原子相干时间比较长,它可以做到1个小时,时间可以放比较长,所以时间做到微秒就够了。那超导不行,超导一定要做到纳秒级才行。
另外就是超融合这一块,因为在座各位都比较熟悉超智融合。但是量操作融合这一块,也仍然有不少的工作要做。量超融合,它不是一个简单的把网线一插,就融合的过程,那你要做深度的融合。深度融合是整个一个架构方面,刚才讲整个架构体系要做经典和整个量子做深度融合。
我们也这方面也做了不少的探索。第一个探索就是我们的架构上面,首先架构融合,架构融合的经典的计算,它是CPU和超导,比方说其他的一个量子计算机的控制板卡,是完全分开的,这种效率是比较低的。量子计算机本身不能独立工作的,它一定要和CPU配合在一起才能工作。我们可以看到,经典的开销占了92%,要解决一个问题,经典占了92%的,量子占了很小的一块。但是原先的架构是不行的,那怎么办?所以去年的伊斯卡上我们就做了一个工作,就是把两个东西深度融合,在片上就要做融合,不能在片间的做融合,那片间不行。所以在片上做了rose five,做了一个深度的融合。同时也做了,把我们流水线的技术用进去。用进去之后,使得我们整个效率大幅提升,可以看到我们整个具体的QIOI的算法,我们最高可以实现14倍的加速,15倍的加速。这是第一个工作,就是整个架构方面做了一个深度的融合。
第二方面,我们做的工作就是我们要调度层面上,调度层面上我们可以看到,就是说你例子可以看到,虽然量子计算机比较快,但是整体的执行不一定很快,就是因为涉及到整个编译反复的倒腾,就是CPU和KPU倒腾来倒腾去,你可以看到我们经典的案例,就是我们超算上一个我们跑8000个微秒,量子上跑了8300,就是说并没有快,就是因为他倒腾来倒腾去,那怎么办?所以要做整个倒腾的效率比较快。这方面我们也做了一些工作,主要是要找到哪些东西比较适合量子的,哪些东西比较适合经典的,然后少倒腾,这个方面就是HPC在2023年,也是我们第一次整个端到端的跑起来。第一次我们整个把量子和超算,整个端到端的跑起来,这样的一次尝试,这是最先进的方法相比,我们也有相关的提升。
另外就是我们整个的量子算法,要解决SIT的问题,怎么算法更快?这方面我们也做了很多的探索。比方说这个探索就是对整个对于我们提出一些方法,原先的一个搜索,我们都从大的一个空间开始搜索,从大到小,效率比较低。我们现在做的方法就从小到大,从一个点开始,我刚才讲的就是整个利用整个量子的优势,利用量子隧穿效应,让它从一个点逐步的往下跑跑到一个最优地方,各种算法的改进,所以是HCI今年的工作。
第四个做的工作就是我们量子和经典要做融合。你要进行评测,这工作到底好不好?性能评价。但是性能评价,原先都是做经典的,量子做量子的,经典做经典的,但没有做融合。那怎么进行融合?所以今年SC上面有篇工作就是讲怎么样做深度的融合工作,我们进行统一的日志的分析,统一的事件追踪,然后做了相关的一些工作。所以这是具体这个点上面的工作。
第三个我想讲讲就是面上面我们做了一些实践工作,我们把我们工作也做了一个平台,平台叫太原量子平台,这个名字叫太原。因为太原是盘古和太原,盘古的夫人,太原两个孩子一个阴一个阳,所以这是表示我们阴阳,表示太原。英文名字叫亚努斯。因为亚努斯是罗马两面神,那罗马两面神表示一正一邪,也是表示零和一的故事。所以说我们中文就叫太原,我们在2022年,刚才我讲的就是发布了第一个版本,平台当时一开始只是做整个云平台IDE,比较简单的这些工作。2024年,我们就是在s press做一个tota,发布到我们的2.0,2.0加了一些程序的量子程序的分析,优化的一些工具,这些东西都是都已经开源。包括用户、微软、信息大学华为、腾讯等这些单位。
2025年我们在HBCI做了一个tota,加了一些应用的东西,选址问题,路径问题,这是3.0,4.0我们今年上面,也做tota。主要是做一些刚才讲的分布式编译,存量的存储,组合优化方面等等做的一些工作,所以这是4.0。
同时我们也做了一个大的硬件,我们把CPU、GPU连在一起,把软件硬件做了一个深度融合。我刚才讲那个量操作融合不是说简单的连接线。要做很多深度的架构方面的整合,算法方面整合,调度方面整合。今年3月份,发布了一台这样的一台计算机。我们是因为9月份刚刚做好,为什么?因为太慢了,有时候也要走流程,要走那个流程,到现在才刚刚搞好。所以这是整个把量超制融合在一起,提供统一的这样的接口。这是同时我们也跑了不少应用。我们和中国移动,中国银行,包括金融方面应用,组合投资的组合优化这方面的一些工作,这些东西也都已经开源,我们可以看到一些开源的东西,可以下载。
连接是关键,因为你要做量操作融合,怎么把它连在一起是关键。英伟达去年12月份发布了evin Qlink,我们也做了一个类似的工作。我们目前,因为他卡我拿不到,但是我看到他一些技术指标。我们也做了一个测试。我们发现我们对标,在英伟达的卡我们延迟可以下降20%。我们可以到3微秒左右的延迟。而且我们实现了超导和超导,超导和CPU,超导和GPU,3个异构计算整个深度的互联,整个我们也做了一个学术方面探索。这个已经批了,我们和HPE想出一本期刊,那个就叫computer and software,明年3月份就会首开。也欢迎在座有兴趣的老师和专家学者去投稿,因为也是国内第一本,量子计算机和软件的国际期刊,同时我们也写了一本专著,已经交给了科技出版社出版,估计今年年底或者明年年初就会出版这本书。我们团队都还比较年轻,基本上都是年轻人为主。除了我年龄比较大一点,其他都是比较年轻的。他们都是原来的华为的天才少年,到了我们团队,做整个量子计算的探索。现在大致也有一百多研究生,一百左右的研究生一起来做工作。同时,我觉得作为一个老师,还要做一些科普工作。所以我最近写了一本科普书,当然讲了一些基本的认知和观点的,主要是做的一些计算机的,刚才讲的计算机的本质,计算的一些思维,这方面的一些工作。飞曼讲了一句话,他讲大自然不是经典的,如果你想模拟大自然,你最好把它变成量子计算。我觉得我们量子计算的本质,就是因为有可控的物理过程,然后来模拟另外一个物理过程。因为我们很多经典计算,实际上我们把所有的计算都要变成0和1。变成0和1之后然后再回去来算,这个效率可能不一定很高。我们需要用另外一个物理过程,然后来模拟另外一个物理过程,这样可能效率会比较高。老子讲道法自然,量子计算的根本本质,它也是用一个道法自然的过程。
更多技术话题,欢迎扫码海报二维码
报名2026中国数据与存储峰会