ARTICLE · 1294373
AI真能看懂身体动作吗?能分清左右手、数对动作次数吗?从动捕到体育大模型|体育周报
体育AI前沿 · 2026.10.25—10.31
识别出一个人正在运动,距离看懂他怎样运动,还有多远?能分清左右手、数对动作次数,又是否意味着模型已经能分析技术、给出训练建议?
本周,我们沿着三个问题看进展:模型怎样理解身体,体育语言模型怎样训练与评价,普通视频怎样可靠地测量人体运动。SOMA、Keepace、UT-HMR与Fall2D分别提供了可借鉴的评测、训练和验证思路;其中有新问题,也有现有方法的改进与应用验证。
模型看懂身体,具体要会什么?
能分清左右手、数对次数,才算看懂动作吗?arXiv预印本 · 2026-10-26
SOMA把摄像机佩戴者的第一人称视频交给多模态大模型,询问用了哪只手、双手怎样配合、动作重复几次,以及事情发生的先后。完整身体常常不在镜头里,模型需要结合手部、镜头移动和前后事件作答。它提供的是一套身体动作理解测试,并非新训练出的体育大模型。
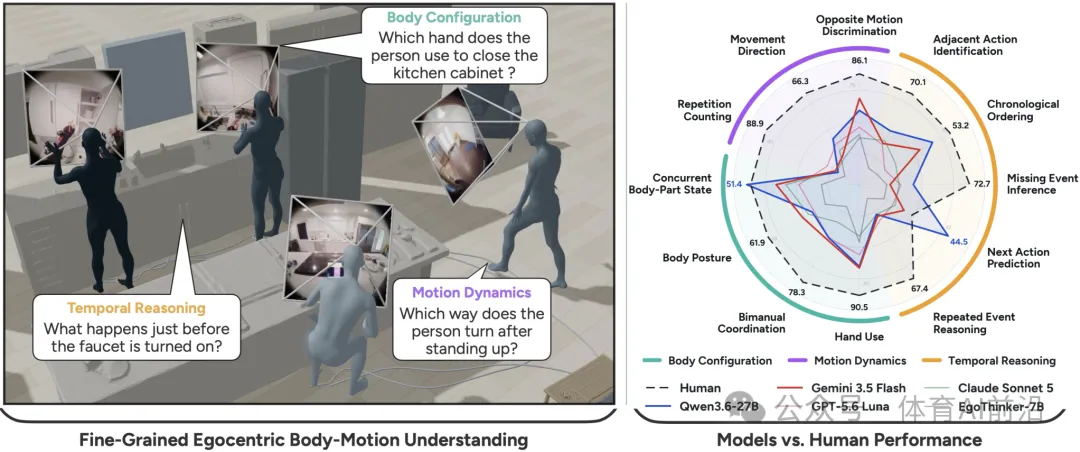
图1|SOMA把身体理解拆成姿态、运动和时间关系。右侧雷达图为便于展示作了归一化,不能直接当作原始准确率。 论文原图
为什么关注 这篇最值得体育科研借鉴的是怎样出题:把“模型懂运动”拆成能逐项检查的能力,而不是只让模型泛泛描述一段视频。
怎么做的 作者设置12类任务,整理397个源视频、1611个片段和1632道问题,测试37个模型;还筛除部分不看视频、只凭文字也能答对的问题,减少模型靠题目措辞猜答案的机会。五名人类评测者承担对照评测,不代表数据集只有五名参与者。
结果怎么看 题目经过人工审核,并比较不同输入条件。附加动作信息带来的提升约为半到一个百分点,说明“给模型更多动作信息”还没有转化为明显的能力跃升。人类与模型观看的帧数和时间预算也不同,差距不能全部归因于身体理解能力。
我们的看法 它的新意主要在评测设计。四选一题答得好,并不能证明模型会开放式分析技术动作或指导训练。若要做体育专项版本,最值得继续读的是左右肢体、计数、时间关系的出题方式,以及模型具体错在哪里。
首位作者:Matea Tashkovska;EPFL Mathis团队,长期研究行为分析与感觉运动建模。文首列Alexander Mathis联系邮箱,未明确标记通讯作者。
SOMA: A Benchmark for Fine-Grained Egocentric Behavior and Body-Motion Understanding
arXiv: 2610.36384
体育大模型怎样给出训练建议?
看懂画面中的动作,与根据个人条件给出训练建议,需要不同的能力和评价方式。接下来这项工作,把关注点转向体育语言模型的训练数据、具体任务和回答质量。
体育大模型,怎样学写训练计划?arXiv技术报告 · 2026-10-28
Keepace把通用语言模型调整为中文体育与健康助手:根据目标、器材、时间和运动背景生成训练课程,回答体育知识问题,并解释用户提供的运动日志。它处理的是文字与日志任务,不是从比赛录像中识别动作。
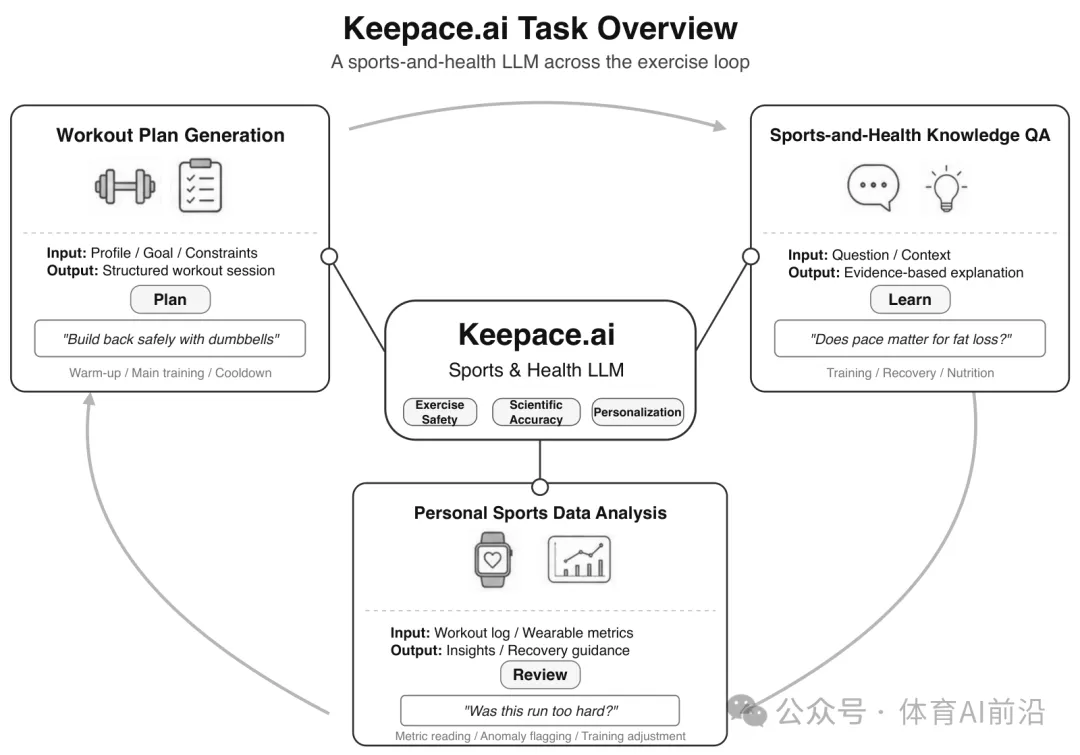
图1|Keepace的三类任务:制订训练计划、解释体育知识、分析运动日志,分别连接训练前、训练中与训练后的需求。 论文原图
为什么关注 适合用来拆解体育大模型的工程路线,尤其是领域训练数据和评价规则怎么做;目前的成绩主要反映回答质量,还没有证明能改善真实训练效果。
怎么做的 报告基于Qwen3.5-27B,先用约20万条领域例子训练,再用4000对优劣回答调整偏好。三类任务各用100条提示测试,专家每类核验30条回答。这些数量是文本训练和测试材料的规模,不是参加训练干预的人数。
结果怎么看 作者把课程结构、专业要求和个性化等要求拆成细项,便于检查模型回答究竟改善在哪里。但评价主要来自内部规则和自动评分,尚缺独立外部用户验证。
我们的看法 它是在通用模型上进行体育领域训练,贡献主要落在数据与流程设计。做自己的项目时,可以借鉴任务拆分和评分表,同时准备独立测试题与专家复核;回答更像专业教练,与建议实际有效、安全,仍是两件需要分别验证的事。
署名首位:Keepace.ai Team;通讯作者:Bowen Wu、Kun Li。材料展示产品与领域任务取向,尚无已核实的逐人机构对应及独立实验室背景。
Keepace.ai: A Technical Report on a Large Language Model for Sports and Health
arXiv: 2610.38249
普通视频,能把人体运动测准吗?
无论分析动作还是解释运动日志,输入的运动数据是否可信,都值得单独追问。先看转播画面中的三维人体重建,再看二维骨架推导出的速度怎样验证。
运动员被遮住了,前后画面能帮多少?arXiv预印本;作者自报WACV 2027接收 · 2026-10-26
UT-HMR尝试从冰球、足球转播的完整画面中,恢复多人的三维人体形状和姿态。远处运动员很小,又有遮挡和模糊,单帧容易产生多个看起来都说得通的姿势。它在已有SAT-HMR方法上,结合相邻三帧画面,并在训练时降低不可靠关节的监督权重。
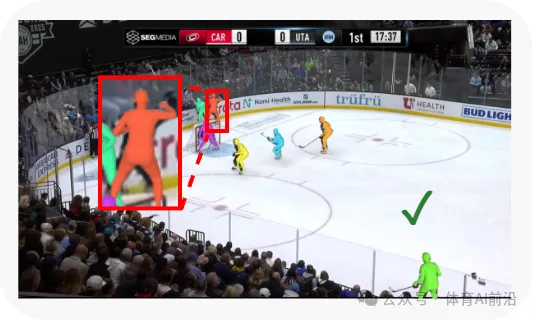
图2局部|UT-HMR在体育画面中的三维人体重建结果。可视化用于说明输出形式,测量是否准确仍需独立验证。 论文原图
为什么关注 这是一项问题明确的方法改进:同时利用时间线索和关节可信程度处理重建歧义。它值得学改进思路,但贡献属于现有框架上的增量。
怎么做的 冰球数据来自24场NHL比赛,另在WorldPose和3DPW上测试。作者用相同基础网络作对照,并分别移除新增组件检查作用;独立人数、样本计数和按比赛划分的细节仍未报告。
结果怎么看 体育场景主要用算法生成的参考姿态评估,结果支持重建基准上的改善,不能直接当作真实关节运动测量精度。方法需要未来帧,耗时也高于基础版本,不能从三帧输入就推出适合实时部署。
我们的看法 值得继续看各组件的单独收益,以及训练、测试是否充分隔离。如果目标是生物力学或技战术测量,还需要独立参考系统和下游任务验证;重建画面更合理,并不自动说明关节角、速度等指标测得更准。
首位作者:Zhibo Wang;滑铁卢大学,合作者David Clausi所在VIP团队持续开展冰球视觉研究,并与Stathletes合作。本文未明确标记通讯作者。
UT-HMR: Uncertainty-Guided Temporal Modeling for Robust 3D Human Mesh Recovery
arXiv: 2610.36203
UT-HMR关注怎样在困难画面里恢复人体姿态。另一个同样实际的问题是:拿到骨架轨迹后,推导出的运动指标与参考测量究竟差多少?Fall2D用受控实验检查了这一点。
二维骨架识别出来了,跌倒速度就测准了吗?Scientific Reports · 2026-10-29
JCR Q1(2025,综合学科) · 新锐3区(2026,综合性期刊) · IF 4.9(2025)
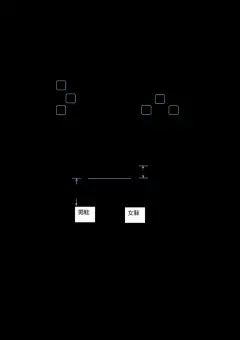
这项研究把同一批受控跌倒录像交给人工流程和五种AI配置,从髋部轨迹计算速度,再与光学动捕比较。作者还分开检查前向、后向和侧向跌倒,观察方向与参考位置怎样改变工具表现。
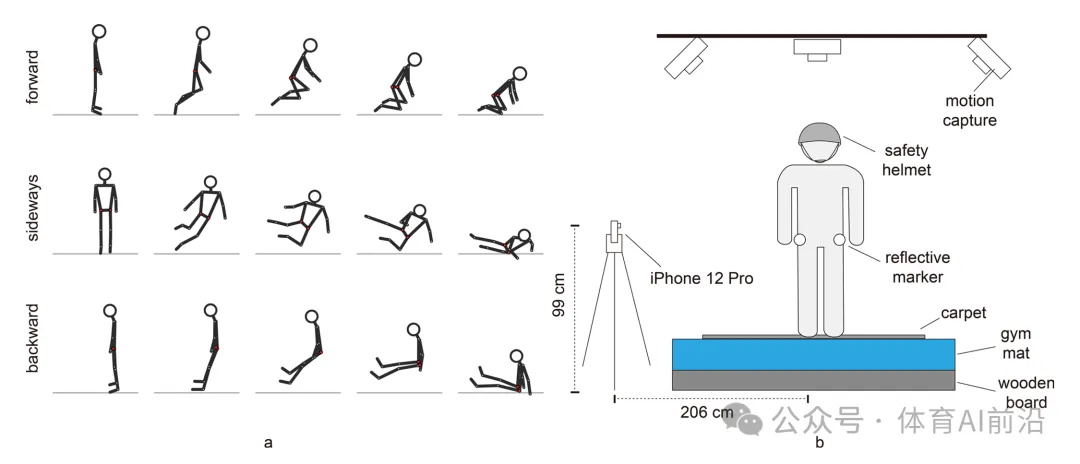
图1|左侧为前向、侧向、后向跌倒示意;右侧为手机与光学动捕的实验布置。原图取自出版方先行版PDF第3页。 论文原图
为什么关注 它没有提出新网络,却对使用2D骨架做测量的体育项目很实用:提醒我们同时检查关键点位置、标尺、同步和速度计算,不能只看骨架画得像不像。
怎么做的 研究纳入18名健康青年,计划采集324次跌落、432条轨迹;排除后保留319条轨迹,能完成全部方向比较的是15人。重复轨迹增加了测量次数,并没有增加独立参与者。
结果怎么看 优点是有光学动捕参考,并按方向分析一致性。局限在于不同工具的髋部解剖定义可能不一致,参考系统遮挡又导致较多轨迹被排除,复杂场景的表现可能比保留样本更差。
我们的看法 本文应定位为应用测量验证。健康青年的受控跌倒,尚不能代表老年人的自然跌倒或比赛落地;髋部速度也不是冲击力。做项目时,先借鉴它的参考点定义和分方向验证,再决定是否换姿态模型。
首位作者:Kitaek Lim;通讯作者:Woochol Joseph Choi;延世大学物理治疗系伤害预防与生物力学实验室。实验室方向与本文测量任务相符。
Validation of 2D video-based movement analysis tools for assessing human fall impact kinematics
DOI: 10.1038/s41598-026-77806-w
还有这些研究,可以留意
下面按研究方向简要介绍。部分工作目前依据公开摘要介绍,具体限制随条目说明;小样本原型侧重提供问题与方法线索。
姿态和运动数据,怎样获取得更可靠?
少标注的二维姿态训练,能从肢段得到什么帮助?Sensors · 2026-10-29
JCR Q2(2025,仪器仪表、分析化学、电气与电子工程) · 新锐3区(2026,综合性期刊) · IF 4.0(2025)
在既有半监督框架中增加肢段表示,让关键点与肢段互相校正,部署时移除辅助网络。8847张图来自201个源视频,独立人数未报告;有相同基础网络对照和消融,相对相近方法提升约1.6个百分点。属于有借鉴价值的监督机制增量,尚缺外部数据验证。
DOI: 10.3390/s26216833
从少量关键点补到解剖标记,体育动作迁移还差在哪里?Multidisciplinary Biomechanics Journal|会议论文集短文 · 2026-10-26
以11名男性、6类体育任务、4机位视频及同步有标记参考,检查既有补点模块;43个推断标记中,31个共同标记参与比较。对OpenCap类项目的价值在分动作、分部位找误差,而非新算法。标记位置误差也不能直接当作关节角误差。
DOI: 10.46298/mbj.19194
把多视角二维关键点直接用于三维状态估计Multidisciplinary Biomechanics Journal|会议论文集短文 · 2026-10-26
通过身体模型在图像上的投影误差与关键点可信程度,更新三维运动状态。8台相机只验证了一名参与者、14.55秒、5个转体空翻的试次;这是单次演示。可研究滤波怎样处理左右混淆和异常点,尚不足以支持跨人稳定性或全流程实时性。
DOI: 10.46298/mbj.19188
高速变向的无标记动捕:关节不同,误差也不同Multidisciplinary Biomechanics Journal · 第51届生物力学大会相关短文 · 2026-10-25/26/27(来源日期冲突)
4名有橄榄球经历的成人、39次试次,对比商用系统与有标记参考。髋部误差明显;主表最高归一化误差116.5%,与正文最高80%的说法不一致。适合作为复杂动作测量的警示案例,没有伤病结局,不能据此判断ACL风险识别已经可靠。
DOI: 10.46298/mbj.19198
QuEst:先判断哪路信号可信,再融合超声与惯性数据MobiCom 2026 · WiP研究进展短文 · 2026-10-26
用物理先验估计信号质量,调整不同传感信号与时段的融合。摘要报告相对前作参数量减少87%、计算量减少72%,但尚未核对参与者、姿态误差和实际耗时。它是4页研究进展短文,适合关注方法想法,不能据此认定精度、速度和功耗都占优。
DOI: 10.1145/3795866.3844736
手机+腕部传感器采集扣球,先解决数据丢失公开预印本(平台名称尚未核实) · 2026-10-27
低成本排球采集方案在12名球员、139次扣球中试用。腕部流135次分析仅42次可用,故障主要指向蓝牙链路。可借鉴现场记录与同步经验;视频采集成功不能代替整个系统可靠,更不能证明角度和速度已经测准。
DOI: 10.31224/8613
球与球员的运动,怎样从视频中还原?
Volley3D:借击球接触点,重建球与球员的三维运动arXiv预印本 · 2026-10-28
从单目排球转播出发,把球员跳跃、球轨迹分段与手部接触点结合起来。接触点提供了几何约束,对球轨迹研究很有启发。本期依据公开摘要介绍,尚未核对米制误差、相机假设和独立比赛测试;迁移到羽毛球还要调整飞行模型。
arXiv: 2610.38358
球员最快何时能到位?从比赛跟踪数据学习可达时间arXiv预印本 · 2026-10-26
利用2022世界杯64场比赛的跟踪数据,学习较短的可行到达时间,为球场空间控制分析提供模块。亮点是把“通常怎么跑”与“有可能多快到达”分开。当前仅依据摘要介绍;比赛隔离、物理约束和跨项目稳定性尚需完整实验支持。
arXiv: 2610.36183
网球落地与击拍检测,换个机位还有效吗?arXiv预印本 · 2026-10-27
8段视频、345条事件,用来比较轨迹、姿态规则与视觉语言模型。三个手机或场边片段中有两个用于规则调参,不能当作独立泛化测试。本期依据摘要,最有用的是提醒球轨迹项目单独测不同机位和接触时刻,而不是把高分当成熟方案。
arXiv: 2610.38042
第一视角网球:从看见球,到预测下一次触球arXiv预印本 · 2026-10-27
将球、人、未来轨迹和触球时刻拆成七类任务,并接入动作生成。数据明确只有一名第一视角专家球员,含85个活跃回合、约29.6分钟;同步外部视角的采集设计值得参考。球位置约半米量级误差,尚不能当作鹰眼精度或跨球员通用理解能力。
arXiv: 2610.37619
体育模型的成绩,怎样才有解释力?
MoveBench:训练建议的科学性、安全性,怎样分别打分?arXiv预印本 · 2026-10-25
对15个模型设置809道问题、5012条评分规则,把知识问答与合适的训练建议分开评价。可借鉴的是细分评价要求,而非直接照搬总榜。本文本周更新,首次公开为10月19日;本期依据摘要与项目介绍,尚未核对题目污染、专家一致性等细节。
arXiv: 2610.26185
从跑姿识别睡眠剥夺:熟悉一个人,不等于适用于新人Frontiers in Bioengineering and Biotechnology · 2026-10-30
JCR Q1(2025,出版方汇总,未分学科) · 新锐2区(2026,生物学) · IF 5.8(2025)
21名跑者在正常睡眠与完全睡眠剥夺条件下配对测试。最佳个人条件分类中,可穿戴与动捕分别为84%和81%,跨人结果多接近50%。本期依据原始摘要,值得记住的是个体基线与跨人泛化的差距;完全睡眠剥夺也不能直接代表日常疲劳。
DOI: 10.3389/fbioe.2026.1939545
罚球技术分类的高分,会不会其实来自身高?BMC Sports Science, Medicine and Rehabilitation · 2026-10-30
JCR未核实 · 新锐3区(2026,医学) · IF 3.4(2025)
20名男性篮球爱好者分两组,融合分类结果为0.75,仅用身高为0.85;在训练折内去除身高关联后,融合结果降至0.50。本期依据摘要,这个阴性结果对实验设计很有价值:模型可能分清了身材,未必学到了技术差异。
DOI: 10.1186/s13102-026-02211-9
EpiCoach:先写下训练预测,再用个人数据检验arXiv预印本 · 2026-10-29
让训练智能体预先登记可检验的预测,并保留纠错记录。材料来自一名山地车运动员的18个月回放,前瞻三周登记20条预测,其中14条已有评分;没有显示智能体优于静态模型或改善骑行表现。单人研究可用于探索个体规律,这里更值得借鉴的是验证流程。
arXiv: 2610.40370