ARTICLE · 1294931
当 AI 开始改进“改进本身”:HyperAgents 与元认知自改进
当 AI 开始改进“改进本身”:HyperAgents 与元认知自改进
DGM-Hyperagents:把任务智能体和元智能体缝进同一个可编辑程序
这个系列写到现在,达尔文·哥德尔机器(DGM)已经出现过很多次:从一个编码智能体出发,反复生成自己的变体、跑测试、把成功的版本存进档案库当垫脚石,最终在编码基准上越爬越高。它是"开放式自改进"的第一个可复现实例。
但 DGM 有一个很少被挑明的前提。它内部有一个"元级机制"——分析历史表现和当前代码库、生成"下一步该往哪改"的指令——这一步是手工写死的,论文附录里就是一段固定的提示词。系统里的一切都可以进化,唯独"指挥进化"的那一小块是常量。
这个被写死的机制长什么样?论文附录里贴了原文:把智能体的代码、运行日志、正在解决的 GitHub 问题和它生成的补丁一起塞进一段固定提示词,要求模型"找出一个能提升编码能力的具体改进方案"。也就是说,DGM 的每次自我改进,都被这一段提示词的想象力和格式所限定——它看不见代码库之外的改进空间,也不知道除了"改代码"之外还有别的改进方式。
更隐蔽的是第二个前提:在 DGM 里,评估任务和自我修改都是编码任务,所以编码能力的提升会自动转化为自我修改能力的提升。论文把这种巧合称为"对齐"。一旦换域就露馅——如果评估任务是写诗,提升写诗能力并不会让它更会改自己的代码。想在非编码域自改进,要么给每个域手工重新定制元机制,要么再架一层"改进元智能体的元元智能体"——后者只是把问题往上推,陷入无限回归。
出路只剩一条:让系统真正自指——能分析、修改、评估它自身,包括修改"修改机制"本身。
这是 DGM 原班人马(Jenny Zhang、Jeff Clune 等,联合 UBC、Vector 研究所、爱丁堡、纽约大学与 Meta)给出的答案:超智能体(hyperagent)。把任务智能体(解题的)和元智能体(改智能体的)缝进同一个可编辑程序,元级修改流程本身也在被修改的范围内——论文称之为元认知自修改(metacognitive self-modification)。
这里的"智能体"定义得非常宽:任何可计算程序都算,可以调用基础模型、外部工具或学习出来的组件,不限于提示词或神经网络。这一定义让"自改进"摆脱了表示形式的束缚——改提示词、改代码逻辑、加记忆模块、换控制流,统统都是合法的自我修改。四个实验域也刻意拉开了差距:编码是纯文本任务,论文评审要求结构化判断,机器人奖励设计要写出能编译、能训练的奖励函数,数学评分则要给出 {0, 1, 6, 7} 四档的严格分级。
在 DGM 的档案库里,存的是"改进过的编码智能体";在 DGM-H 的档案库里,存的是"改进过的改进系统"。保留开放式探索的骨架不变,但元级机制从常量变成了变量,"评估任务与自我修改必须对齐"这个假设就不再需要了。
运行流程与 DGM 一脉相承:从档案库里选父代、分支、自我修改、评估、回填档案。变化发生在"自我修改"那一步——原版 DGM 里它由固定提示词驱动,DGM-H 里它由元智能体自主决定:改哪里、加什么模块、要不要重写评估逻辑,都由系统自己拿主意。进化树上的每个节点,既是被改进的对象,也是改进能力的载体。
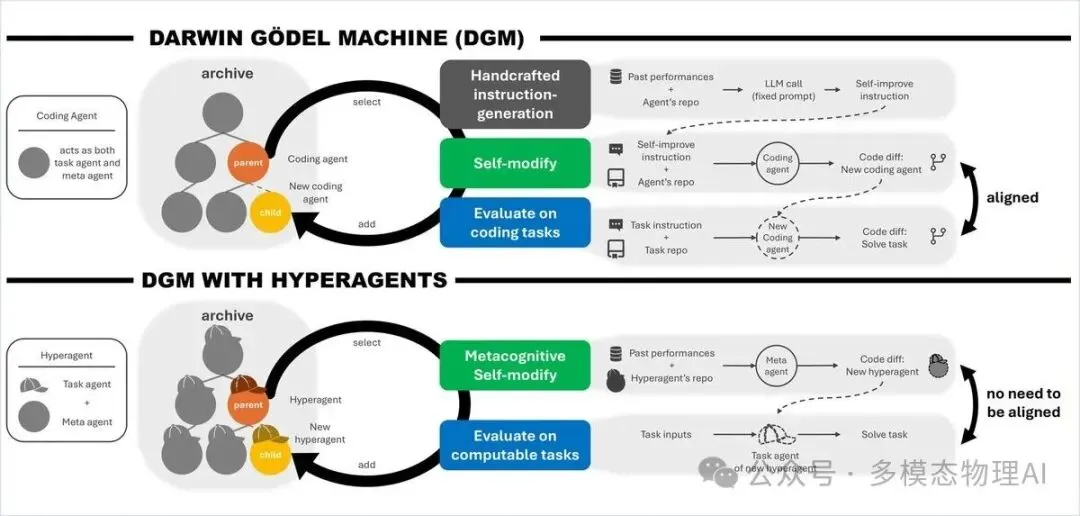
上:原版 DGM,编码智能体既当选手又当教练,指令生成机制手工固定;下:DGM-H 把任务与元级机制合成一个可修改的超智能体(原文 Figure 1)
论文给了一张概念对比图,四行正好是这条演化路径的四个阶段。第一行,原版 DGM 在编码域:评估和自我修改都是编码,对齐成立,可以自我加速。第二行,把 DGM 原样搬到非编码域:评估不再是编码,对齐断裂,任务成绩再高也喂不进自我修改环节。
第三行,DGM-custom:把指令生成机制逐域手工定制,成绩上去了,但机制本身仍不可修改,依旧不能自我加速。第四行才是 DGM-H:任务与元级机制合体,不再需要对齐——因为"生成改进的机制"自己就在改进。
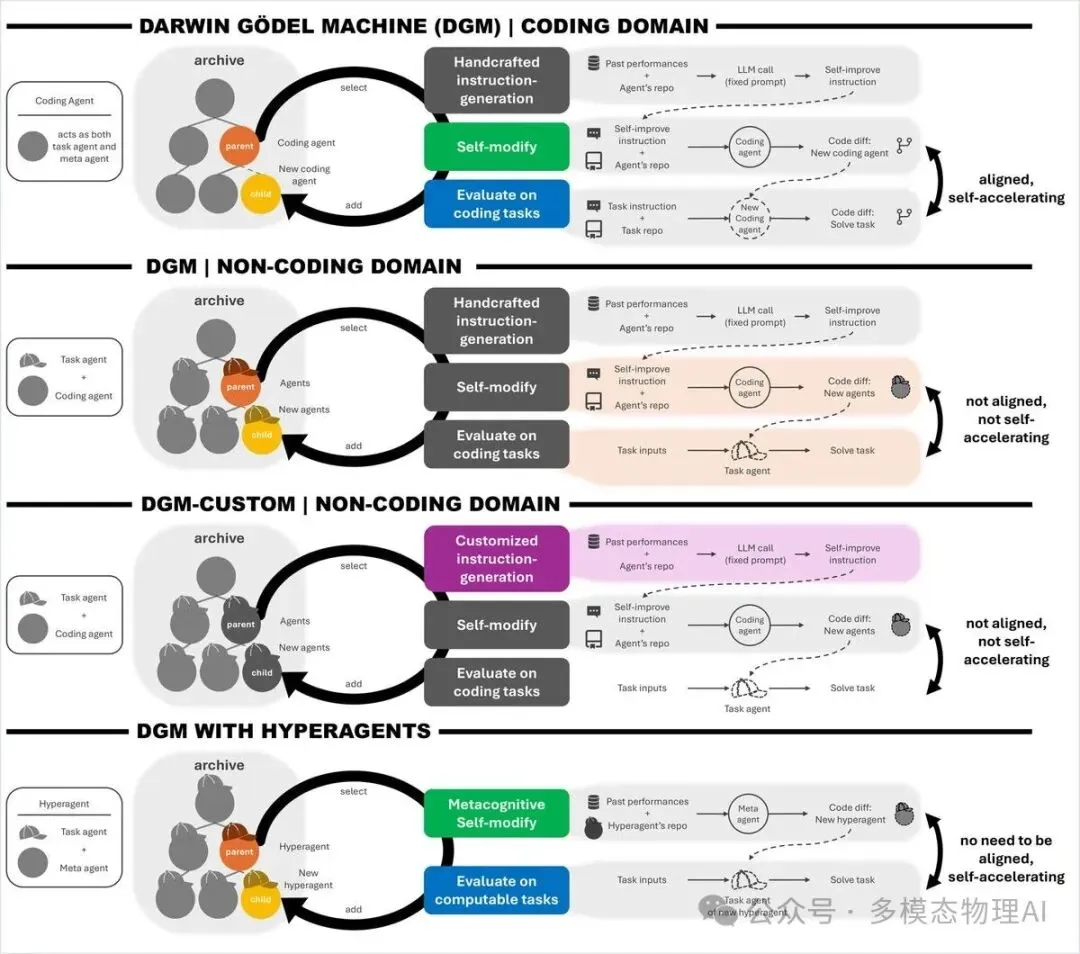
四个阶段:编码域对齐 → 非编码域对齐断裂 → 手工定制但仍不自我加速 → 元认知自修改、无需对齐(原文 Figure 5)
实验横跨四个域:Polyglot 编码、论文评审、机器人奖励设计,再用国际数学奥赛级别的解答评分做迁移靶。有个设计细节值得注意:同时优化两个域的运行里,任何一个域的分阶段评估失败,另一个域也直接计零分——刻意逼系统两头都顾,杜绝"牺牲一个域刷另一个域"的投机。先看编码:DGM-H 完全没有为编码做任何专门设计,成绩却与原版 DGM 相当——训练子集从 0.140 提到 0.340(DGM 为 0.380),在 165 个未见任务的全集上从 0.084 提到 0.267(DGM 为 0.307)。
真正的分水岭在另外两个域。论文评审任务里,初始智能体连输出格式都不对,得 0 分;原版 DGM 照搬过去还是 0 分;逐域手工定制的 DGM-custom 拿到 0.590;而 DGM-H 从 0 一路爬到 0.710,超过了开源静态最强基线的 0.630。机器人奖励设计里,DGM-H 从 0.060 提到 0.372,连"直接优化评估指标"的默认奖励函数(0.348)都被它超了。
消融实验回答了"功劳归谁":去掉元认知自修改,成绩掉回 0.0 与 0.213;去掉开放式探索,掉回 0.0 与 0.116——两个组件都缺一不可。值得注意的是,这些成绩都是测试集分数,提升来自泛化能力而不是刷训练题。
比分数更有意思的是改进的"质感"。论文观察到,DGM-H 早期的修改是表面功夫——比如给评审智能体加一个"请保持严谨"的人设提示词;越到后期越走向结构化的决策机器:多阶段评估流水线、带明确触发条件的否决清单、约 40%/60% 的显式阈值、边界情况默认拒绝的决策协议。在机器人域,它则逐步搭起一份环境知识库:记录合法的状态变量、环境约束和奖励缩放经验,编译失败率被一点点清零。从"调提示词"到"造决策机器",这个跃迁是系统自己完成的。
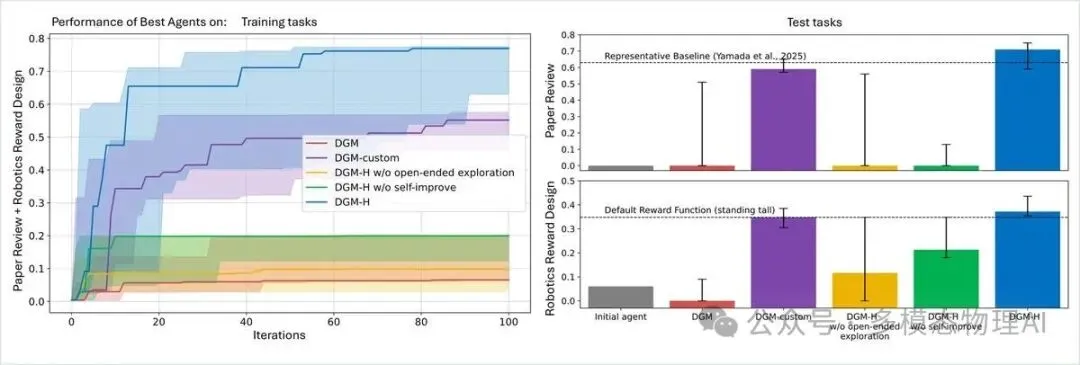
左:同一轮运行内同时优化论文评审与机器人奖励设计的训练曲线;右:测试集上与各基线对比,DGM-H 全面领先(原文 Figure 2)
成绩好还不能说明"元级改进"真的通用——也可能只是在每个域里各自刷题。论文为此定义了 imp@k 指标:固定元智能体不动,只让它生成 k 个新任务智能体,看最好那个比起点提升多少。靶域是全新的国际数学奥赛评分任务:给一道奥赛题的候选解答,按 {0, 1, 6, 7} 四档打分,分别对应错误、部分正确、接近正确、完全正确,与专家人工标注比对算准确率。对系统来说这是一个从没见过的题型、评分体系和输出格式。
前三行全是 0:初始元智能体不会育人,从 DGM-custom 里迁出来的元智能体换个域同样束手无策。只有最后一行——从 DGM-H 里迁出来的超智能体——在从未见过的域里拿到 0.630 的提升。差别在哪?论文解剖了迁移智能体,发现它们自主长出了两类通用设施:
性能追踪——一个自己写的记录器,跨代记录每次修改的分数、算滑动平均趋势、判断哪些改动带来持续收益、哪些在退步;持久记忆——不只存分数,还存归因结论和下一步计划,比如"第 55 代准确率最高但太严,第 64 代平衡更好,下一步把两者的优点合并",甚至能诊断出"第 65 代改过头了,第 66 代回调"。继承下来的是"会改进"这件事本身,不是某个任务的答案。
数学评分域的案例研究把这个过程拍成了慢镜头。第 3 代,智能体还只是把评分标准逐条列出来让模型对照——典型的行为式提示;到第 39 代,它已经转向结构化推理:先独立解一遍题、再逐步核对候选解答的每一步、按预定义的错误类型归类扣分。从"照着评分表打分"进化成"像阅卷人一样推理",而且这些策略都是自动发现、自动验证的,没有任何人告诉它该这么改。
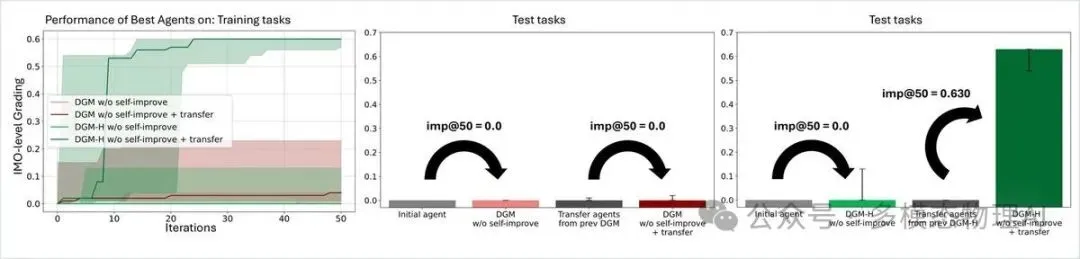
imp@50 迁移实验:只有从 DGM-H 迁出的元智能体能在新域里稳定生成更强的任务智能体(原文 Figure 3)
如果学到的改进策略真的通用,它们应该能像复利一样跨运行累积。实验把之前跑出来的迁移超智能体当作新起点,在数学评分域继续进化 200 轮:从迁移起点出发最终 0.640,从零开始 0.610——差距不算大,且未过统计显著性检验,但论文指出在 0.6 以上的高位区间,每一点提升都比从 0 到 0.1 难得多,饱和区间的增益是有意义的。而且左图里迁移起点收敛明显更快,几十轮就摸到了从零起点跑一百多轮才到的位置——省下的探索预算,就是过去学到的经验。
更漂亮的是"站在强者肩膀上"的版本:以开源强基线 ProofAutoGrader 为初始任务智能体,配上迁移元智能体,200 轮后测试分 0.700,超过了 ProofAutoGrader 本身的 0.670;在完整评分基准上,把它的准确率从 0.561 提到 0.601,平均绝对误差从 0.178 降到 0.175。系统能在现成的强方案上继续改进,而不是推倒重来——这是"可累积"最直接的证据。三组起点放在一张图里看非常直观:从零出发、带着经验出发、站在最强者肩膀上出发,终点一个比一个高。
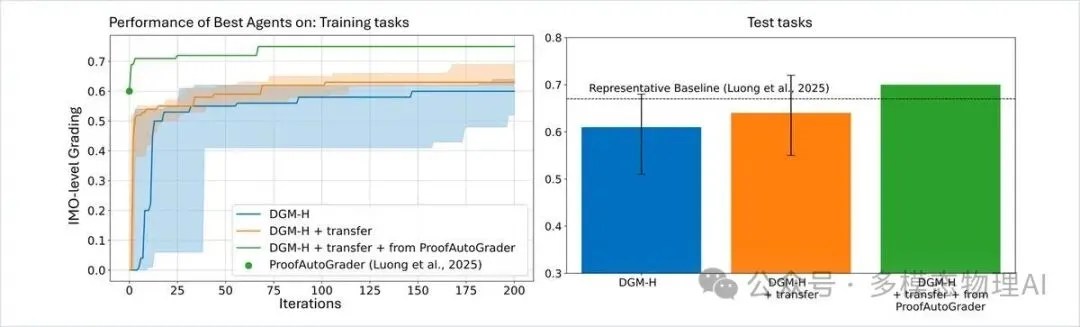
左:从迁移超智能体出发收敛更快、终点更高;右:配上 ProofAutoGrader 起点后超过代表基线(原文 Figure 4)
机器人奖励设计任务里藏着一个局部最优。目标是让四足机器人的躯干尽可能高,默认奖励函数直接最大化躯干高度,于是机器人学会了一个取巧动作:站直不动——高度确实最大,但那不是设计者想要的运动能力。
DGM-H 自主生成的奖励函数几乎总能诱导出跳跃行为,真正提升了运动能力;而 DGM-custom 生成的智能体常常困在"站立"这个局部最优里出不来。同一个底座模型,差别只在元级机制可不可改——元认知自修改的表现开始追平甚至超过逐域手工定制。这个案例也是给所有"调奖励/调指标"的人提了个醒:被你直接优化的那个数字,往往就是系统学会钻的那个空子。
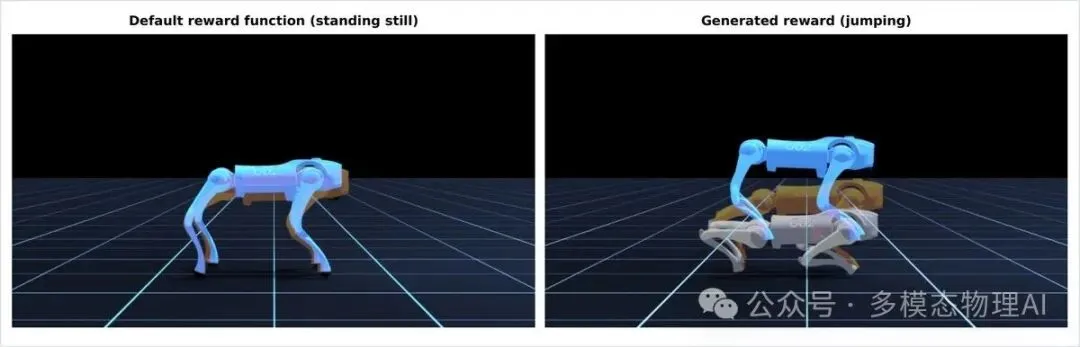
左:默认奖励函数下机器人站立不动;右:DGM-H 生成的奖励函数诱导出跳跃行为(原文 Figure 6)
论文对自己的局限说得很诚实。其一,任务分布是固定的:四个域都是人预先选好的,系统还不能自己出题、自己扩课程表。其二,外层循环仍然固定:档案库里谁被选为父代、用什么样的评估协议,这些决定"进化如何进行"的规则依旧不可修改——为了实验稳定和安全刻意保留。初步结果显示外环也可以放开,但那将是下一步的事。
安全部分值得认真对待:所有实验都在沙箱里跑,代码执行有资源上限、断外网、全程人工监督,评估也只用预定义的任务和指标。但作者明确警告,开放式自改进系统的进化速度可能超过人类审计与解读的能力——当系统改得比人看得快,"事后审计"就会失灵。与其等出事再补课,不如现在就把信任、监督与透明度的边界摆上桌面讨论。这也是整个系列反复出现的主线:能力每一级台阶,都需要配一套新的护栏设计。
放进这个系列的坐标里看:上一篇总纲《The Last AI Built by Humans》把自改进分成五级,越往上越接近"改进机制本身可进化"。HyperAgents 正是把第四、五级的方向做成了可复现的工程实践——不再满足于搜索更好的解,而是持续改进"搜索改进"的能力。瓶颈从"某个任务做不好"上移到"改进的机制是什么样",这可能才是通用自改进真正该卷的地方。
当然要泼一盆冷水:所有实验都是研究尺度的,域的数量、每次运行的轮数、底层模型的调用成本都还有明显约束,"任何可计算任务"目前是能力边界而不是实测清单。真正的看点在于方向——元级能力的改进是可以携带的资产,而任务级的成绩是逐域重付的成本。哪边积累得快,长期天平就倒向哪边。
你所在的工作里,最该被改进的,是不是恰恰是"你用来做改进的那套流程"?评论区聊聊。觉得有用就点个在看,系列下一篇见。