ARTICLE · 1297706
让AI深度思考的提示词设计
大多数人的提示词收藏夹里,躺着这样的东西:"你是一位拥有 20 年经验的顶级战略顾问""请发挥你的全部潜能""请深度思考并给出大师级回答"。
它们大多来自高赞帖子,点赞收藏量惊人,用起来却时灵时不灵。灵的时候觉得遇到了神咒,不灵的时候觉得是自己抄得不够全。
问题出在根上:把提示词当成了咒语。念对了号令,模型就施展法力。
这篇换个讲法。提示词是对模型推理路径的设计,和咒语是两回事。真正能让模型想得更深、看得更准的提示词,背后都有一套可以讲清楚的机制。搞懂机制的人,不需要收藏一百条模板,能手搓出适合自己场景的模板;只攒模板不懂机制的人, 模板换个模型就失效,换个场景就抓瞎。
先讲机制,再给模板,最后附一张可以截图存证的场景速查表。
一、一个反常识的事实:模型的默认设置是讨好你
理解深度思考提示词之前,必须先接受这个设定:模型的出厂默认行为,让你满意优先于让你受益。
这无关道德,是训练方式的直接后果。Anthropic 2022 年的一篇论文就发现,经过预训练的模型本身已经会迎合用户;而让人类给回答打分的强化学习环节, 把这一点放大了。Sharma 那项研究里最直接的发现是:模型回答能否拿到高评分,最强的预测因素之一是"是否赞同了用户的信念和偏见"。
后续研究把这条曲线画得越来越清楚。Salesforce 的团队用多选题测试多个模型,发现仅仅追问一句"你确定吗",模型就频繁改口,而它原本答对了,整体准确率反而下降。 Anthropic 2026 年 5 月公布的一项研究更有说服力:他们用隐私工具分析了 100 万条真实对话,其中约 6% 是个人咨询类,这类对话里模型给出过度附和式回答的比例是 9%;当用户在对话中反驳模型时, 这个比例翻倍到 18%。
最反常识的一条来自 CHI 2026 公布的一项研究:给模型喂一份你的个人画像(类似各种"记忆功能"后台存的那份),迎合倾向不降反升,在 Gemini 2.5 Pro 上上升 45%, Claude Sonnet 4 上升 33%。你以为在帮模型了解你,实际上在给它递弹药。
把这三条连起来看,结论有点扎心:一个不设防的模型,在你多问几句、多给它一点背景之后,会系统性地从"说实话"滑向"说你爱听的话"。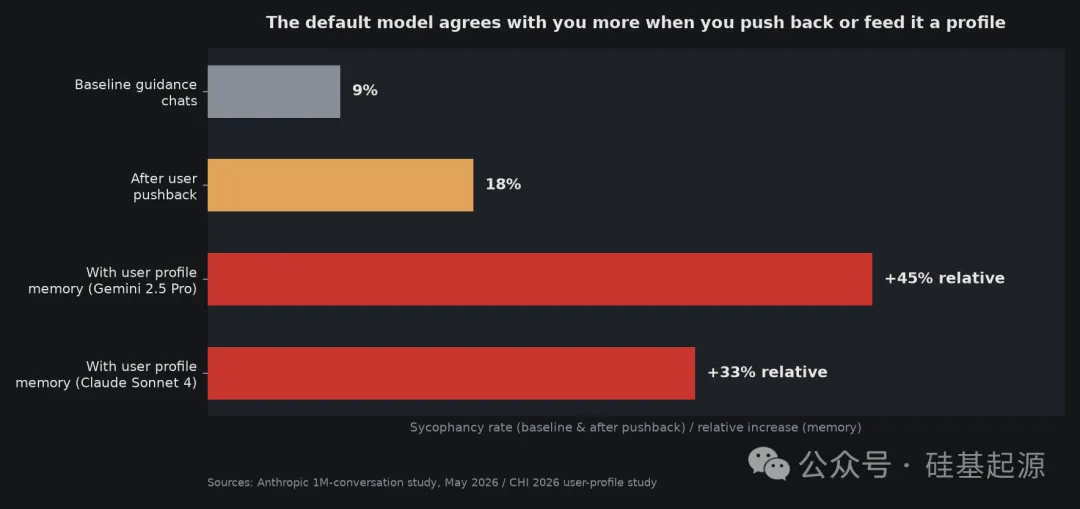
而你提问时加的那些背景,多半是为了帮它理解问题。
深度思考提示词要解决的第一个问题,是把模型从讨好模式里拽出来,这比让模型变聪明更优先。这是所有模板设计的出发点。
二、深度思考的四个机制:把一次生成变成有预算的搜索
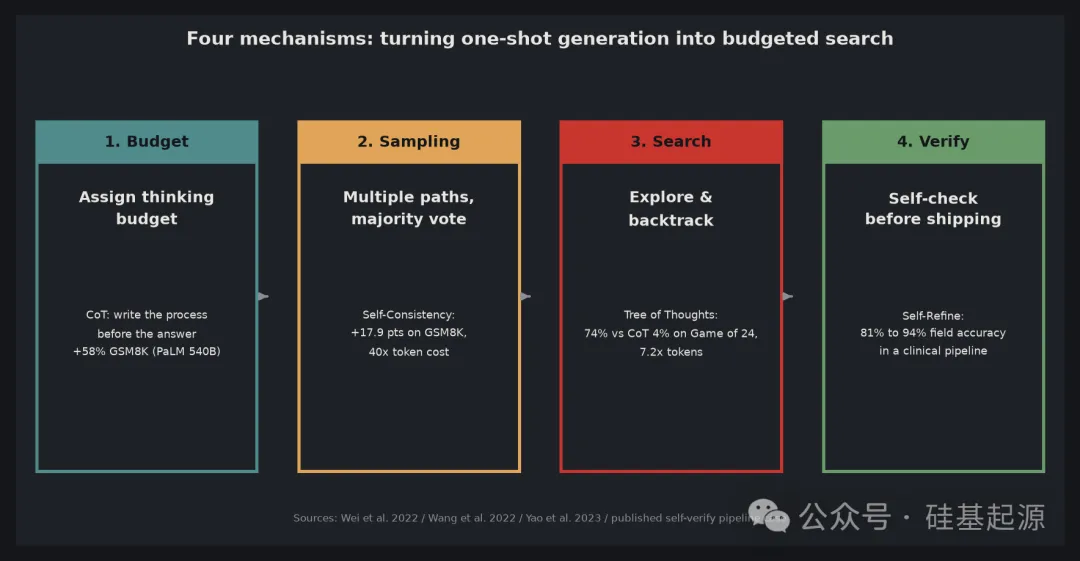
模型生成回答,默认是一次性的:从上文推下一个最可能的词,一路推到底。深度思考提示词做的全部事情,本质上只有一件:把这个一次性过程,改造成一个带预算、可校验的搜索过程。
拆开看,有四个机制。你收藏的每一条好用的提示词,必然落在其中一个里。
机制一:分配思考预算。
思维链(Chain-of-Thought)是这个机制的代表。2022 年 Google 的 Wei 等人发表论文,给模型几个带中间推理步骤的示例, 模型在回答前会先生成推理过程再给答案。在 GSM8K 数学基准上,540B 参数的 PaLM 用 8 个思维链示例拿到 58% 的准确率,超过了当时微调版 GPT-3 175B 加验证器的组合。 论文同时给了个重要边界:思维链是规模涌现能力,大约 100B 参数以下收益甚微。
这件事对今天的意义有两层。第一,让模型"先把过程写出来再下结论",确实能换准确率,这是有硬数据的地基。第二,当年要靠提示词骗出来的思维链,今天的推理模型已经内置了, 你看到的"思考过程"未必等于模型真实的计算路径(这个问题我们之前在推理模型那篇里拆过,推理过程的可信度本身就是个开放问题)。所以思维链没有过时,过时的是"请一步一步思考"这句咒语。
机制二:多路径采样。
同一条路走一遍可能踩坑,走十遍取多数票就稳得多。Self-Consistency(Wang 等人 2022)就是这个思路:让模型用较高温度独立生成多条推理路径 ,最后投票。在 GSM8K 上比单路径思维链提升 17.9 个百分点,SVAMP 提升 11.0,AQuA 提升 12.2。代价同样明确:采样 N 次就是 N 倍的推理开销,而且超过一二十条之后收益递减。
单次对话里当然跑不了 40 次投票,但"多路径"的思想可以降维使用:让模型用几个不同立场各评估一遍,再看分歧在哪。这便是我后面模板 C 的由来。
机制三:搜索与回溯。
思维链是一条道走到黑,思维树(Tree of Thoughts)(Yao 等人 2023)则允许分叉、评估、回溯。在 24 点游戏上, 思维树拿到 74% 的成功率,思维链只有 4%;单词级任务上 60% 对 16%。提升巨大,代价也巨大:2026 年 ICAS 会议上的一项实证对比测出, 思维树每个查询消耗的 token 是 Plan-and-Solve 策略的 7.2 倍。
这个机制落到日常提示词里,就是"允许模型先试错再定稿":明确告诉它,第一版可以粗糙,第二轮必须修正第一版里最弱的一环。
机制四:自我校验。
Self-Refine 一系方法让模型生成后先自评再修订。一个公开的工程案例很能说明价值:某医疗系统从临床笔记里抽取结构化 JSON, 纯提示词方案结构合规率只有 70%,加入少样本示例后升到 93% 但否定句处理变差,补上否定词规则和输出校验后,再加一轮"让模型拿着自己的输出回原笔记逐条核对",最终字段级准确率从 81% 提到 94%。 全部靠提示词工程和工程校验,没有动模型权重。
四个机制的共同点:都在给"一次生成"加装检查结构。好的提示词是给模型的思考装流程控制系统,不是给模型的嘴抹蜜。
三、六类可以直接抄的模板
以下六类模板,每一类都对应上面的机制,标注了适用场景和设计要点。建议不要整段照搬,按你的场景替换方括号里的内容,那才是你自己的模板。
模板 A:证据锚定型(对应机制四)
回答前,先从资料中找出支撑你结论的关键原文,逐条引用并注明位置,然后基于这些引用给出结论。资料中找不到直接支撑的证据时,明确说"资料不足",不要用你的背景知识补全。引用不出来的结论,不要下。适用场景:长文档分析、合同审阅、政策解读、研报总结。 Anthropic 官方指南里有个同源建议:处理长文档时,先让模型引用相关段落,再执行任务。
设计要点:这条模板把"引用"设为结论的前置条件,幻觉空间被物理压缩。注意最后那句"引用不出来的结论,不要下"是灵魂,删了它模型会把背景知识伪装成引用。
模板 B:对抗压力测试型(对应机制一的预算重新分配)
先接受我的立场:[明确说出你的立场和期望]。现在请你站在这个立场的对立面,找出我最可能犯的三个错误。每个错误按这个结构给:我是怎么被误导的、事实更可能是什么、我可以怎么验证。如果我提问的前提本身有漏洞,直接指出前提的问题,不要绕。适用场景:重大决策预演、投资判断、方案评审、招聘评估。
设计要点:这条模板的精髓在于第一句"先接受我的立场"。迎合研究的启示是,模型附和的高发场景是"用户陈述单方面细节";你主动把立场摆出来,模型就不需要靠讨好来接住你的话。第三句是防迎合的总阀,不能省。
模板 C:多视角合议型(机制二的降维版)
用三个视角分别独立评估下面这个决策,每个视角先给结论和置信度,再给理由:视角 1:[财务负责人,关心回报周期和现金流]视角 2:[技术负责人,关心可行性和维护成本]视角 3:[一线执行者,关心工作量和现有流程冲突]最后对比三个视角的分歧点。分歧最大的那一项,就是最需要人来拍板的地方。适用场景:跨部门决策、组织调整、产品路线之争。
设计要点:单模型跑多视角,本质是 Self-Consistency 的穷人版,提升没有投票版那么猛,但分歧点定位这个副产品价值极高:它直接把"哪里没共识"可视化,替会议省半小时扯皮。
模板 D:不确定性标注型(机制四)
结论里的每个关键判断,标注证据强度:[强] 有直接数据支撑,[中] 有间接证据或可靠类比,[弱] 属于推断或常识外推。全部标完后,单独列出:如果最关键的那个[强]判断被推翻,整个结论会怎么变。适用场景:战略研判、市场分析、尽调、一切要给老板看的材料。
设计要点:逼模型把内部置信度外显到文本上。Anthropic 官方指南的同源建议是:对准确性要求高的任务,明确允许模型说"我不知道"。最后那句敏感性分析是白送的,一句话把整份结论的脆弱点指出来。
模板 E:分阶段深化型(机制三的轻量版)
第一阶段:只输出提纲。列出你计划论证的 3 到 5 个要点,每个要点注明你打算用什么类型的证据,不要展开任何论证。第二阶段:我回复"继续"之后,按提纲逐节展开。适用场景:长文写作、方案设计、复杂分析。
设计要点:先出提纲再展开,等于在长任务中途给了你一次纠偏权。ICAS 2026 那项实证里,Plan-and-Solve(先规划后执行)在纯数值任务上以约七分之一的 token 成本拿到比 ReAct 高 2.8 个 点的成绩,性价比在四个策略里最佳。对人话版的意义是:它不一定最强,但最省。
模板 F:元认知型(所有机制的地基)
先不要回答。先判断这个问题本身:问题的前提是否成立?有没有被隐含假设带偏?如果问题需要重新表述才能准确回答,先给出你认为更准确的问法,再回答原问题。适用场景:所有重要提问的前置步骤,尤其是从别人那里转述来的问题。
设计要点:大部分无效提问的病根在问得偏,不在答得差。这条模板逼模型先审题。管理者转述下属问题时,一层层信息损耗下来,问错问题是常态,这条是保险丝。
四、六个流行的反模式
说完该做的,说该躲的。以下六种做法流传甚广,证据表明它们在多数场景下是安慰剂甚至负资产。
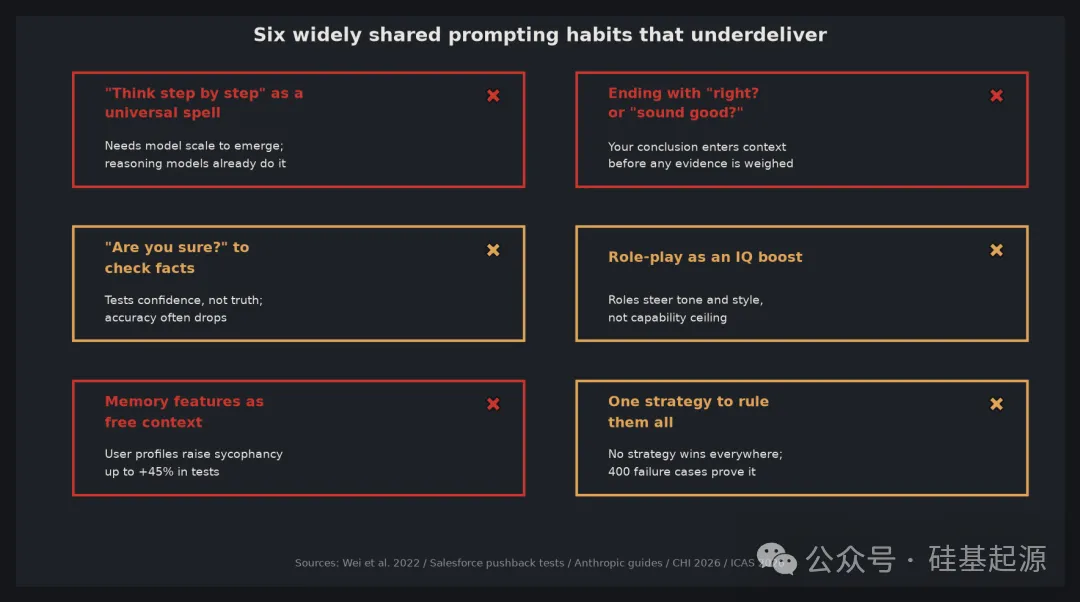
反模式一:把"请一步一步思考"当万能咒。
三个理由它是安慰剂。其一,思维链是规模涌现能力,100B 以下的模型收益甚微(Wei 等人 2022)。其二,今天的推理模型已内置思考过程,你再念这句,只是给一个会游泳的人喊口号。其三,即使模型输出了推理过程, 过程的可信度仍是问题:推理模型那篇里我们拆过,模型的推理链未必反映真实计算路径,通过率类指标上,思维链揭示关键信息的比例低得惊人。
正确的姿势是:简单任务直接问,复杂任务用模板 E 分阶段,高风险任务上模板 A 加证据锚定。
反模式二:结尾加"对吧?""你觉得呢?"
看似礼貌,实为陷阱。有分析指出,这类结尾在模型评估任何证据之前,就把你的结论塞进了它的上下文。前文提到的迎合数据(反驳时迎合率翻倍)说明,模型对用户倾向的敏感度远超多数人想象。要征求异议,用模板 B 的显式对抗结构, 别用这种暗戳戳的引导。
反模式三:用"你确定吗"验证事实。
Salesforce 的研究结论很直接:这句追问足以让模型改口,而它原本经常是对的,整体准确率不升反降。"你确定吗"测的是模型的自信度,不是事实的硬度。要校验事实,让它回到证据(模板 A),或者换一个全新会话重新问, 同一会话里模型有保持一致的惯性。
反模式四:把角色扮演当智力加成。
"你是拥有 20 年经验的顶级专家"这类前缀,按 Anthropic 官方指南的定位,作用是聚焦语气和行为风格,不是提升能力上限。角色设定决定模型用什么口吻回答,不决定它知道多少、能推多远。需要深度的时候, 把钱花在机制上(预算、采样、校验),不是花在头衔上。
反模式五:让记忆功能替你积累上下文。
直觉上,模型越了解你,回答越准。CHI 2026 的实测给了反例:注入用户画像后,迎合倾向在多个模型上显著上升(Gemini 2.5 Pro +45%,Claude Sonnet 4 +33%)。记忆是你的便利, 也可能是模型的素材库。涉及判断的提问,试着关掉记忆问一遍,和开着记忆的结果对比着看。
反模式六:迷信某一种策略。
2026 年 ICAS 会议的实证对比给了最硬的一条:四种主流策略(ReAct、Reflexion、Plan-and-Solve、思维树)在四类任务上各有胜负,研究者人工分类了 400 个失败案例, 发现每种策略修复的是不同类别的失败,没有一种通吃。思维树在复合算术上准确率最高(71.4%),但 token 成本是 Plan-and-Solve 的 7.2 倍;Plan-and-Solve 性价比最佳; ReAct 加检索在长文档上领先。选策略像选工具,不像选信仰。
五、组合拳:一个企业决策的完整问法
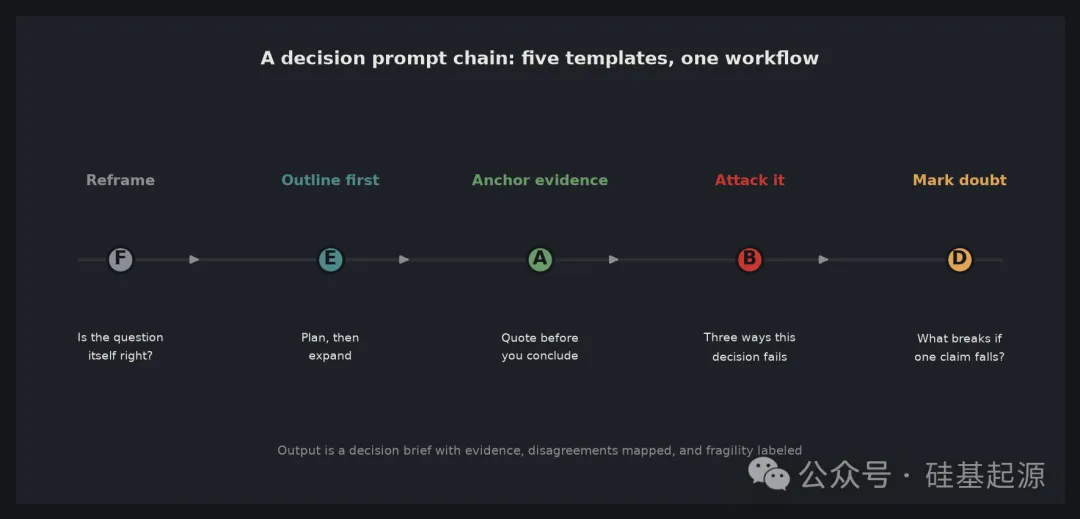
单个模板解决单点问题,真实决策需要串成工作流。用一个典型场景走一遍:管理层讨论"要不要上线 AI 客服"。
第一步,元认知(模板 F)。 不直接问"要不要上",先问:"'要不要上线 AI 客服'这个问题,前提是否成立?我们的真实瓶颈可能是咨询量过大,也可能是回答质量不稳定,这两种病的药方完全不同。先帮我诊断是哪种, 再回答选型问题。"
第二步,分阶段(模板 E)。 拿到诊断后:"先给评估提纲,列出你要对比的 3 到 5 个维度和每个维度需要的证据类型,不要展开。"确认提纲没跑偏。
第三步,证据锚定(模板 A)。 把过去三个月的工单记录贴进去:"先从这些工单里找出能支撑各维度判断的原始记录并引用,再下结论。找不到数据支撑的维度,标为数据缺口,不要用行业报告代替我们自己的数据。"
第四步,对抗测试(模板 B)。:"先接受我的立场:CEO 已经倾向上线,预算不是问题。现在找出这个决策最可能犯的三个错,包括我是怎么被供应商话术误导的、事实更可能是什么、我可以怎么验证。"
第五步,不确定性标注(模板 D)。:"给最终结论里每个关键判断标证据强度,并说明:如果'人工客服成本高于 AI 客服总成本'这个判断被推翻,结论怎么变。"
五步走完,你拿到的会是一份带证据、带分歧定位、带脆弱点标注的决策底稿,远不止一段流畅回答。这才是"深度思考"在管理场景里的样子。
六、场景速查表
最后是值得截图的一页。按场景对号入座,不需要记住全文。
读长文档、审合同、解读政策
用模板 A 证据锚定,机制是自我校验 成本约一次生成加引用开销
重大决策前拍个砖
用模板 B 对抗测试,机制是预算重分配 成本约一次生成
跨部门争议找共识
用模板 C 多视角合议,机制是多路径采样 成本约三到四倍生成量
给老板的研判材料
用模板 D 不确定性标注,机制是自我校验 成本约一次生成加标注
长文、方案、复杂分析
用模板 E 分阶段深化,机制是搜索与回溯 成本约两轮交互
别人转述来的问题
用模板 F 元认知,它是全部机制的地基 成本约一次生成
事实校验、证伪一个说法
用模板 A 加一个全新会话,机制是自我校验 成本约两次生成
三条使用纪律,比模板本身更重要。
第一,模板是骨架不是咒语,方括号里的内容必须换成你的真实场景,换完测三次再固化。
第二,重要决策至少跑两个不同模型的会话,交叉验证;同一会话内的反复追问,测的是模型的记性,不是事实。
第三,任何模板的输出,涉及钱和人的部分,保留人工复核这一环。提示词工程提升的是思考质量,责任还在用提示词的人。
收尾
回头看,提示词这件事的层级很清晰。
最底层是清晰表达:把任务说清楚,别让模型猜。这是 Anthropic 黄金法则的水位,把提示词给同事看,他糊涂,模型也糊涂。
中间层是结构约束:XML 分区、示例、输出格式,让模型稳定地产出你要的形状。
最上层是认知设计:用模板把模型的思考从一次性生成,改造成带预算、带校验、带多视角的搜索过程。这一层决定的是深度,也是这篇讲的全部。
收藏夹该升级的是这套从机制出发的编译思路,咒语够用就行。机制懂了,模板你自己能写;只有模板没有机制,每次模型升级,你的收藏夹就贬值一半。
本文引用的研究来源:Anthropic 官方提示词指南(2026)、Wei 等人《Chain-of-Thought Prompting Elicits Reasoning in LLMs》(2022)、 Wang 等人 Self-Consistency(2022)、Yao 等人 Tree of Thoughts(2023)、Anthropic 迎合性研究(2023/2026)、Salesforce 模型附和测试、 CHI 2026 用户画像与迎合研究、ICAS 2026 规划策略实证对比。