ARTICLE · 1299922
不是让教师直接用 AI 写教案:Shiksha Copilot 怎样把审核与定制放进流程?
论文札记 · 教师AI协作 · 低资源学校
在低资源学校,教案既是教学工具,也是必须完成的行政文件。Shiksha Copilot 没有把生成式模型直接交给教师,而是设计了两阶段链条:先由策划者与 AI 共同生产、审核英语言教案并翻译审核为卡纳达语,再由一线教师复制、定制并用于自己的班级。CSCW 2026 的研究追踪了印度卡纳塔克邦大规模部署中的教师、策划者、日志、访谈和前后问卷。它证明的是教师工作如何被重组、资源与压力如何被报告为变化,而不是随机对照意义上的学生学习因果效果。
论文信息:Shiksha Copilot: Teacher-AI Collaboration for Curating and Customizing Lesson Plans in Low-Resource Schools。Deepak Varuvel Dennison et al.。Proc. ACM Hum.-Comput. Interact.。2026。2026-03-11 author version。DOI:10.1145/3788074
CSCW 2026教师AI协作双语教案
01核心选择:把“生成”放在审核流程里
论文面对的不是缺少一个会写教案的模型,而是拥挤班级、师资短缺、行政记录与多语环境并存的工作条件。通用 LLM 可以生成流畅文本,却可能在事实、文化语境和地方语言上失准。Shiksha Copilot 因此将 AI 定位为协作基础设施:模型提出草案,人类策划者审核,教师再作本地化选择。这里的关键不是多一个聊天框,而是决定谁能生成、谁能修改、哪个版本可以进入教师库。
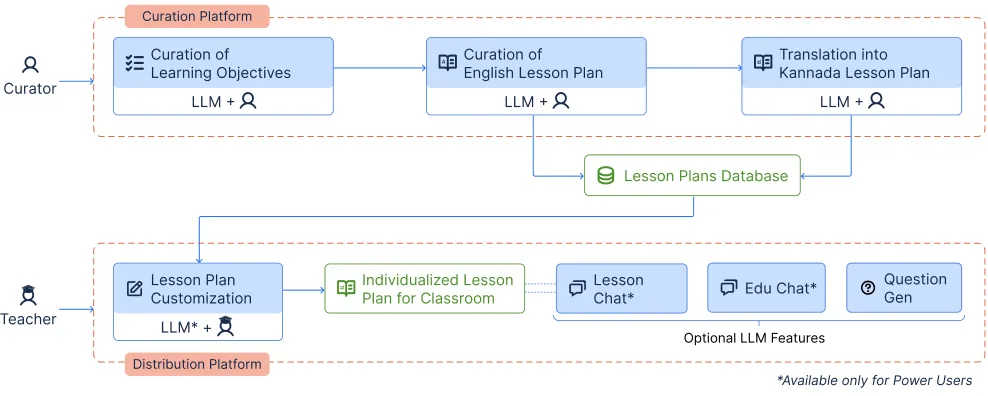
系统首先通过 RAG 从课程索引取回材料。教案生成代理按 5E(Engage、Explore、Explain、Elaborate、Evaluate)逐段构建内容;问题生成代理依据 Bloom 分类法创建测评;Lesson Chat 回答某一教案相关问题,Edu Chat 处理更一般的教学问题。英文教案经策划者审核后,由基于 Sarvam-1、使用 LoRA 微调的翻译组件转为卡纳达语,再交给卡纳达语策划者复核。验证代理检查格式、完整性和生成失败后的回退。
02两阶段分工让“人类在环”有了具体位置
策划阶段有 23 名教育工作者,其中 15 名英语媒介、8 名卡纳达语媒介。模型先产生学习目标,策划者补充并检查课程标准;这些目标驱动 RAG 教案生成。每份教案被拆成 5E 环节、活动、评估题和现实应用等内容块,策划者逐块评分、修改后再组装。论文分析了 991 份策划教案,其中 965 份英文、26 份卡纳达语。人类工作不是点一次“批准”,而是处理准确性、课堂可行性、术语和文化相关性。
分发阶段向 1,043 名公立学校教师开放,覆盖 757 所学校、35 个教育区。所有人可查看和手工定制审核过的教案,并使用题目生成;根据使用参与度,146 名教师被逐步赋予 power user 权限,才能生成新教案、AI 辅助修改及使用两类聊天功能。这种权限安排既是成本管理,也是研究设计条件:不同功能的使用者并非随机分配,不能把 power user 与普通用户的差异直接解释为 AI 功能造成。
教师总共创建了 5,544 份教案(4,064 英文、1,480 卡纳达语)。这个数字说明系统被用于复制、调整和文档工作,但并不告诉我们每份是否在课堂实施、学生是否理解,或哪个编辑来自 AI。日志适合观察工作流,不能独自回答教学成效。
03混合方法记录了工作实践的变化
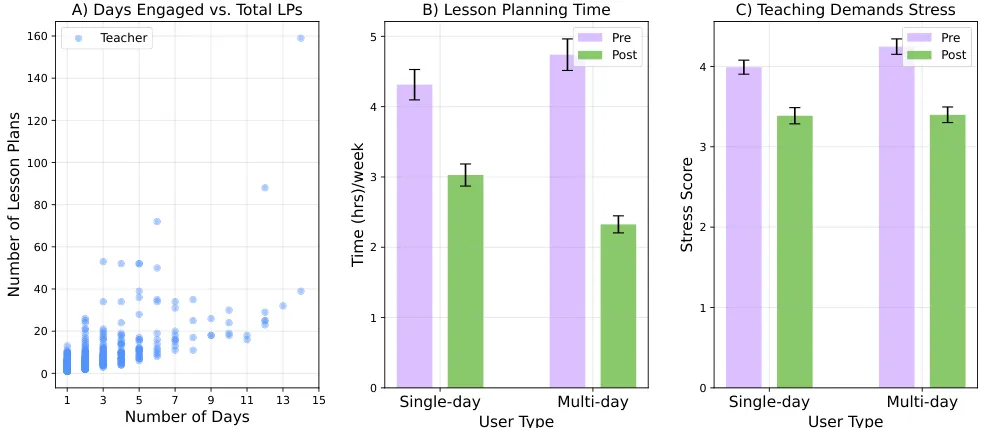
研究做了 43 次半结构访谈:17 名策划者、22 名教师和 4 名导师;访谈编码形成 28 个代码、归入五个主题,包括教案质量、实施约束、教学实践影响、文化相关性与偏见、AI 认知。作者也进行了前后调查:前测有 601 份完整回应,后测 406 份,定量分析使用 406 名配对教师。量表包含教学需求压力、学校支持、资源获取、时间使用和对教育 AI 的信任;部署在教师培训后持续数月。
论文报告教师把工具用于教学和行政两类任务:一方面减少准备和记录负担,缓解压力并获取活动、评估和真实情境资源;另一方面,课堂中的人手、时间、设备和课程调整约束了教案能否转化为更活动化的教学。质性主题中既有“减轻工作量”“减少压力”“提高创造性”,也有“依赖教师”“资源限制”“文化语境不足”。这正是该研究比单纯满意度调查更有价值之处:它把工具放进组织条件中,而非把采用归因于模型本身。
04结果的边界:相关变化不等于学生学习因果
前后问卷和日志提供了规模化的教师工作证据,但没有随机分配或学生学习对照。活跃用户可能本来就更愿意尝试新资源;power user 权限也按参与度逐步发放。再加上学期节奏、考试季和导师支持同时变化,备课时间或压力的变化不能被简单归为系统的单独效应。论文将其解释为在既有社区实践中发生的协作与工作重组,而非“AI 自动提高教学质量”。
双语结果尤其提醒我们不能把“已翻译”误作“已本地化”。英文教案可靠性较高,卡纳达语内容需要较多语言编辑;策划者和教师仍要用本地知识修正术语、材料可得性和班级活动。低资源场景的质量控制不只是减少幻觉,还包括谁拥有修改权、谁的教学经验进入系统,以及缺乏网络、设备或时间时功能是否可用。
对产品设计而言,最可迁移的原则是把 AI 草案、人工修订、版本库和教师定制区分开保存;让教师看见来源和可编辑边界;以培训、同行支持和本地审核补足模型弱点。对研究而言,下一步应同时追踪教案实际使用、课堂互动和学生结果,并采用能处理自选择的比较设计。只有那时,教师工作负担的改善才可能进一步连接到学习机会的改善。
平台中的角色差异也说明功能公平不是简单的“人人都能用同一个模型”。标准用户、power user 和策划者看到的工具不同:有些人只能手工改教案,有些人可用 AI 改写与聊天,策划者拥有完整的生成、审核和翻译权。这样的分层有助于控制费用并逐步培训,却会影响谁从自动化中获益、谁承担额外编辑劳动。评估时应同时报告权限、培训和支持差异,而非只用总注册人数说明覆盖规模。
研究的问卷在统计上也需要谨慎阅读。前测与后测通过电话号码和账号匹配,最终使用 406 名配对回应;缺失值采用 miceforest 填补,数值离群值在第 95 百分位截尾。这些处理使分析可进行,但不会消除未回应教师、选择使用频率或学校资源条件带来的偏差。量表的内部一致性较高,说明同一构念题项在样本中较一致,却不等同于量表测得了由系统造成的变化。
最值得保留的并非某个提示模板,而是把生成后的人类工作显性化:哪些块被修改、为什么被修改、哪些语言和文化问题反复出现。若未来模型能力提高,这条审核链仍然重要,因为教学材料的正确性、可执行性与归属感不能仅由流畅度判断。
对于低资源环境而言,真正可持续的方案还要考虑离线支持、设备共享、教师时间和地方组织的维护能力。若这些条件缺失,内容生成再快也可能只增加新的记录与筛选负担。因而“以教师为中心”不是界面上多一个编辑按钮,而是让技术安排适应教师既有的协作网络、语言实践与课堂现实。