ARTICLE · 1300608
数据标准怎么落地:别让标准只活在文档里
讲个很常见的场景。公司要做数据治理,请来一拨人,访谈、开会、写文档,折腾好几个月,最后拿出一本厚厚的数据标准。几百页,拿在手里挺沉,管理层也满意。
然后呢?没然后了。
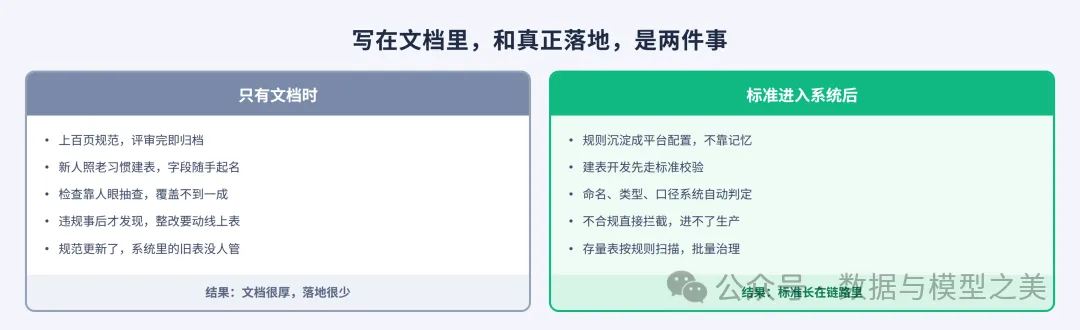
标准往共享盘一扔,开发该怎么建表还怎么建。新来的没人培训,照着老项目抄,字段名想起什么起什么。同一个销售额,三张表三个算法。等半年后标准出了第二版,库里那些老表,没人会去动。
这事我见太多了。问题真不在标准写得不够,几百页还嫌少?问题在它始终是给人看的字,人得记得住、愿意翻,它才管点用。真能落地的标准不待在文档里,它长在系统和开发流程里面。这俩区别有多大,往下看。
先搞清楚标准到底管什么
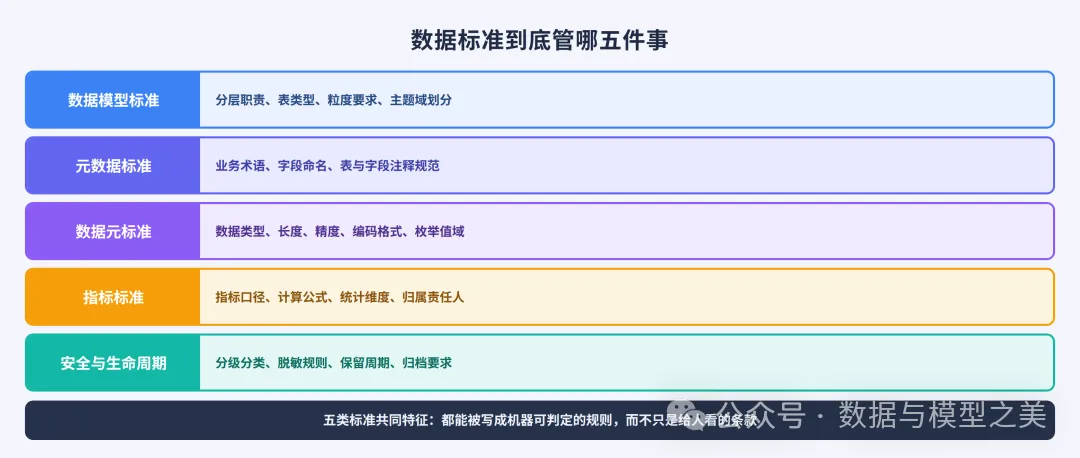
别急着上系统,得先把边界划明白。我见过不少公司,连考勤制度、会议室规定都往数据标准里塞,那能落地才怪。核心其实就五件事。
模型标准,管分层怎么分、每种表是干嘛的、粒度到什么程度、主题域怎么划。元数据标准,管业务术语、字段怎么起名、表和字段注释怎么写。数据元标准,管字段类型、长度、精度、编码格式和枚举值。指标标准,管口径、算法公式、统计维度,还得写清这指标出了问题找谁。最后是安全和生命周期,数据分几级、怎么脱敏、存多久、什么时候归档。
这五件事有个共同点:都能让机器来判。金额字段是不是 DECIMAL,表名合不合规矩,注释写没写,系统扫一眼就有答案。反过来,一条标准要是只能靠人去读、去领会,机器判不了,那它写得再漂亮也落不了地。拿这把筛子先过一遍,很管用。
头一步:把标准翻译成规则
文档上的话系统听不懂。所以落地头一件事,是把标准一句句翻译成规则。一条规则得说清三样:管谁、什么条件、逮着了怎么处理。
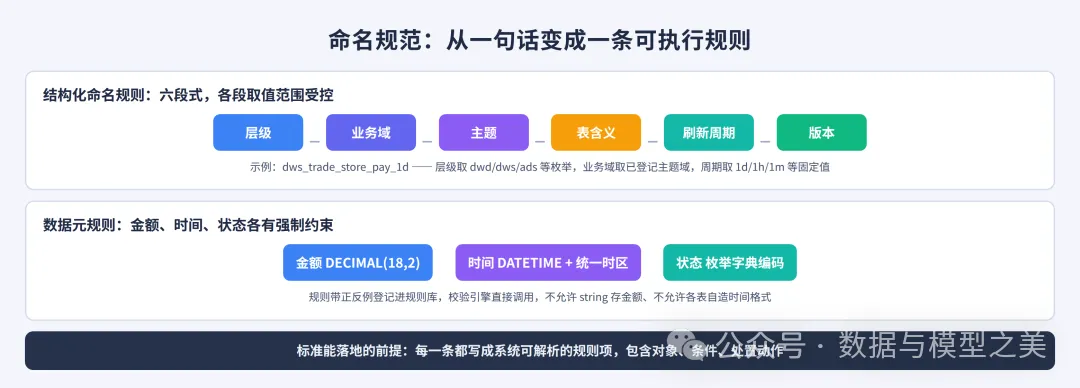
拿命名来说,文档里通常写表名要见名知义。话没错,可它没法执行,什么叫知义?翻译完是另一副样子:表名分六段,层级、业务域、主题、含义、刷新周期、版本,每段能填什么全卡死。层级只能是 dwd、dws、ads 这几个,业务域必须是登记过的,周期就 1d、1h、1m 几个固定选项。表名一提交,合不合规矩立刻见分晓,不用谁拍脑袋。
数据元也一样。金额一律 DECIMAL(18,2),拿字符串存金额想都别想,那种坑我填过,小数精度悄悄丢了,查都查不出来。时间统一 DATETIME、统一时区,各表自己发明时间格式,迟早出事。状态字段必须挂枚举字典,不许写死汉字。每条规则配上正反例放进规则库,校验时直接调。
这步翻译最枯燥,也最省不掉。哪条标准翻不成规则,说明它本身就含糊,赶紧回去掰扯清楚,别想着先把系统搭起来再说。
我一般建议拉上业务和开发一起翻,别让写文档的人闷头干。有个团队就是,规则拍脑袋写完,上线第一天拦下二十多条提交,开发跑去一核对,发现一半是规则自己理解错了。返工事小,开发对这套东西从此不信任了,那才麻烦。
卡点得放在流水线上
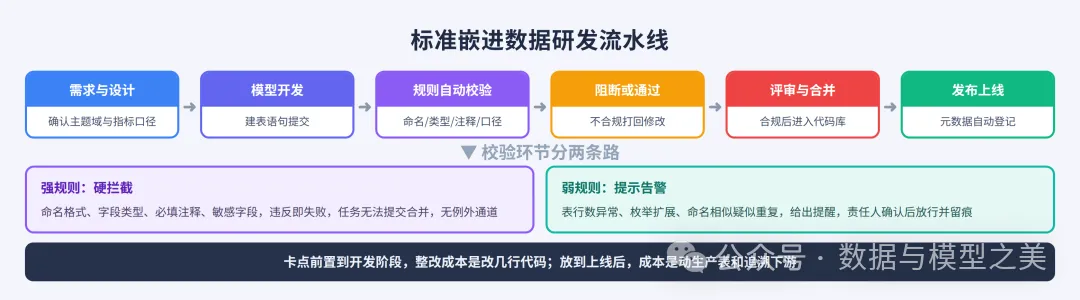
规则有了,在哪执行又是一道坎。靠事后人工抽查,说句不好听的,一成的表都查不到,等查到也晚了。正确的位置是研发流水线,开发点提交的那一刻,规则就开始干活。
整个过程走一遍:需求阶段先把主题域和指标口径定下来;开发写好建表语句提交;系统自动校验,命名、类型、注释、口径一项项过;没过直接打回去,谁也别绕;过了才进评审、合并;最后上线,元数据自动登记,不用人再补录。
校验这里要分轻重。命名格式错、字段类型不对、注释漏了、碰了敏感字段,这些是硬规矩,违反就失败,提交不了,也没有特批通道,口子一开规矩就废。另一类,表行数不太对劲、枚举要加新值、两个表名像得可疑,这些不拦,只提醒,责任人看一眼,确认没问题就放行,但得留痕。一刀切全拦死,开发会想办法绕你;全放又等于没有。
账其实很好算。开发阶段卡住,改几行代码的事;等上线才发现,要动生产表,还得一个个追下游受了什么影响,代价完全不是一个量级。
规则只留一个源头
还有个坑,不少团队栽过:规则到处都是。建模工具一份,代码平台一份,质量平台又自己写一份。一开始都差不多,半年后三份对不上,谁也说不清哪份算数。
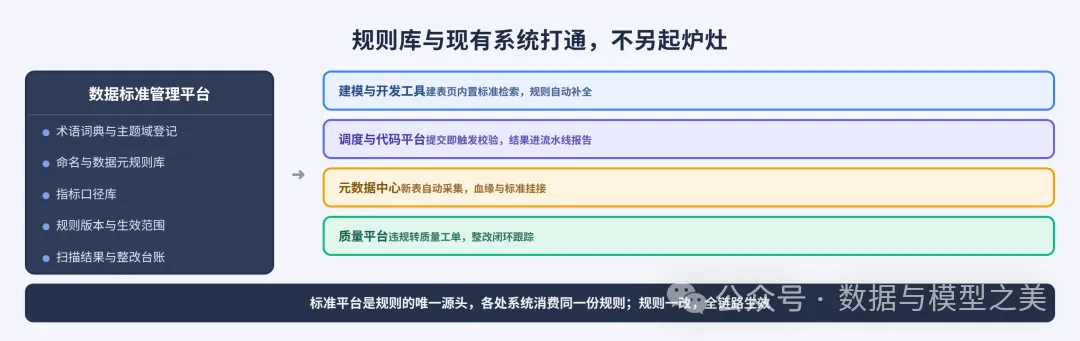
办法不新鲜,建一个标准管理平台,规则只此一份,别处都来它这儿拿。术语词典、主题域登记、命名和数据元规则、指标口径、规则版本和生效范围,还有扫出来的结果和整改台账,全收在里面。
重点是别推倒重来,跟现有系统接上就行。建模工具的建表页面里能直接搜标准,字段自动补全;代码和调度平台一提交就触发校验,结果回到流水线报告里;元数据中心自动采新表,血缘顺手跟标准挂上;质量平台发现违规,直接生成工单,整改全程盯着。规则只改这一处,所有系统跟着变,不会有谁还抱着旧版本不放。
存量的账,靠闭环慢慢还
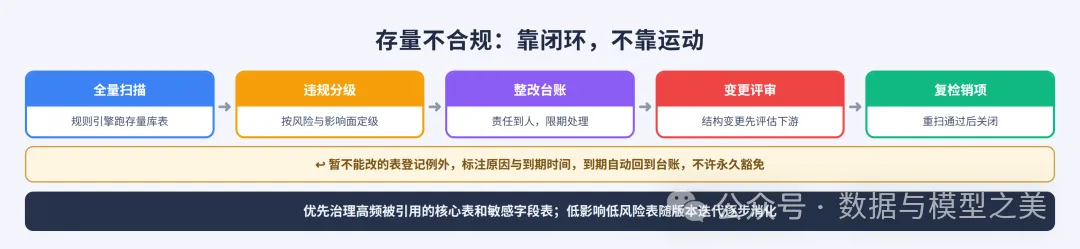
新表管住了,库里还压着一堆历史表,全不合规矩。别指望搞个专项整治,喊两个月口号全清完,我见过的基本都是开头热热闹闹,最后烂尾。存量这种事,得靠能一圈圈转起来的闭环。
五步。先用规则引擎把存量表全扫一遍;扫出来的问题按风险和影响面分级;建台账,每条写清谁负责、什么时候改完;要动表结构的,先把下游影响评估透;改完重扫,通过了这条才算销掉。
当然,总有几张表眼下真不敢动。可以登记例外,原因写清楚,到期时间也得给,时间一到自动回台账,永久豁免这种东西不能存在。顺序上,先收拾被引用最多的核心表,还有放敏感字段的表;剩下影响小、风险低的,跟着平时版本迭代慢慢消化,不用一口气吃完。
别贪多。我见过一上来就给全公司发整改大表的,几百条问题摊到几十个人头上,人人喊冤,推进两个月基本没动。后来换打法,一个月只啃十几张核心表,啃一张销一张,半年下来大头反而清完了。慢,就是快。
标准是要养的
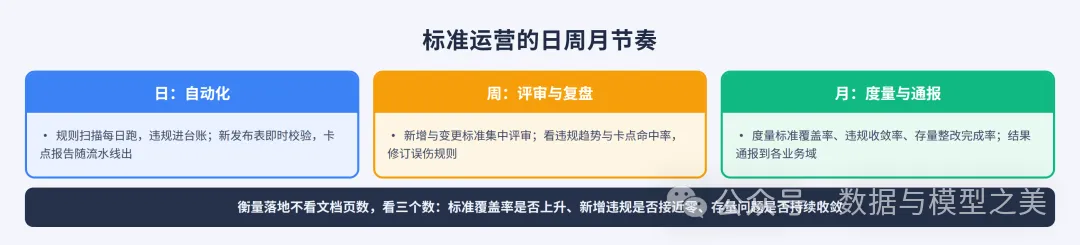
再说一句,标准不是项目上线就完事,它得养着。日、周、月三个节奏照着走,就能一直转。
每天的事交给机器:扫描天天跑,有违规就进台账,新表上线即时校验,报告随流水线自动出,不用人盯。每周把要新增和改动的标准凑一块儿评,看看违规走势,看看卡点拦得准不准,误伤正常开发的规则赶紧改。每月出数,标准覆盖了多少、违规在不在收、存量整改进度如何,通报到每个业务域,让大家都看得见。
到底落没落地,别数文档多少页,就看三个数:覆盖率往上走没有,新冒出来的违规是不是快没了,老问题是不是一直在变少。三个数都好看,标准才算真落地。
结尾
回头看,标准落不下去,十有八九不是标准的锅,是落地的姿势不对,指望人记住、人去查、人事后抽查,哪个都靠不住。把话翻译成机器能判的规则,卡进开发流水线,规则只留一个源头,存量用闭环慢慢还,再配一套长期运营的节奏,它才真正从文档里走出来。
顺序别搞反,先翻规则,再卡流水线,然后把各个系统接通,最后啃存量。四步。
文档厚不厚真不重要。系统替人执行了多少,才是唯一作数的东西。
如需要1对1服务、商业咨询、技术指导、简历修改、面试指导、商务合作的朋友,也可以以长按下方二维码加我个人微信详细对接沟通。备注来源和诉求。
关注「数据与模型之美」,持续分享大数据 & AI 落地的真实踩坑经验。觉得有用的话,点个「在看」转发给同事,咱们下篇见。
作者:陈乔怀古 | 公众号:数据与模型之美
聚焦大数据架构、大模型应用、企业级数据治理的硬核技术号