ARTICLE · 1309790
" 从卸载到「认知投降」,只差 3 步"
11 月 3 日我写过一项实验:50 位分析师跟着 AI 走,事后还把 AI 的论证当成自己想出来的。这一篇是它的下半场——上一篇讲为什么会发生,这一篇讲每天具体怎么做。
写的人是 Addy Osmani,前 Google Chrome DevTools 负责人,干了 14 年。这里必须多说一句:他现在是 Anthropic Claude Code 团队的成员。所以这不是外人评论,是一个在里面的人提醒你别全信。
先交代那条光谱
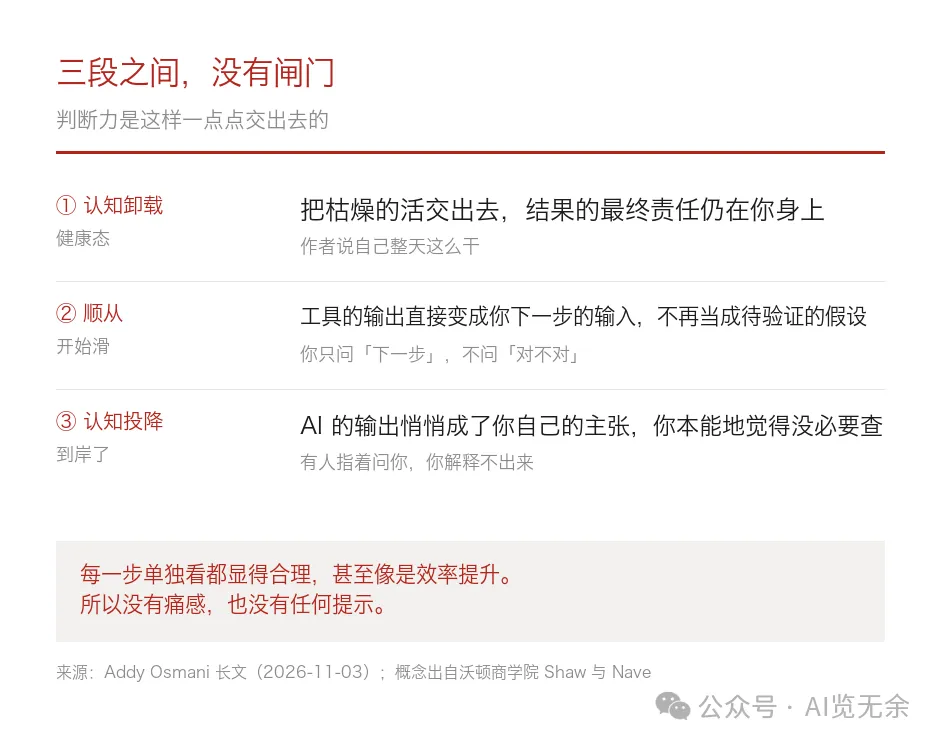
据他 2026 年 11 月 3 日的博客原文,这件事被拆成了三个阶段。我用一句话概括每段的判据,你可以顺手对一下自己卡在哪一段。
第一段,认知卸载。把具体枯燥的活交出去,但最终结果的所有权与责任始终在你身上。这是健康态,他说自己整天这么干。
第二段,顺从。工具吐出来的结果直接变成你下一步的输入,它不再是一个待验证的假设。你不再问「它对不对」,只问「下一步怎么走」。
第三段,认知投降。AI 的输出悄悄变成你自己的主张,你本能地觉得没必要再查一遍。到这一步,你已经不觉得那是在引用别人。
三段之间没有闸门。
拆解:滑下去的过程
他说这个过程极难察觉。因为每一步单独看都显得很合理,甚至像是效率在提升,没人会觉得自己在让步。
这次你仔细读了,下次就只是略读,再下次只看骨架。直到有一天有人指着某一行问你,你突然发现自己解释不出来。哪怕有 AI 在旁边帮忙,也解释不出来。
滑坡不响铃。
但真正难解释的不是这三段的定义,是它为什么滑得这么快。
机制在另一处。过去人的思考和审美,诞生在「提问」和「回答」之间那段空白里。你得先想,再问,再判断它答得对不对。那段空白,本身就是判断长出来的地方。
现在这段空白被压缩到只剩几秒。
更麻烦的是,模型越强,这一步越快。明显荒唐的错误越来越少,输出越来越整洁,大部分还都对。可正是这种整洁,让人不想看第二眼。
后果他给了个名字:认知债务。它不写在任何账单上,也不影响你这个月的进度。它只在你试图调用整个系统的全局印象时,一次性暴露。那时你发现,脑子是空的。
而且没有痛感。
对照一下上一篇那个实验
上一篇那项实验测的是「自动化偏差」:人会下意识服从机器的结论,而且事后不承认自己受了影响。那篇给的是机制,没给做法。
「认知投降」不是他自创,是沃顿商学院 Steven Shaw 与 Gideon Nave 提的。
自动化偏差说的是你服从了机器,认知投降说的是你连「这是机器的」都不记得了。一个落在行为上,一个落在归属上。
这个区别挺关键。前者可以靠「我提醒自己别盲从」来防,后者连提醒的抓手都没有。因为你根本没意识到,那是别人给的。
前者会报警,后者不会。
真正该记住的是责任那一层
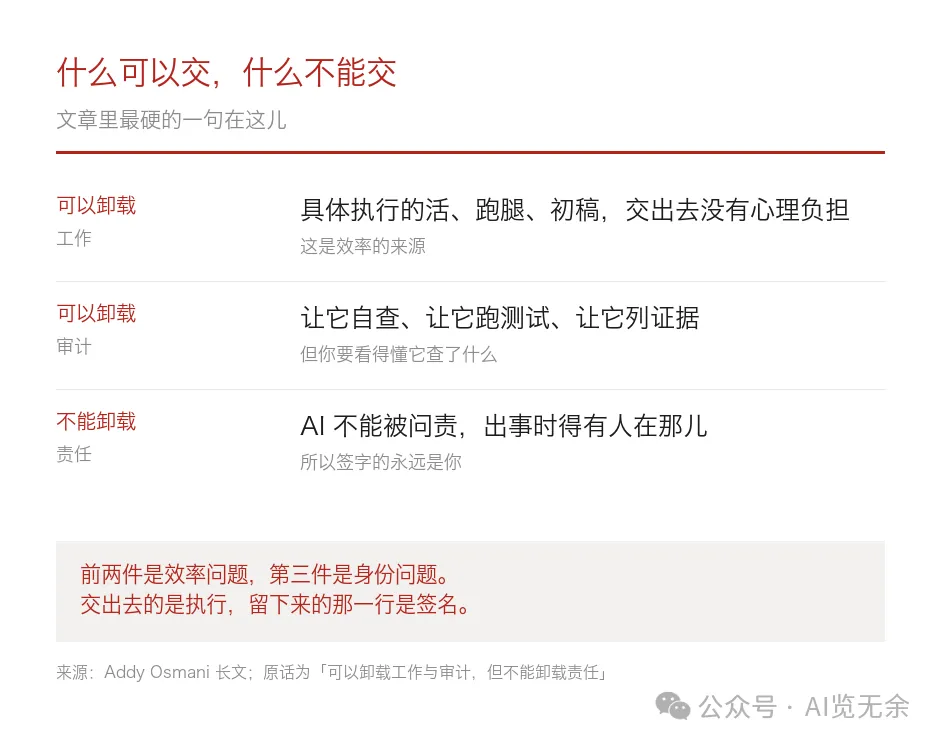
文章里最硬的一句是:可以卸载工作,可以卸载审计,但不能卸载责任。前两件是效率问题,第三件是身份问题。
理由是 AI 模型不能被问责。所以在 Chromium 这样的项目里,一定会指定某个工程师拥有一部分代码——他不必写每一行,但要为它的质量负责。出事的时候得有人在那儿。
这话对不写代码的人也一样:交出去的是执行,留在你身上的是签字。
问题是签字那一栏,经常是空的。
对你意味着什么
这不是让我别用 AI。他开篇就说自己是这些工具的忠实拥护者,整篇也没劝人减量。
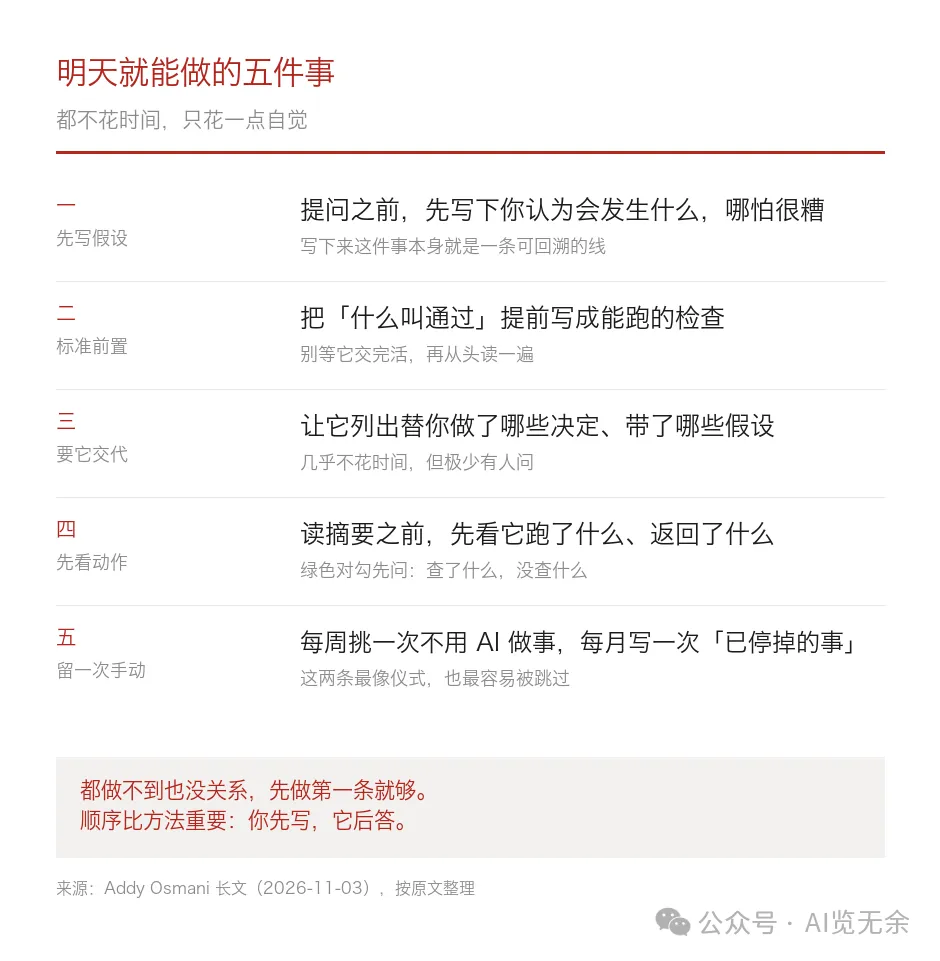
他给了几条能直接照做的,我挑了五条。
第一,提问之前先写下自己的假设,哪怕很糟。写下来这件事本身,就是给自己留一条可回溯的线。
第二,把验证标准提前写成能跑的检查。事先定好什么算通过,比事后从头读一遍管用得多。
第三,要求 AI 列出它替你做了哪些决定、带了哪些假设。这一步很多人嫌麻烦,但它几乎不花时间。
第四,读摘要之前,先看它跑了什么、返回了什么。看到绿色对勾,先问一句:它检查了什么,没检查什么?
第五,每周挑一次不用 AI 做事;每月写一次「已停掉的事」。
这两条最像仪式,也最容易被跳过。
结论
说到底,这套东西只有一个自测题,是他文章里留下来的:
如果 AI 不存在,你会迷失到什么程度?
答案不用告诉别人。但如果某件事你想不出第二个办法,那件事大概已经不在你手上了。
你最近有没有过这种时候——打开一个文件,发现自己说不清它为什么长这样?评论区聊聊。
AI 圈的事,搜「AI 览无余」就有——不追热搜追数据,每篇都标出处、都算给你看。