ARTICLE · 1320361
论文速递 (ICML 2026) | 文档视觉问答中基于Wasserstein梯度流的渐进式证据定位框架
论文名称
A Progressive Evidence Localization Framework Based on Wasserstein Gradient Flows for Document Visual Question Answering
论文作者
Haosen Wang, Jing Xiao, Mengqiao Li, Xuanze Wang, Mingzheng Zhang ,Xiaowang Zhang, Zhiyong Feng
作者单位
天津大学软件学院,天津大学国际工程师学院
发表期刊
ICML2026
摘要
Abstract
文档视觉问答(Document Visual Question Answering)中的证据区域精准定位对提升模型可解释性与可信度至关重要.然而,现有方法多采用单步定位,在页面语义复杂或证据区域微小时难以有效区分证据与无关内容,导致边界模糊和定位错误。为此,本文提出基于Wasserstein梯度流的渐进式证据定位框架,将证据定位转化为概率分布的最优传输优化问题;由于连续梯度流在实际中难以求解,本文采用Jordan-Kinderlehrer-Otto(JKO)格式进行离散优化,并推导出可端到端训练的损失函数,将理论框架转化为神经网络可优化目标,实现证据区域由粗到细的精准刻画.实验表明,本文方法在证据定位和答案生成上显著优于现有方法。
PART 1
研究动机
为有效实现证据区域精准定位,早期研究主要依赖预训练文档理解模型对页面进行整体编码,代表性工作包括LayoutLM系列,然而由于缺乏对证据来源的显式建模,其推理过程难以被解释。
为缓解这一问题,近期研究开始引入显式的证据区域定位机机制EaGERS提出可解释流水线,通过在可配置网格上计算多模态嵌入相似度并结合多数投票,将自然语言推理映射到页面子区域,从而约束答案生成;DocVXQA则进一步将可解释性形式化为学习目标,通过视觉注意力热力图高亮关键区域,在保证答案准确率的同时提升预测的可追溯性。
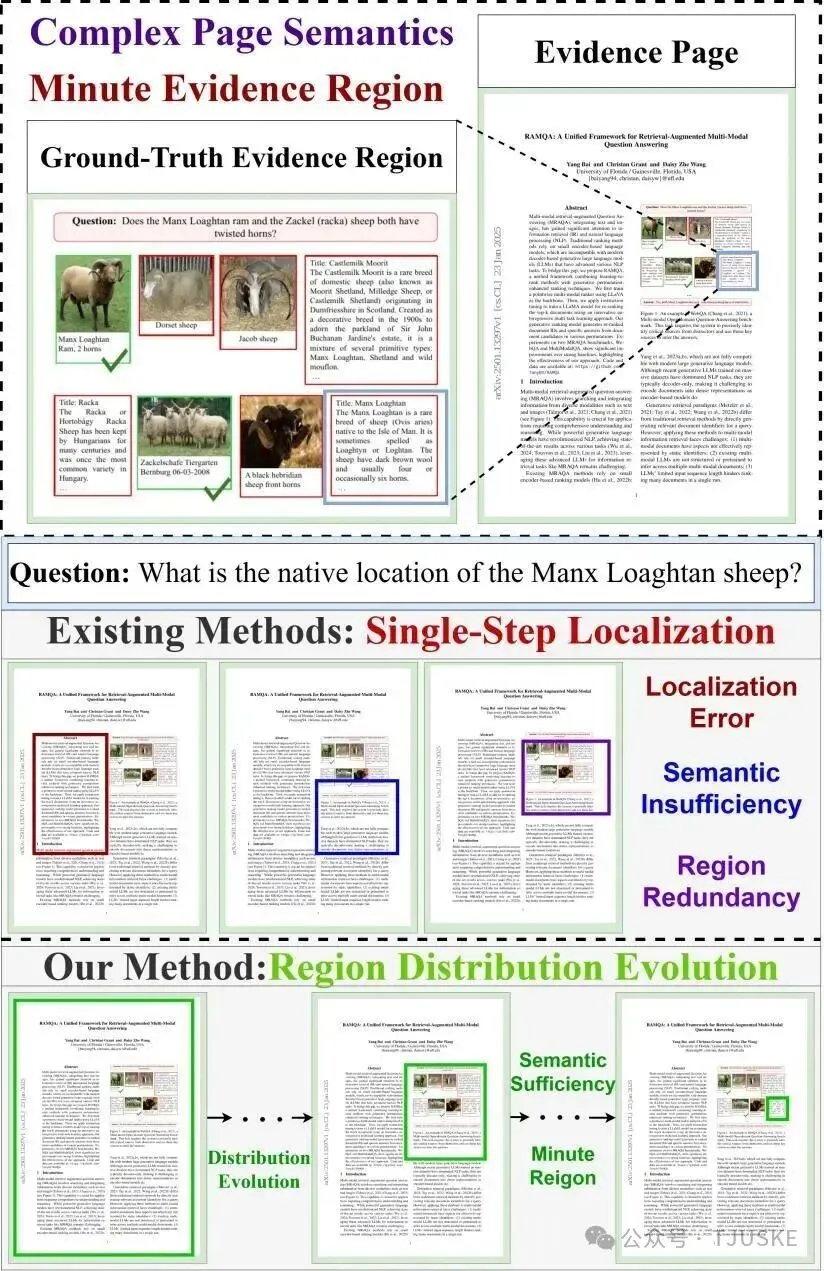
然而,如图所示,上述方法大多采用从页面到证据区域的单步定位范式,缺乏由粗到细的渐进式聚焦过程;当证据页面语义复杂或证据证据仅占页面极小比例时,模型难以有效区分真实证据与无关内容,导致边界模糊、定位错误甚至遗失关键证据,进而削弱答案的可信度与可解释性。
▲图1
现有一步定位方法难以应对页面语义复杂和证据区域微小的场景;本文方法通过渐进式演化实现精准定位与可解释推理。
PART 2
理论分析
为解决上述挑战,本文提出了一种基于Wasserstein梯度流渐进式证据区域定位框架,将证据区域精准定位问题转化为概率分布的最优传输优化问题(定理3.5);通过将证据候选区域分布从初始分布(证据假设分布在整个页面)逐步演化至目标分布(证据分布在真实证据区域),实现证据区域从粗粒度到细粒度的精确刻画。
由于连续时间梯度流在实际中难以直接求解,我们采用Jordan-Kinderlehrer-Otto(JKO)格式对梯度流进行离散优化,将连续演化过程分解为多个离散时间步对分布进行迭代更新。
更重要的是,基于理论推导,我们得到了可端到端训练的损失函数(推论3.11),将理论框架转化为神经网络可直接优化的目标。
此外,在每个演化步,我们提出语义密度更新器参数化候选区域语义密度:将其分解为自身语义密度与条件语义密度:前者基于区域固有语义特征提供筛选先验,后者依据问题语义动态聚焦证据区域,二者协同使演化过程兼具语义稳定性与问题导向的自适应性。该框架通过渐进式演化逐步聚焦关键证据,实现证据区域精准定位与可解释推理。
▲图2
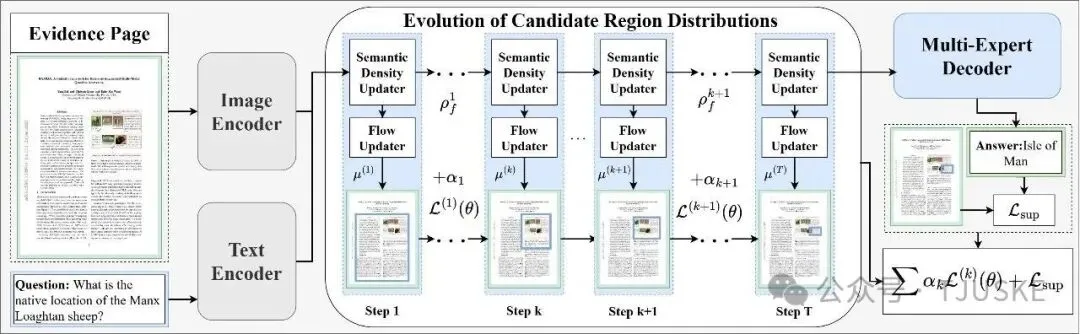
基于Wasserstein梯度流的渐进式证据定位框架
2.1
问题形式化定义
给定文档D、证据页面P*及问题Q,证据区域精准定位旨在找到映射函数同时预测答案A与证据所在区域的集合B* ;预测的证据区域R应尽可能满足语义充分性与空间极小性。
▼
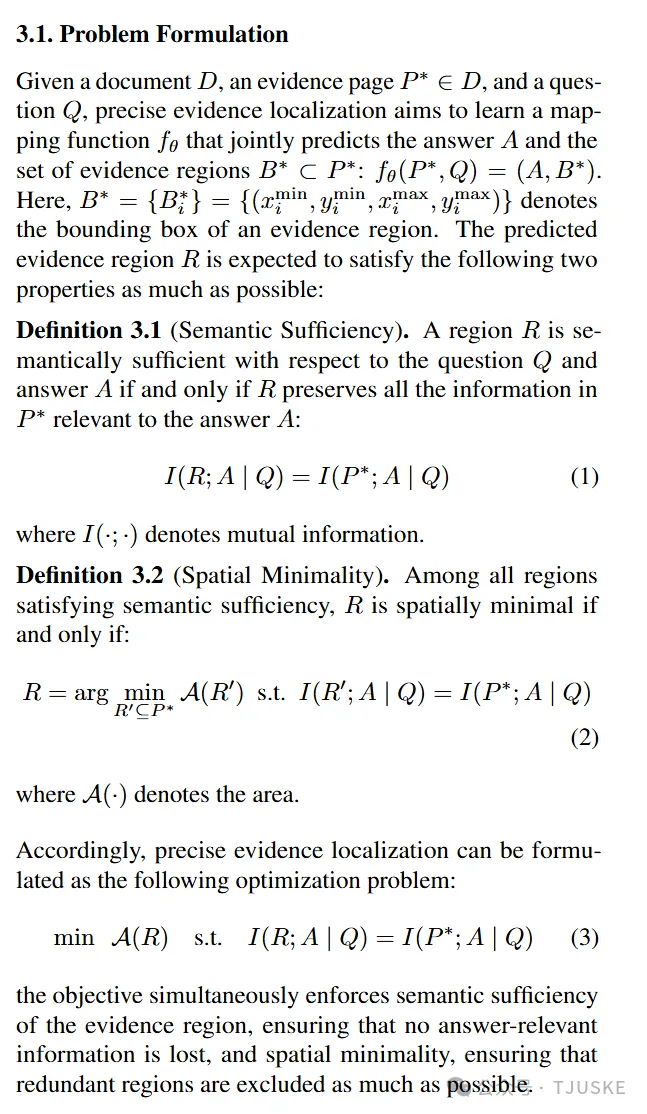
为将Wasserstein梯度流应用于证据区域定位,我们设计能量泛函以编码语义充分性和空间极小性。
▼
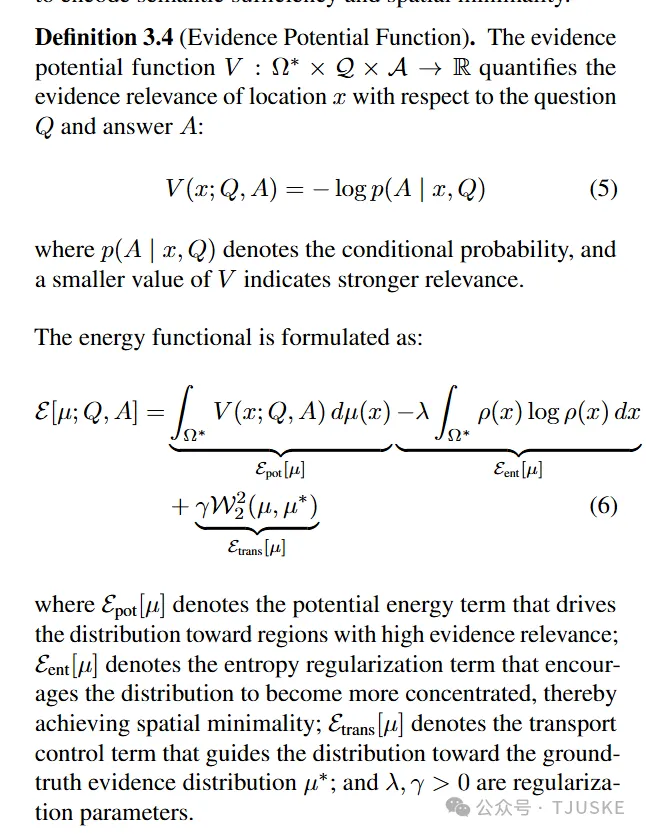
势能项,驱动分布向高证据相关性区域集中;熵正则项,驱动分布集中以实现空间极小性;控制项,控制分布向真实证据区域分布演化;
基于上述能量泛函,我们将证据区域精准定位问题转化为Wasserstein梯度流优化问题:
▼
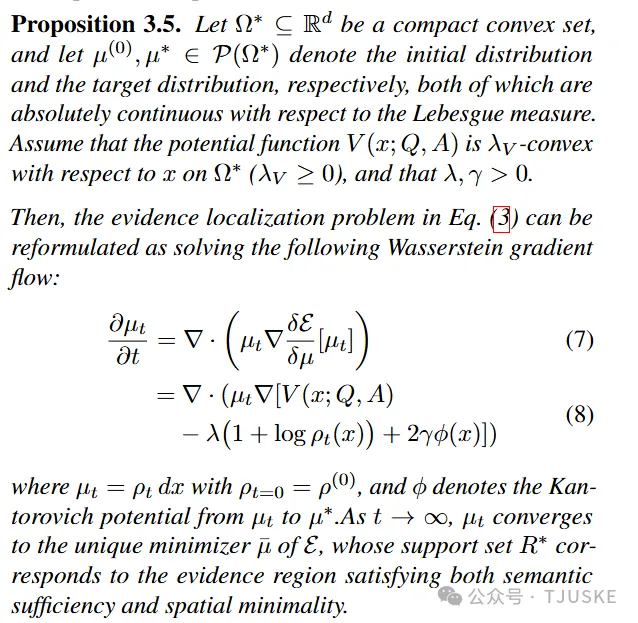
虽然上述奠定了理论基础,但连续梯度流难以直接求解。我们采用Jordan-Kinderlehrer-Otto (JKO)格式将其离散化并转化为逐步优化问题,最终推导出端到端可训练损失函数。
▼
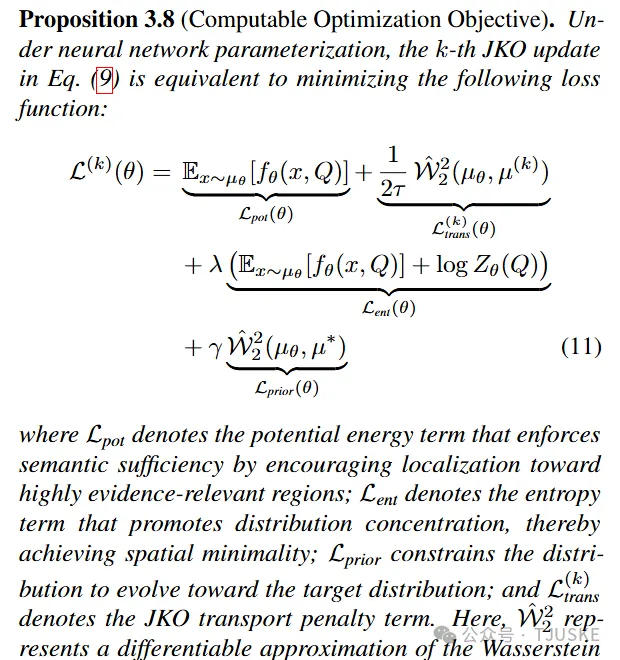
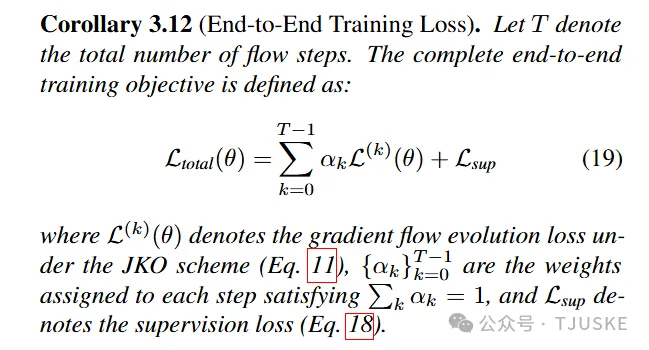
实现端到端训练并将初始分布演化至目标分布,每个演化步包含语义密度更新器与流更新器。前者基于信息论链式法则融合自身语义密度与条件语义密度,后者进行候选区域分布的一步迭代。
▼
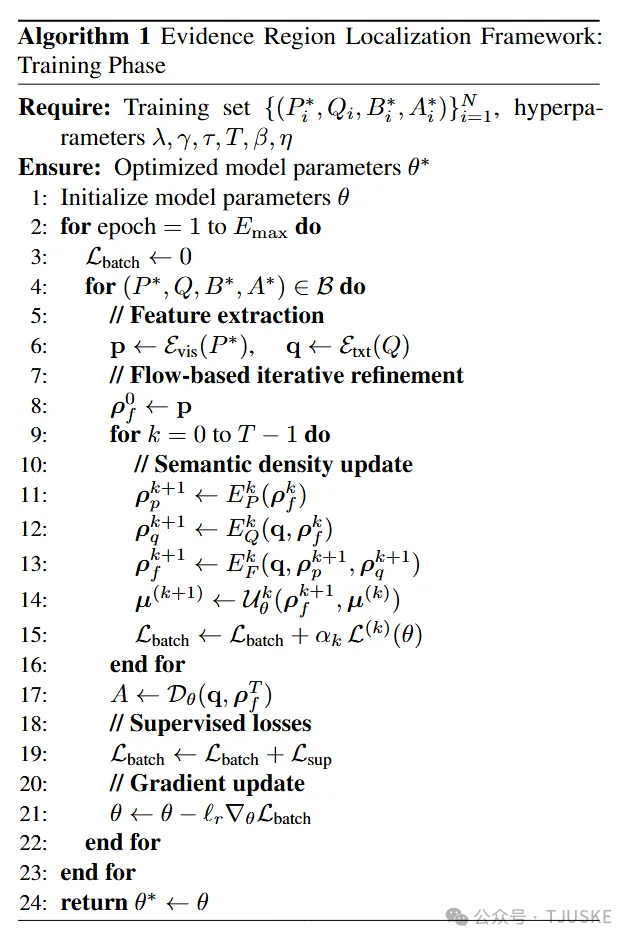
最终,整个框架的完整流程如图2所示。对于给定证据页面P*和问题Q,预训练的视觉编码器和文本编码器分别提取视觉表示和语义表示。随后,候选区域分布从初始分布经T步Wasserstein梯度流演化至目标分布;在第k步演化中,语义密度通过流式语义密度更新器和流更新器迭代更新,实现从粗粒度到细粒度的渐进式证据定位。
PART 3
实验验证
我们在三个基准数据集上评估并与五种方法比较;答案生成质量采用EM、F1和ANLS指标;证据定位精度采用mAP@IoU指标,全面评估不同定位精度要求下的性能。
表1展示了本文方法与各基线在三个基准上的对比结果。本文方法在数据集证据区域占比极小且页面语义密集设定下的优势表明,Wasserstein梯度流所诱导的渐进式演化能够有效细化证据边界,缓解既有方法在边界模糊与定位不稳定方面的固有缺陷。答案生成指标的提升,这源于本文框架中定位与生成之间的紧密耦合:更清晰的证据边界降低了传递至答案解码器的上下文噪声,从而促使模型生成更为忠实的答案。
▼
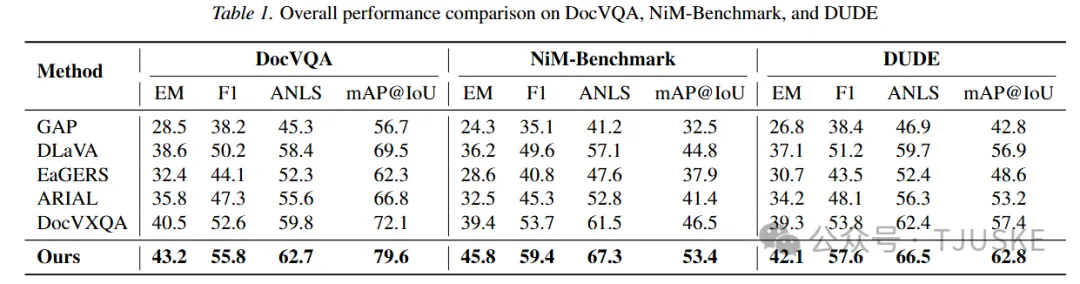
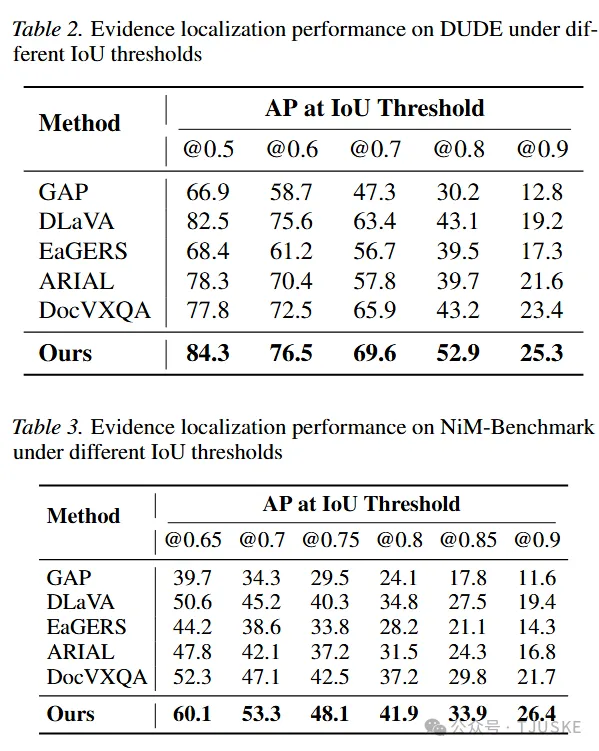
表2和表3展示了模型在不同交并比阈值下的证据定位精度。随着交并比判定标准愈发严格,本文所提方法不仅能够精准定位有效证据区域,还可以更精确地勾勒出证据的空间边界。
上述优势直接得益于本文提出的渐进式演化机制。该机制沿着能量泛函的梯度方向,在分布空间中逐步迁移概率值,不断优化候选证据分布,最终使其收敛至真实的证据边界。因此,即便在严苛的匹配标准下,该模型依旧能保持较高的定位置信度。即便面对证据区域通常仅占文档页面的极小部分的困难情况,本文方法在高交并比阈值下仍表现稳定,进一步印证了该机制在小目标、稀疏证据场景中的有效性。
▼
PART 4
总结
本文提出了一种基于Wasserstein梯度流的渐进式证据区域定位框架。通过将证据区域精准定位问题转化为概率分布的最优传输优化问题,并基于JKO离散化格式推导可端到端训练损失函数,将理论框架转化为神经网络可直接优化的目标,实现从粗粒度到细粒度的渐进式演化。实验表明,该框架在证据定位与答案生成上显著优于现有方法;同时提供了可解释的渐进式推理过程.为提升DocVQA中可靠与可追溯推理提供了新思路。
作者介绍
王浩森
王浩森,2024级博士。研究方向:多模态大模型,多模态大模型幻觉缓解,多模态文档视觉问答,多模态视频理解
关于我们
天津大学知识科学与服务工程实验室聚焦人工智能、知识工程、软件工程等核心领域。近年来,实验室以多模态知识表示与推理为主线展开系统研究,研究范畴涵盖大模型的规则学习、知识图谱构建、软件安全、代码生成、多模态理解、多智能体系统、大模型安全及逻辑推理并行系统等方向。实验室在相关基础理论、关键技术与产业应用层面均取得阶段性研究成果。团队致力于为AI大模型建立可表示、可推理与可解释的理论和方法体系,推动大模型性能提升与逻辑可透明化协同演进!
END
作者|王浩森
编辑|杨颖
审核|张小旺