ARTICLE · 1325257
厂商软件栈综述:CUDA、ROCm、oneAPI 与 NPU 工具链
「AI 编译器软件栈」系列第 27 篇,进入第五部分「厂商软件栈」,也是本系列的收官综述。前面从 LLVM Pass、MLIR、TVM/XLA/Triton/torch.compile/IREE,一路写到 NVPTX(#25)与 AMDGPU(#26)。编译器再精,最终还是要落到某家厂商的运行时、算子库,以及驱动能加载的二进制。本篇不再深挖某一个后端 Pass,而是把 NVIDIA、AMD、Intel 与常见 NPU 栈放到同一张分层图上,看清「库 / 编译器 / 驱动」的边界。
先交代实测环境:本机仍是一台没有 GPU 的 8 核 Intel Xeon;没有完整 CUDA Toolkit、没有 ROCm / HIP、没有 oneAPI / DPC++、也没有任何 NPU SDK。本机能用的只有:Debian clang / LLVM 19.1.7(含 nvptx64 / amdgcn 后端),以及 /workspace/cudaenv 里 pip 包装的 ptxas 12.9.86、nvdisasm / cuobjdump 13.4.92。下文凡命令与输出,都来自本机;cuDNN、TensorRT、MIOpen、oneDNN、CANN 等一律只核官方文档,不编造版本号、性能数字或未测路径。
一、为什么最终要落到厂商栈
开源 AI 编译器解决的是「图怎么切、算子怎么生成、怎么调调度与内存」。真上卡之后,还有三件事躲不开:设备发现与内存拷贝(运行时)、卷积 / GEMM / 注意力等高频算子的手写或半自动内核(库)、以及驱动 / 固件认不认你的二进制。厂商栈把这三件事捆在一起卖;框架与开源编译器则选择「调用库」或「自己出内核再交给运行时加载」。选型时若分不清层,就会把「缺驱动」当成「编译器 bug」,或把「库没装」当成「模型没融合好」。
动机可以收成一句话:把部署路径拆成可替换的层,才能判断哪一层该换厂商、哪一层该换开源编译器。
二、共性分层模型
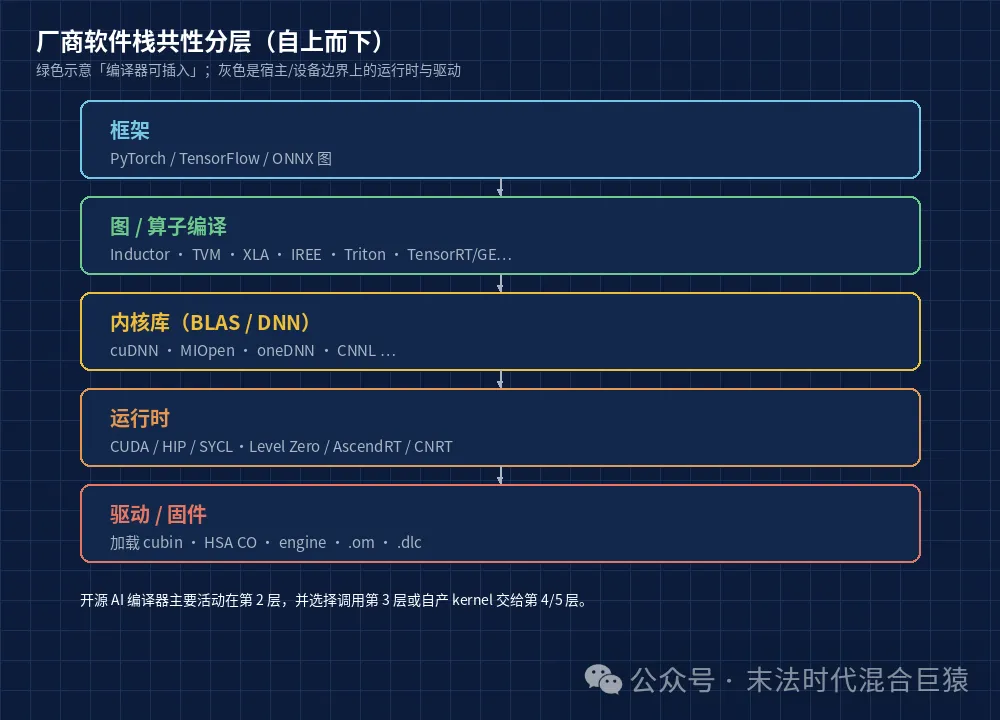
多数加速器栈可以压成五层(自上而下):
1. 框架:PyTorch / TensorFlow / ONNX 图。
2. 图 / 算子编译:框架自带编译器(如 Inductor)、独立编译器(TVM、XLA、IREE、Triton)或厂商图编译器(TensorRT、GE、MagicMind 等)。
3. 内核库:BLAS / DNN 原语(cuBLAS/cuDNN、rocBLAS/MIOpen、oneDNN、CNNL 等)。
4. 运行时:CUDA Runtime、HIP Runtime、SYCL / Level Zero、Ascend Runtime、CNRT 等——负责上下文、流、内存、kernel launch。
5. 驱动 / 固件:把 code object / cubin / OM 等装进设备。
伪流程(部署路径,不是算法):
输入:训练好的模型图 G,目标设备 D1. 前端导入 G(框架图 / ONNX / StableHLO …)2. 图优化若干遍:常量折叠、算子融合、布局改写、精度校准3. 对每个算子节点择一: (a) 调用厂商内核库 API (b) 编译器生成的自定义 kernel4. 打包为设备可加载产物 E(engine / code object / .om / .dlc …)5. 运行时在 D 上分配缓冲、enqueue、同步代价:步骤 2–4 的「引擎构建」往往远重于单次推理;构建可离线做,推理走步骤 5。复杂度这里用定性说法更合适:图优化遍数与候选 kernel 搜索空间决定构建时间;构建一次、推理多次时,摊销后才划算。硬套大 O 没有统一输入规模,本文不写。
三、NVIDIA:CUDA → 库 → TensorRT
NVIDIA 栈最常见的阅读方式是三截:
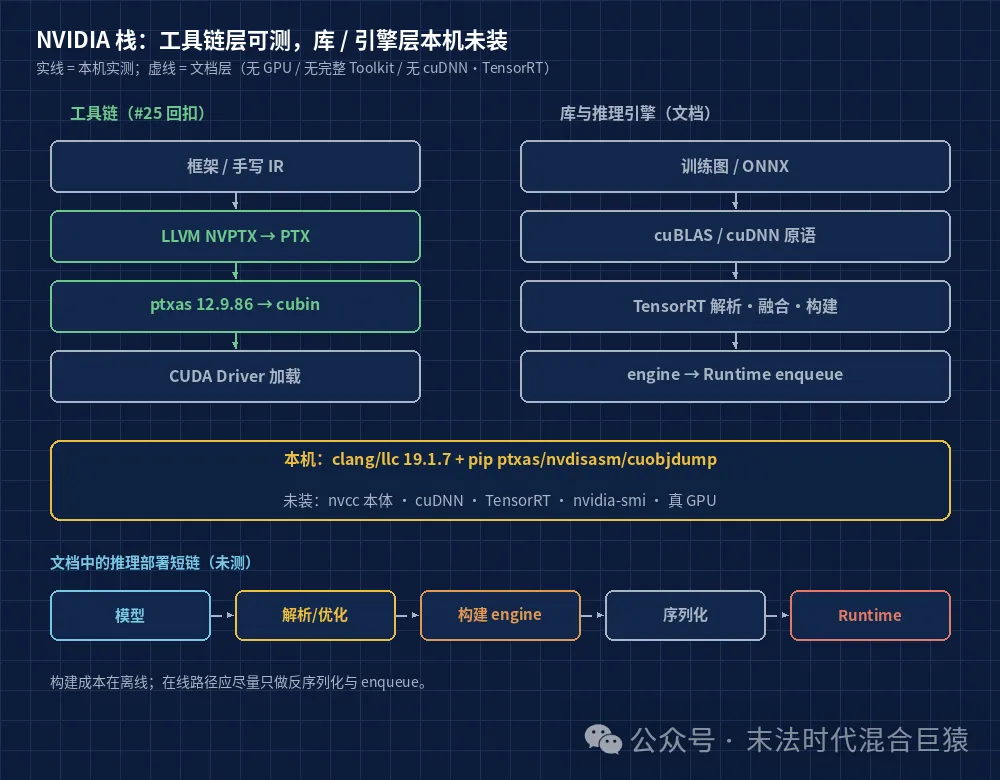
CUDA:编程模型 + 编译工具(nvcc / 设备侧 LLVM)+ Runtime / Driver。#25 已实测「LLVM IR → PTX → ptxas → cubin」;本机仍无 nvcc本体、无nvidia-smi、无 GPU。数学 / DNN 库:cuBLAS(稠密线性代数)、cuDNN(卷积、注意力、归一化等原语)。框架训练路径大量经 cuDNN / cuBLAS,应用很少直接写 cuDNN C API。 TensorRT:面向推理的图优化器 + 运行时。文档描述的典型路径是解析网络(含 ONNX)、做层融合 / 精度校准 / kernel 选型,再构建硬件相关的 engine;engine 与具体 GPU 代际绑定,换卡通常要重建。构建阶段可以很重(多遍图改写与策略搜索),一旦 engine 落盘,在线路径主要是反序列化与 enqueue——这和前面伪流程里「离线构建、在线步骤 5」一致。
和 #25 的衔接:开源编译器若走 NVPTX,产物停在 PTX/cubin,再由 CUDA 驱动加载;若走「调用库」,则根本不经过你的 CodeGen,而是在运行时调 cuDNN。TensorRT 介于两者之间:它自己做图级优化,内部既会调库,也会生成/挑选专用 kernel。还要注意 Runtime 与 Driver 的分工:用户态 CUDA Runtime 提供通俗 API,真正与内核模块对话的是 Driver;缺驱动时,编译工具链(ptxas)仍可能单独工作——本机就是这种状态。本机没有 cuDNN / TensorRT 头文件与 trtexec,库与引擎这一截只核文档。
工具链层回扣(本机实测):
$ clang --version | head -1Debian clang version 19.1.7 (3+b1)$ llc --version | head -2Debian LLVM version 19.1.7$ ptxas --version | tail -3Cuda compilation tools, release 12.9, V12.9.86Build cuda_12.9.r12.9/compiler.36037853_0$ command -v nvcc cudnn_version trtexec || true(均为 not found)本篇还用最小 IR 再跑了一次 llc -march=nvptx64 -mcpu=sm_80 → ptxas -arch=sm_80,确认 pip 包装的汇编器仍可用;这只证明「编译工具链层」,不证明 Runtime / 库 / 推理引擎。
四、AMD:ROCm / hipBLAS / MIOpen
ROCm 是 AMD 的 GPU 计算栈。相对 NVIDIA,它在「设备编译」一侧更开源:#26 已在本机用 LLVM AMDGPU 后端直接产出 GCN/RDNA ISA 与 HSA code object。库与运行时一侧,文档里的对应关系大致是:
HIP Runtime:宿主侧启动与内存,对标 CUDA Runtime。 rocBLAS / hipBLAS:原生 BLAS 与可切换后端的 BLAS 封装;hipBLAS 可 marshal 到 rocBLAS 或 cuBLAS。 MIOpen:深度学习原语库,对标 cuDNN;HIP 后端默认可走 rocBLAS,并可选用 hipBLASLt 等。
和 NVIDIA 对照时,容易混的一点是:AMDGPU 后端「开源直出 ISA」并不自动等于 MIOpen 已装好。前者是 CodeGen 路径,后者是库路径;缺库时,框架仍可能通过自定义 HIP kernel 或开源编译器生成的 code object 跑起来,只是高频原语要自己补。本机 /opt/rocm 不存在,hipcc / rocminfo / miopen 均未安装;#26 里 clang -x hip 已报缺少 HIP runtime 与 ROCm device library。因此本节全部是文档层:能确定的是组件命名与分层位置,不能确定本机可复现的 API 调用序列或性能。
五、Intel oneAPI:DPC++ / oneDNN / Level Zero
oneAPI 把「跨架构」写成公开规格与参考实现。和本系列相关的三块是:
DPC++:基于 LLVM/Clang 的 SYCL 编译器,单源 C++ 可下沉到 CPU / GPU 等。 oneDNN:深度学习原语库(对标 cuDNN / MIOpen),可被框架与编译器后端调用。 Level Zero:偏底层的设备管理 API(发现、内存、提交、同步);Intel 的 SYCL 运行时可以把 Level Zero 当作 GPU 后端。
对编译器作者而言,oneDNN 常作为「可插拔加速库」出现在 XLA / oneDNN Graph / 框架后端里;Level Zero 则更像「自己写运行时」时的底座,而不是日常训练脚本直接调用的层。本机检查:dpcpp / icpx / sycl-ls 均不存在,/opt/intel 不存在,也没有 libze_*。系统只有通用的 ocl-icd-libopencl1,不等于装了 oneAPI。结论:未装,只能文档层对照分层。
六、NPU 与其他:主机编译 + 设备运行时
华为昇腾 CANN、寒武纪 NeuWare、高通 QAIRT / SNPE / QNN 等,产品名不同,文档里反复出现同一模式:主机侧做模型转换、量化、图优化与算子编译,生成设备可执行物;设备侧由运行时加载、调度到 NPU(以及可选的 CPU/GPU)。对照时只记共性,不编造未核过的具体 API:
昇腾 CANN:AscendCL(应用 API)、Graph Engine、Runtime、算子库与驱动;离线模型常见经 ATC 等到 .om。寒武纪:CNRT 运行时、CNNL 算子库、BANG 语言与 CNCC、推理引擎 MagicMind。 高通:QAIRT / SNPE / AI Engine Direct(QNN)等,把框架模型转为 .dlc或上下文二进制,再在 HTP(NPU)/ GPU / CPU 上执行。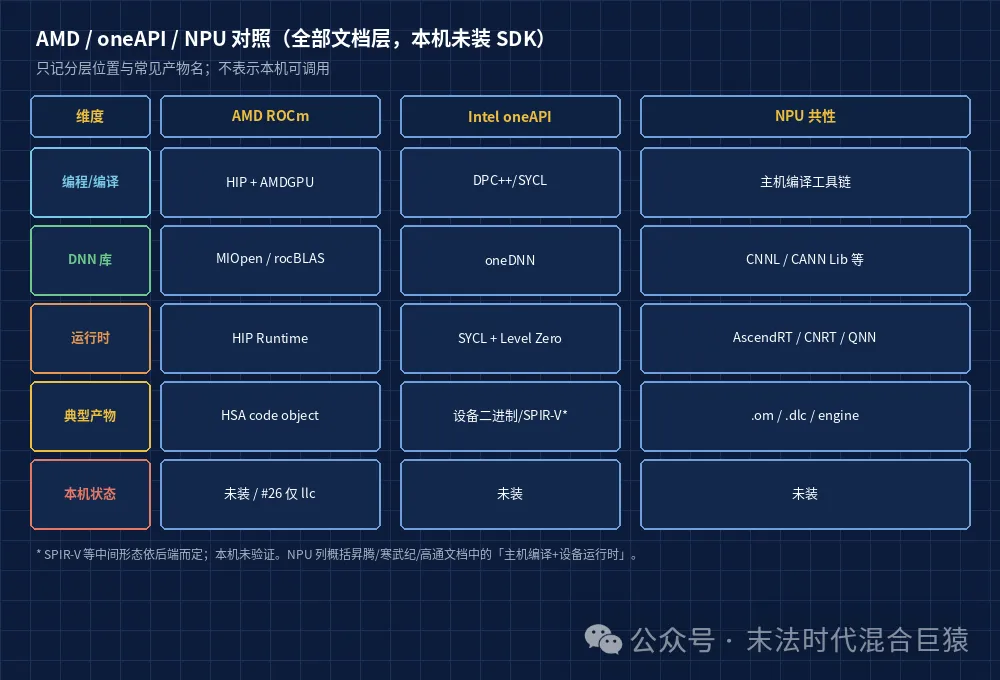
本机无上述任一 SDK,命令 atc / cncc / qnn-net-run 均 not found。上表只作结构对照。
七、和系列前篇的接口关系
开源编译器「吃」的是中间层契约;厂商栈「提供」的是库符号、运行时 API 与可加载二进制格式。
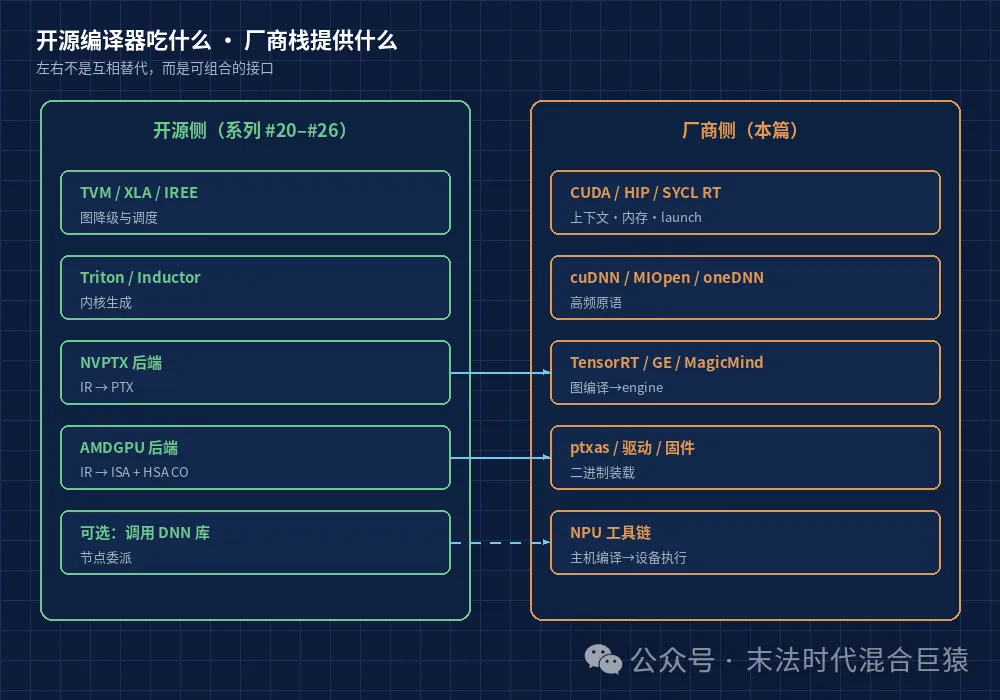
TVM / XLA / IREE / Triton / torch.compile:可以生成 NVPTX / AMDGPU / 其他后端代码,也可以把节点委派给 cuDNN、MIOpen、oneDNN、TensorRT 等。 #25 NVPTX:吃 LLVM IR,吐 PTX;再交给 ptxas / 驱动。CUDA Runtime 负责 launch,不是 NVPTX 后端的职责。 #26 AMDGPU:吃 LLVM IR,吐 ISA + HSA code object;ROCm 用户态负责加载。rocBLAS / MIOpen 是另一条「不经你的 CodeGen」的路径。 厂商图编译器(TensorRT、GE、MagicMind、QAIRT 等):吞框架图 / ONNX,自己做融合与 kernel 选型,输出 engine;与「自写 Triton kernel」是并列选项,不是同一层的替代品。 实操上的接口清单很短:中间表示(LLVM IR / MLIR / ONNX)、库符号(DNN/BLAS)、运行时 launch API、以及最终二进制格式。开源栈只要守住其中一到两项,就能嵌入厂商生态;想「完全绕过厂商」通常只在有开放 ISA 且自备运行时的路径上成立——AMDGPU+自管 HSA 加载接近这一端,NVIDIA SASS 规格不开放则很难。
八、收束:边界与未测项
选型时先问三层:要的是库里的现成原语、编译器生成的自定义 kernel,还是驱动已能加载的打包引擎?层界清楚,排错才不会串。本系列从 LLVM 算法写到厂商边界,能钉死的是编译与工具链侧的结构;真卡上的延迟与吞吐,需要在有设备的环境另测。
本机实测:
LLVM 19.1.7: llc注册nvptx64/amdgcn;clang/llc版本如上。pip: nvidia-cuda-nvcc-cu1212.9.86(含 ptxas)、nvidia-cuda-nvdisasm/nvidia-cuda-cuobjdump13.4.92;最小 IR → PTX → cubin 跑通。否定项: nvcc、nvidia-smi、hipcc、dpcpp/icpx、trtexec、NPU 工具均不存在;无 GPU。
未实测:cuDNN / cuBLAS / TensorRT 任何 API 与引擎构建;ROCm 运行时与 MIOpen;oneDNN / Level Zero 设备枚举;CANN / 寒武纪 / 高通 SDK;一切性能数字。
参考:NVIDIA CUDA Toolkit / cuDNN / TensorRT 产品说明;AMD ROCm 文档(hipBLAS、MIOpen);Intel oneAPI / DPC++ / Level Zero / oneDNN 说明;华为昇腾 CANN、寒武纪 NeuWare、高通 AI Engine 架构文档;本系列 #22–#26;本目录 demo/ 命令与日志。