ARTICLE · 1326443
【AI工具链】跟着敲一遍⑲:一次排障写成深度文
 .
 .
 阅读本文

系列:跟着敲一遍 · 21 天本地 AI 工具链 Day 19(第 19/21 篇) 前情:⑱ 讲完脚本怎么整理;⑲ 换个角度,讲一次翻车怎么写成文章。
实测对象:⑫ 那篇 35316 字的排障长文,以及它的初稿
同样一次"vLLM 起不来",可以这么写:
流水账版:今天我准备部署 vLLM。先拉了镜像,然后启动容器,结果端口不通。我以为是还没加载完,就等了一会儿,还是不通。查了日志没看出问题,又改了 dtype,重启,还是不通。后来发现是 CPU 不支持 bf16,改成 float32 就好了。
也可以这么写:
深度版:容器
Up着,日志在读权重,但curl返回000。三个信号互相矛盾——如果它在正常加载,端口不该拒连;如果它崩了,容器不该还 Up;如果它卡住,日志不该还在动。这三个矛盾里,一定有两个是我的误读。后来的三天,我做的事就是把它们一个个排掉。
两段说的其实是同一件事。 差别不在文笔,在第一句话的功能:
流水账的第一句在交代背景 深度文的第一句在制造矛盾
读者不是因为"你遇到了困难"才读下去,是因为"三个信号互相矛盾"——这句话让他想知道答案。
先看病的症状。翻车文写成流水账,通常有这三个特征。
特征一:按时间写
09:00 起容器09:05 端口不通09:10 改 dtype09:15 重启09:20 还是不通09:30 查日志 ...
时间顺序是作者视角,不是读者视角。
作者的时间线里,90% 的内容是"试了 A 不行,试了 B 也不行"。而读者想知道的是"哪一步是关键"。按时间写,等于让读者陪你走一遍全程,自己去挑重点。
特征二:只写结论,不写判据
"我查了一下,发现是 CPU 不支持 bf16。"
这句话跳过了最有价值的部分:你怎么知道的?
读者真正需要的不是"CPU 不支持 bf16"这个事实(这个他 Google 一下就有),而是"在一堆可疑因素里,怎么锁定到它"。
特征三:不写排除
翻车文最容易漏掉的,是那些被排掉的可能性。
"我怀疑是磁盘坏了,后来发现不是"——这一句往往被删掉,因为它"没有结论"。但恰恰是这一句告诉读者:我考虑过这个方向,并且用证据否掉了它。
没有排除,读者会想:"那磁盘坏没坏?你怎么知道不是?"
💡 一句话总结流水账:它记录了发生了什么,但没记录你怎么想的。
而"怎么想的"才是别人能搬走的东西——因为下次他遇到的是另一个故障,事实不同,思路可复用。
它不是一条时间线,是一棵判断树。
现象├─ 假设 A(能解释现象吗?不能 → 排除)├─ 假设 B(能解释吗?部分能 → 继续查)└─ 假设 C(能解释全部现象 → 根因)
所以深度文的骨架应该是四层,而不是时间线:
| 一 | ||
| 二 | ||
| 三 | ||
| 四 |
这四层有个顺序要求:必须先有矛盾,才谈证据。
因为读者不知道"端口 000"有什么稀奇——每天都有服务没起来。只有当你指出"容器 Up 着、日志还在动、端口却拒连"这三个事实互相矛盾,他才意识到这不是普通的启动失败。
流水账写法 vs 深度写法
Up,日志在读权重,curl 返回 000——这三个信号不可能同时为真。" |
差别在于:前者陈述了一个状态,后者陈述了一个冲突。
冲突会逼读者站队:他会在心里判断"那到底是哪一个错了?"——一旦他开始判断,他就进文章了。
怎么找矛盾
方法很简单:把同一时刻的所有信号列出来,看哪些不能共存。
以 ⑫ 那次为例,同一个 5 分钟窗口里有四个信号:
Up | ||
000 | ||
单看任何一个都正常。四个放一起,就矛盾了:内存停了说明加载完了,加载完了端口就该通,可它就是不通。
💡 矛盾不是"找出来的",是"列出来的"。
你不需要灵光一闪,只需要把同一时刻的 4-5 个指标写在一张表里,然后问一句:这些能同时为真吗?
反例:那个 4062% 不是证据
当时我看到:
[root@LinuxPythonWorkshop ~]# docker stats --no-stream --format '{{.CPUPerc}}' vllm-server 4062.52% 第一反应是"40 个线程在狂算,把机器压死了"。
但这个数字是假的。 8 核机器的物理上限是 800%。4062% 在物理上不可能。
如果我把它当证据写进文章,读者会学到错的结论。正确的做法是:先怀疑这个数字本身。
后来查清楚了:docker stats 在容器刚启动、采样窗口不完整时会给出失真值;而虚拟机停顿会让 CPU 时间统计本身失真。
⚠️ 一条判据:任何一个超出物理上限的数字,都不能当证据,只能当"待解释的异常"。
正例:两个数字互相印证
真正有说服力的是下面这组:
# ① 只测镜像 + Python 启动real 0m11.304suser 0m0.024ssys 0m0.029s# ② 测框架导入real 0m53.117suser 0m0.022ssys 0m0.027s
为什么这组比单个数字强?因为它能做三个判断:
判断一:慢的不是 torch。 正常 print('ok') 是 0.5~1 秒,这里是 11.3 秒,劣化约 10-20 倍;正常 import torch 是 3~5 秒,这里 53.1 秒,劣化约 10 倍。两个倍数一致——如果是 torch 装坏了,实验一应该是 1 秒。
判断二:不是算力不足。user + sys 加起来只有 0.049 秒。53 秒里 CPU 几乎没干活,全在等。这是纯 I/O 等待的特征,不是"CPU 太慢"。
判断三:反推出了一个可验证的数值。 按 5~6 MB/s 的读取速率,torch 那几百 MB 的 .so 文件正好要 50 秒左右——和实测的 53 秒对得上。
💡 好证据的标准:它能不能同时支撑"是 A"和"不是 B"?
只能证明"是 A"的,是观察;能证明"不是 B"的,才是证据。
⑫ 那篇里,我写了两个走错的方向。这两段是我认为整篇最该保留的部分。
弯路一:以为外接硬盘掉了
看到日志里 usb 2-2: reset,第一反应是移动硬盘掉线——因为你不会去怀疑虚拟机。
但一条命令就能否掉:
[root@LinuxPythonWorkshop ~]# lsusb -t...VMware Virtual USB MouseVMware Virtual USB HubVMware Virtual Bluetooth Adapter
三个设备全是 "VMware Virtual"。 这些是虚拟 USB 控制器,不是真的外接盘。
再加一条 lsblk:只有一个块设备 sda 80G TRAN=spi HOTPLUG=0,热插拔属性是 0,说明根本没有可插拔设备。
结论从"盘坏了"改成"虚拟化层有问题"。 这个转向决定了后面所有排查方向。
弯路二:以为磁盘坏了
第二个错误方向:读到权重的速率只有 6.4 MB/s,怀疑盘要坏。
否掉它的证据是一条"没有":
[root@LinuxPythonWorkshop ~]# dmesg -T | grep -iE "sd[a-z]|ata[0-9]|I/O error" (无输出) 整轮排查下来,dmesg 里一条磁盘错误都没有,SMART 也正常。
💡 "没有证据"也是一种证据。
这里的关键是:如果盘真坏了,内核一定会报错。 没报错,就说明慢的原因不在盘的硬件层——要么是虚拟化层,要么是别的。
记住这句话:"我没看到 X" 只有在"如果有 X 就一定会看到"时,才构成证据。
为什么排除值得写
读者的处境通常是:他心里也有一堆猜测(是不是内存?是不是盘?是不是版本?)。
你不把他的猜测一个个否掉,他就没法把你的结论装进去。 因为他的脑子里还留着"可能是盘坏了"这个念头,读到你的答案时会想"那盘的事呢?"
排除段的作用,就是先清空他的假设,再给他答案。
判断一个根因是不是真的,有个很硬的标准:
它能不能解释全部现象?只要有一个现象解释不了,它就还不是根因。
⑫ 那次的关键现象是五个互不相干的子系统同时超时:
soft lockup - CPU#1 stuck for 21s | ||
hung_taskD 状态 120s+ | ||
flip_done timed out-110 |
用两个候选根因去套:
| 显示和 USB 为什么不响应?它们不抢 CPU | ||
| 显示和 USB 不经过那块盘 | ||
| "vCPU 一段时间没被 hypervisor 调度" | 全部五个 |
只有第三个能解释所有现象。 所以它才是根因。
💡 这就是"一个根因"和"一堆原因"的区别。
前者能统一解释,后者只是罗列。写文章时如果发现要写"原因有五个",多半是还没找到那个能统摄全部的那个。
⑫ 的实际分布正好相反。
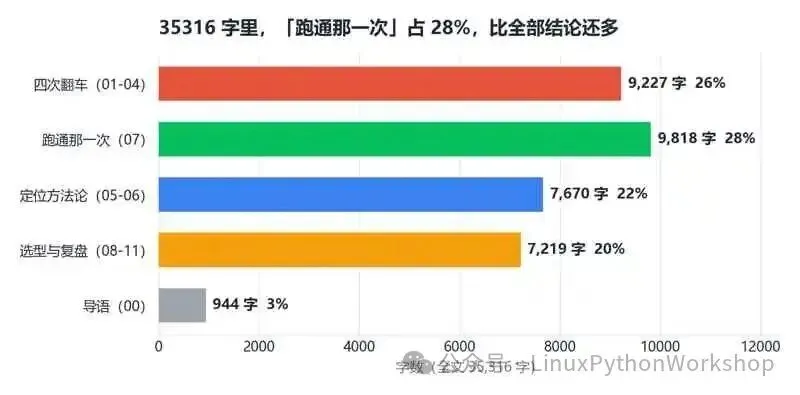
图:35316 字里,四次翻车占 26%,"跑通那一次"占 28%,而选型与复盘四节加起来只占 20%。
| 跑通那一次(07) | 9818 | 28% |
为什么"跑通"最长
因为读者读到这里,脑子里只有一个问题:"那到底怎么成的?"
前面写了几千字的失败,如果最后只用一段"后来换成 0.5B 就好了"收尾,读者会觉得被骗——他想看的正是最后那一步的细节:
预算怎么算的(5.2 GiB < 7.21 GiB) 启动参数改了哪四处,每处为什么 时间怎么花的(12 分 40 秒,其中 warmup 8 分 06 秒) 速度怎么测的(为什么第一次 262 秒、稳态 4.3 秒) 差点在哪一步误杀自己( load 26.77但D=1)
这些细节只有"成功那一次"才有,失败那几次给不了。
为什么"结论"反而短
结论段的作用是收口,不是展开。
读者已经把过程看完了,他要的是"所以以后我该怎么做"——这种东西一句话就够:"单机单流用 Ollama,vLLM 留给有 GPU 的场景。"
结论写长,往往是作者不放心,怕读者没看懂,于是反复讲。而反复讲会让读者怀疑:是不是你自己也不确定?
💡 篇幅分配的判据:读者最想知道的,写最长。
不是"最重要的写最长"——"最重要"是你的判断,"最想知道"是他的。翻车文里,这两者经常不是同一个。
细节一:小标题用判断句,不用名词
docker kill 之后,进程又活了 11 分钟 | |
判断式标题本身就是信息。 读者扫一遍小标题,就能知道全文的推理路径——不需要读正文。
而且它有个副作用:逼你把这一节的核心结论想清楚。写"排查过程"很容易灌水,写"docker kill 之后进程又活了 11 分钟"就没法灌,因为标题已经承诺了具体内容。
细节二:每个结论后面跟一句"反例"
结论:这台机器的本地磁盘慢到广域网量级。反例:如果是磁盘硬件故障,dmesg 里一定会有 I/O error —— 但一条都没有。
加这一句,读者会相信你查过。 不加,他只会觉得你在猜。
这条对技术文尤其重要,因为技术读者的默认状态是怀疑。你不主动交代边界,他就自己去想"那 X 情况呢",然后带着疑问往下读,注意力被分掉一半。
细节三:把自己的错写进去
⑫ 里有三处明确写"我判断错了":
4062% | |
usb 2-2: reset | |
load 26.77 | D=1 |
第三处最值钱,因为它暴露的是一个方法错误:用了一个含义模糊的指标(load)做阈值,差点杀掉正在成功的进程。
读者从"正确答案"里学不到这个——他只会记住"load 高要小心"。但从"我差点误杀"里,他能学到为什么 load 不可靠(它把 R 和 D 混在一起统计)。
💡 写错处的价值不在坦诚,在"错误暴露了方法的边界"。
一个人的正确答案往往带着运气,但他的错误一定暴露了他的方法哪里不够用。
句式一:制造矛盾
A 说明它在正常 X,B 说明它没有 X —— 这两件事不可能同时为真。 句式二:给判据而不是结论
判断 X 是不是原因,只看一条:<某个可观测的量> 是否 <某个阈值>。 句式三:写排除
如果是 <候选原因>,<某个现象> 一定会出现。但它没有出现 —— 所以不是。 句式四:检验根因
这个原因能解释 <现象 1>、<现象 2>,但解释不了 <现象 3>,所以它还不是根因。 句式五:收口
所以下次遇到同类问题,先看 <A>,再看 <B>,最后才怀疑 <C>。 第五句是结论段的标准写法:给顺序,不给清单。 清单会被忘掉,顺序会被执行。
一、选择题(每题4个选项)
1. 翻车文写成流水账,最根本的原因是?
A. 文笔不好
B. 按时间写,等于按作者视角组织,读者挑不出重点
C. 字数不够
D. 没有配图
2. 深度文四层结构的第一步应该是?
A. 直接给根因
B. 先说排查过程
C. 把现象写成矛盾
D. 列出所有工具
3. 下面哪个不能当"证据"用?
A. user+sys = 0.049s,说明在等待
B. dmesg 零 I/O error,说明盘没坏
C. docker stats 显示 4062%,说明 40 线程狂算
D. 两个测试劣化倍数一致,说明问题在共同层
4. "我没看到 X" 在什么条件下才算证据?
A. 任何情况下都算
B. 如果有 X 就一定会看到时,才成立
C. 只有日志里没有时才算
D. 从来不算
5. 判断一个根因是否成立,最硬的标准是?
A. 它能解释最主要的那个现象
B. 它符合经验
C. 它能解释全部现象,一个都不能漏
D. 有人这么写过
二、填空题(3 题)
1. 排障不是一条时间线,是一棵 ______。
2. 好证据的标准是:它能同时支撑"是 A"和"______"。
3. 结论段的标准写法是给 ______,不给清单。
三、简答题(2 题)
1. 为什么"排除掉的可能性"值得写进文章?请从读者的心理状态说明。
2. 找一次你自己的排障经历,用本文的四层结构列出提纲(不必成文),标出你缺哪一层。
🎁 答对粉丝福利:
将答案按顺序发至评论区, 全部答对的前50位粉丝,将获得:
✅ 赠送完整的《21天工具链实验手册 》
#技术写作 #故障排查 #深度长文 #结构化表达 #AI工具链