ARTICLE · 1326480
从硬件到算法:高通量质谱结合 AI 工具,推动人群代谢组向临床转化
导语
代谢组学以小分子的"生化快照"直接关联表型与临床结局,是精准医学与人群健康研究中最贴近表型的组学层。然而,当研究规模从几十例临床样本扩展到上万人队列时,非靶向质谱代谢组学的短板便暴露无遗:样品通量低、代谢覆盖有限、数据处理复杂、标准化程度差、运行成本高。这些瓶颈叠加研究设计、样本处理与数据预处理的差异,直接催生了一个尴尬的现实——绝大多数已报道的生物标志物无法在独立队列中被重复验证。加拿大麦克马斯特大学(McMaster University)Britz-Mckibbin 团队发表于 Current Opinion in Biotechnology 的这篇综述,系统梳理了面向大规模人群研究(n > 1000)的高通量质谱代谢组学技术壁垒与最新创新:从自动化样品制备、高通量数据采集平台,到数据软件与人工智能工具,为"代谢组学如何规模化"给出了一份完整的技术路线图。
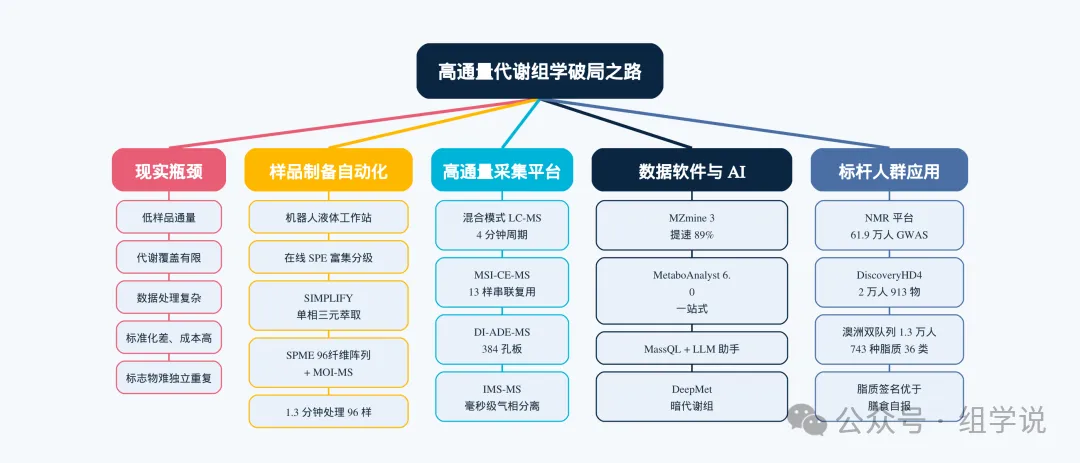
技术路线脑图
一、规模化的三道门槛:通量、覆盖与标准化
目前规模最大的代谢组学研究,是基于核磁共振(NMR)平台对英国与爱沙尼亚生物样本库 619,372 份血浆样本开展的代谢性状全基因组关联研究。NMR 平台稳健且可绝对定量,但浓度灵敏度不足,代谢物覆盖有限。转向质谱平台后,规模上限明显抬升:基于 Metabolon DiscoveryHD4 平台,两个英国队列共 19,994 名个体被一致测定了 913 种血浆代谢物与脂质;而两项澳大利亚队列合计 13,335 名参与者的脂质组学研究表明,反映膳食质量的脂质签名,比膳食自报问卷更能预测心血管代谢健康与全因死亡风险——该研究以靶向 LC–MS/MS 工作流覆盖 36 类共 731 种以上脂质,并利用混合 QC 样本的中位数居中(median centering)校正长期信号漂移带来的批次效应。除规模之外,综述还指出两大结构性问题:其一,多数大规模研究依赖商业化试剂盒与靶向服务,难以报告绝对浓度,无法建立参考区间;其二,代谢物注释与鉴定的标准执行不严,叠加自动软件与 AI 工具的无差别使用,加剧了代谢组学的"可信度危机"。
二、样品制备:从手工操作到全流程自动化
分析前标准化是大规模研究的命门:空腹状态、抗凝剂类型、溶血、处理延迟、长期冻存与冻融循环,都会系统性改写血样中的代谢物浓度。而样品制备恰是劳动密集、变异最大的环节。综述归纳了三条应对路线:机器人液体工作站可将脱盐、富集、分级等步骤与 LC–MS 直接耦合;在线固相萃取(SPE)把洗涤、上样、洗脱与进样整合为一条流水线;简化萃取流程则以 SIMPLIFY 方案为代表——甲醇、甲基叔丁基醚与异丙醇构成的三元单相溶剂,一份提取液即可兼容脂质组、代谢组/暴露组与蛋白酶解肽三种 LC–MS 分析,显著降低多组学研究的样本消耗与操作环节。更具代表性的是 Zhou 等人开发的 96 通道固相微萃取(SPME)纤维阵列与微流控开放接口(MOI)–MS 的联用系统:萃取 20 分钟、洗涤 5 秒后,纤维直接转入脱附腔进行无色谱分离的快速分析,96 个样品的制备仅需 1.3 分钟,单样品仪器分析不足 1 分钟,且携带污染极低。纤维涂层采用混合模式吸附剂,兼具代谢物保留与生物相容屏障(防蛋白吸附)双重功能。
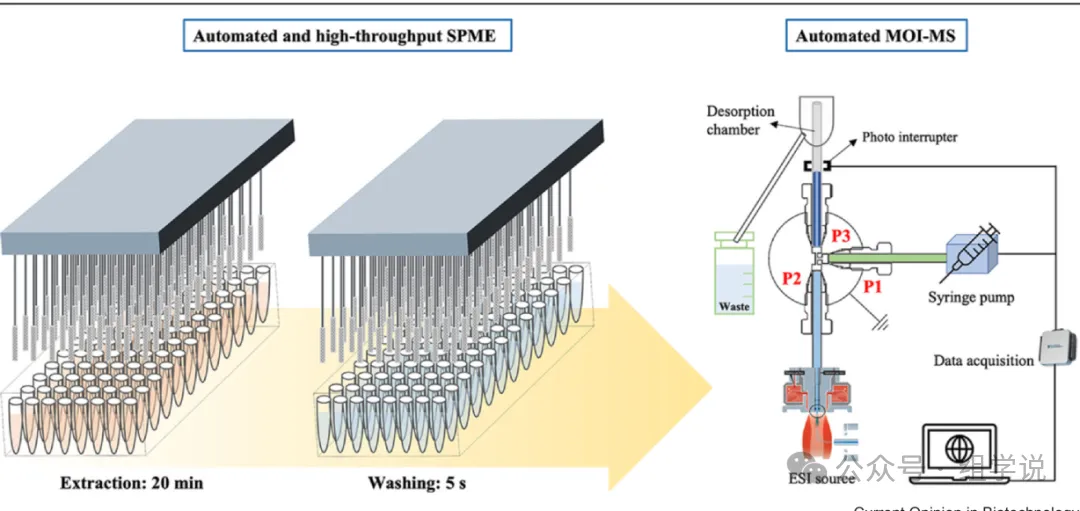
图 1|文献原图:Figure 2 自动化高通量 SPME 96 纤维阵列与 MOI–MS 联用系统
图 1 解读:左侧展示了 96 根 SPME 纤维组成的三维阵列装置,可同时浸入 96 孔样品完成萃取(20 分钟)与快速洗涤(5 秒);右侧为微流控开放接口–MS 的脱附单元,标注了脱附腔(desorption chamber)、三通阀的三个端口(P1、P2、P3)、注射泵与 ESI 电离源的连接关系:纤维洗涤后转入脱附腔,被溶剂直接脱附并送入质谱,全程无需色谱分离。这张图的要点在于"软件控制的并行化":样品制备与仪器分析被拆解为可编程的标准动作,人为操作环节被压缩到极致,这正是高通量与标准化的共同来源。
三、数据采集:更快、更省、更稳的三条路线
色谱分离扩展了电喷雾电离(ESI)–MS 的覆盖面,却拉长了分析周期并引入保留时间漂移。综述梳理了几条"提速不降质"的平台路线:混合模式 LC–MS 利用同时具备阴离子交换与反相保留机制的色谱柱,在三元溶剂梯度下于 4 分钟周期内(含再平衡)分辨不同极性的代谢物、脂质及其异构体,单仪器日通量约 360 个样品,且保留时间稳定性优异;多段进样毛细管电泳–质谱(MSI–CE–MS)通过时间编码复用,在单次运行中串联 13 个样品(约 3 分钟/样品),并内置基于 QC 的批次校正,已在 5000 名巴西儿童全国营养调查的血清代谢组研究中落地;离子迁移谱–MS(IMS–MS)以毫秒级气相分离支撑大规模单细胞代谢组,配合采集后解卷积算法可突破传统单脉冲模式的峰容量与灵敏度限制。而完全放弃色谱的声波液滴喷射(ADE)直接进样–MS则以纳升液滴的无接触转移规避了样品携带污染:Zhang 等人开发的 DI-ADE-MS/MS 平台,在 384 孔板格式下以平行反应监测(PRM)模式于 5 分钟内可靠定量 NIST 标准血浆中 731 种脂质(覆盖 14 类共 1000 种以上脂质),与经验证的 HILIC–MS/MS 协议结果一致,预计日通量超过 280 个样品。
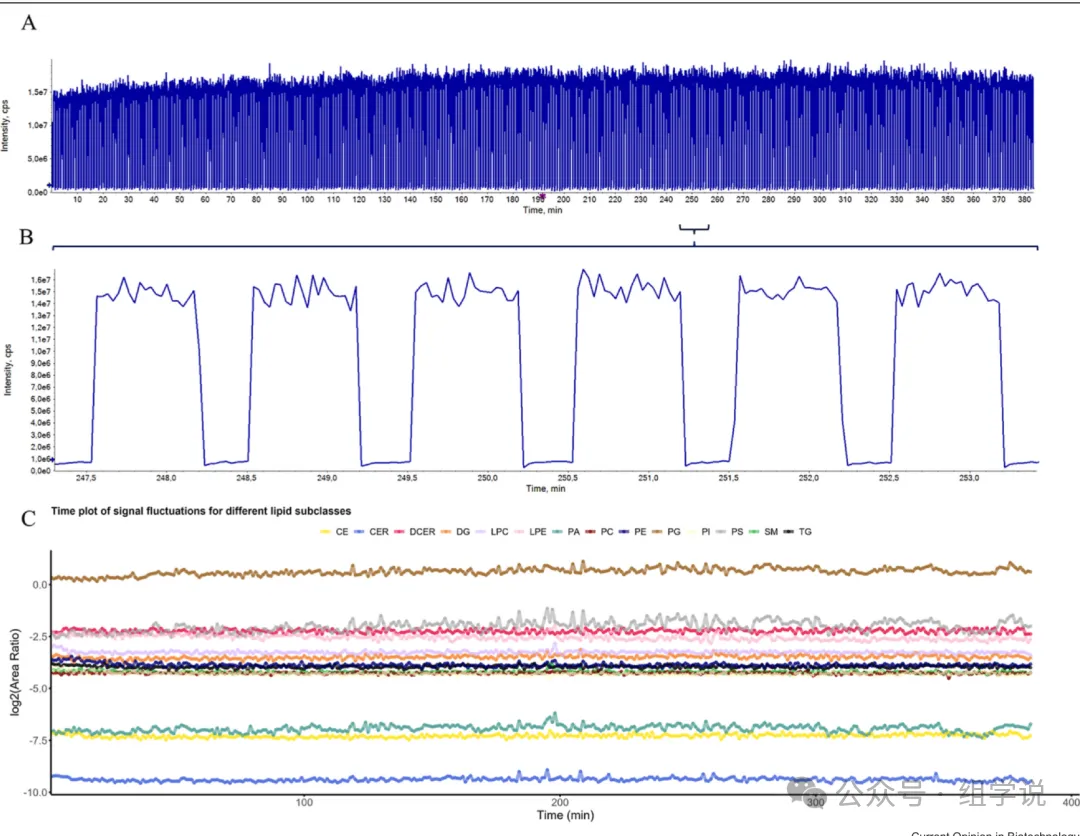
图 2|文献原图:Figure 4 基于 384 孔板的 DI-ADE-MS 高通量血浆脂质提取物分析
图 2 解读:(a) 展示了 384 个血浆样品连续进样的总离子流图——负离子模式下每次进样由 400 个 2.5 nL 液滴组成(合计约 1 μL),信号在数小时的连续采集中保持高度稳定;(b) 为局部放大的总离子流图,相邻孔位重复进样的信号轮廓几乎一致,直观证明无样品携带污染;(c) 为 14 个脂质亚类(胆固醇酯、神经酰胺、鞘磷脂、甘油三酯等)内标随时间的信号波动曲线,各亚类强度比值在长时间尺度上保持平稳。对大规模队列研究而言,仪器信号的长期稳定性直接决定批次效应的强度——这张图用"384 次连续进样"直观呈现了直接进样平台的稳健性底线。
四、标杆案例:1.3 万人的脂质组答卷
如果说前两节回答的是"技术如何提速",那么澳大利亚双队列研究则示范了"规模如何转化为临床洞察"。该研究以澳大利亚糖尿病、肥胖与生活方式研究(AusDiab,n = 10,339)为发现队列、墨尔本协作队列(MCCS,n = 2,996)为验证亚队列,用靶向 LC–MS/MS 定量了 3 大类 36 类共 743 种血浆脂质,并将脂质签名与膳食质量指数(DGI、HSR-DI、MIND)及心血管代谢健康结局系统关联。
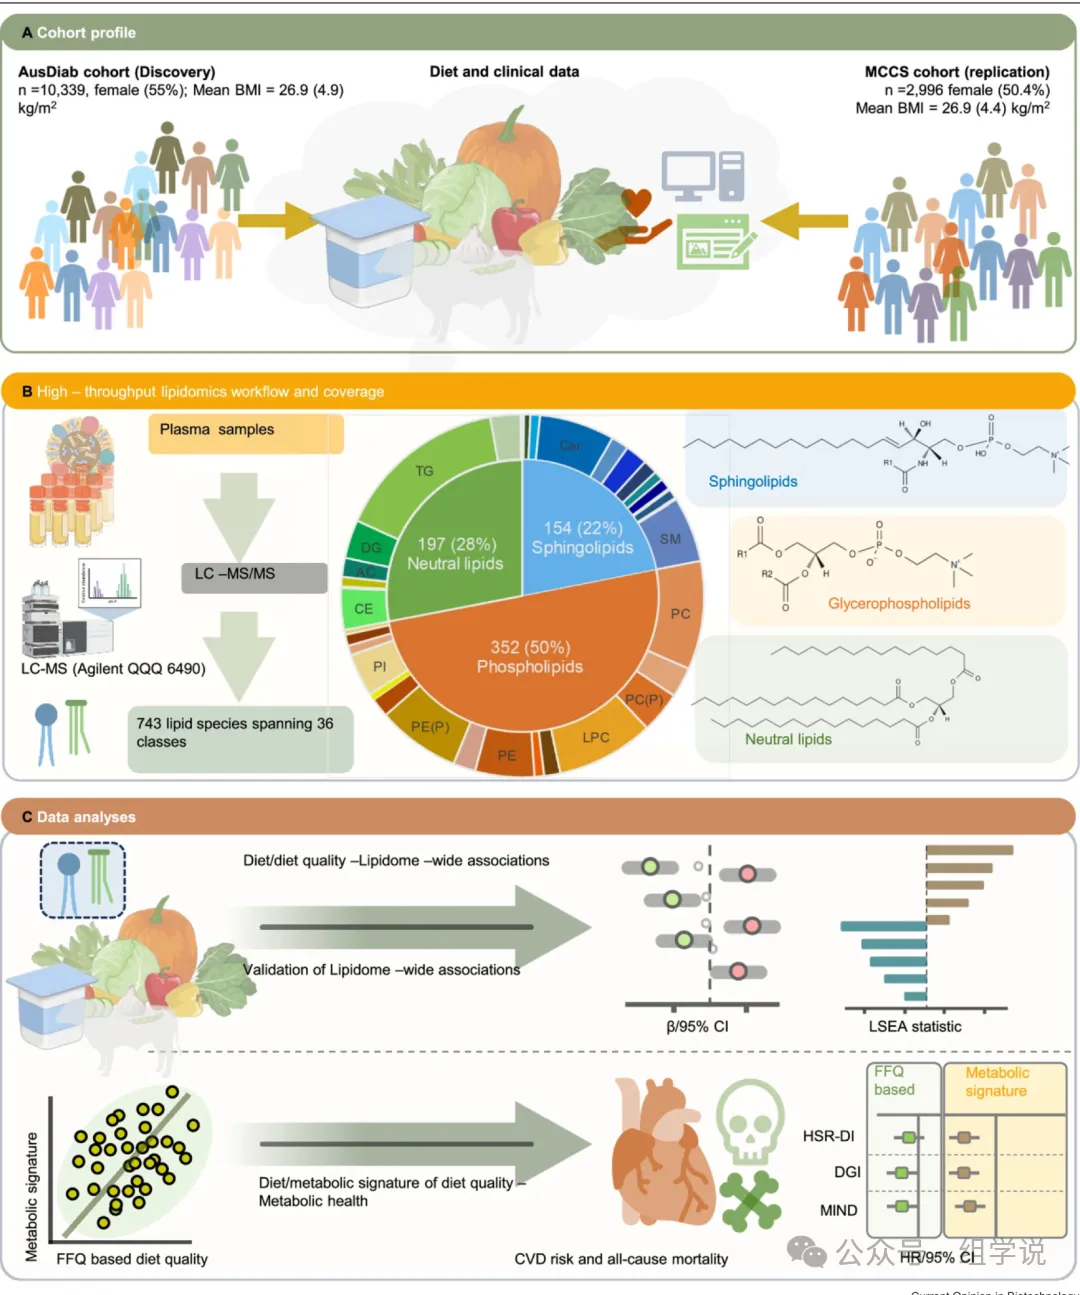
图 3|文献原图:Figure 1 澳大利亚双队列大规模血浆脂质组分析的设计、覆盖与分析流程
图 3 解读:(A) 队列概况展示了发现队列 AusDiab(n = 10,339)与验证队列 MCCS(n = 2,996)的社会人口学、膳食与临床数据采集框架;(B) 高通量脂质组工作流与覆盖面:血浆样本经 LC–MS/MS(Agilent 6490 三重四极杆)测定 743 种脂质,覆盖 36 类、三大类别——图中饼图显示甘油磷脂 352 种(50%)、中性脂质 197 种(28%)、鞘脂 154 种(22%);(C) 数据分析框架:从"膳食/膳食质量–脂质组"的全关联分析(β 与 95% CI)、脂质集富集分析(LSEA 统计量),到脂质代谢签名与心血管疾病风险及全因死亡率的关联,并与基于食物频率问卷(FFQ)的膳食质量评分进行对照。这项研究的核心结论是:客观的血浆脂质签名是比膳食自报更优的膳食质量生物标志物,能改善大规模人群的风险分层——这正是"高通量平台 × 严格 QC"转化为流行病学证据的完整范例。
五、软件与 AI:让数据处理跟上采集速度
采集提速之后,数据预处理成为新的瓶颈。综述重点关注遵循 FAIR 原则(可发现、可访问、可互操作、可复用)的开源工具生态:MZmine 3 通过内存管理与并行化,处理 8,273 个 LC–MS/MS 样本仅需 47 分钟,较 MZmine 2 缩短 89% 的处理时间;XCMS 平台在大规模研究场景下实现三倍提速且内存占用更低;mzLearn 以数据驱动的信号检测与比对算法,在 15 个公开数据集上实现更高的真阳性率与更低的假阳性率,同时校正大型队列的仪器漂移;MASST+ 与 Networking+ 则以快速打分索引处理公开库中的 MS/MS 谱图,将未知代谢物鉴定的检索规模较传统 GNPS 工作流提升了三个数量级。AI 工具的渗透同样迅速:MassQL 质谱查询语言引入大语言模型驱动的对话助手,支持实时查询编写与排错;MetaboAnalyst 6.0 把原始谱图处理、统计与功能分析、批次校正、通路分析乃至基于孟德尔随机化的因果推断整合进统一网页平台;DeepMet 则用生化语言模型预测"暗代谢组"——那些尚未被识别的代谢物的化学结构。但综述同时给出清醒提醒:AI 工具的成效最终取决于训练数据的规模与质量,而跨队列、跨仪器、跨方案的数据异质性与非标准化,仍是悬在这类工具头上的达摩克利斯之剑。
结语
这篇综述的价值在于把"代谢组学规模化"拆解为三个可操作的技术层:分析前(自动化样品制备)、分析中(高通量采集平台)、分析后(软件与 AI 工作流),并用 61.9 万人的 NMR 研究、2 万人的 DiscoveryHD4 平台与 1.3 万人的澳大利亚脂质组队列三个标杆,证明了"高通量 + 严格 QC/QA"并非纸上谈兵。对于计划开展大队列代谢组学研究的团队而言,选型逻辑已然清晰:追求绝对定量的稳健性,可借鉴 NMR 与靶向工作流的经验;追求覆盖面与通量的平衡,混合模式 LC–MS 与复用式 CE–MS 值得关注;追求极限通量,SPME–MOI–MS 与 DI-ADE-MS 提供了无需色谱的另类答案。当然,综述也坦承:全自动在线样品处理与 MS 采集的直接耦合尚未在大型研究中常规化,开源计算方法与 AI 工具的严格基准测试仍是当务之急。当技术瓶颈被逐个击破,代谢组学才能真正从"发现标志物"走向"验证标志物",支撑起人群健康与精准医学的宏大叙事。
文献引用
Buitrago-Oliveros M, Hamoodi Z, Britz-Mckibbin P. High-throughput mass spectrometry-based metabolomics for large-scale population studies: technical barriers and recent innovations. Current Opinion in Biotechnology, 2026, 102: 103589. DOI: 10.1016/j.copbio.2026.103589