ARTICLE · 1333103
RAG 中的 RRF 是什么?用两个文档讲透 ES + Milvus 混合检索
RAG 中的 RRF 是什么?用两个文档讲透 ES + Milvus 混合检索
> 一个 RAG 系统同时用了 ES 和 Milvus:ES 擅长关键词,Milvus 擅长语义。两路都返回了一堆文档,接下来该把谁排在前面? > > 很多人的第一反应是“把两路分数加一下”。问题是,ES 的 BM25 分数和 Milvus 的向量相似度根本不是同一种计量单位,直接相加很容易被其中一路碾压。 > > RRF 解决的就是这个问题:不比原始分数,只比各自的名次。 本文用一个固定例子,把标准 RRF、加权 RRF、平滑常数 k、静态与动态权重一次讲清。
CHAPTER 01
一、为什么 ES 分数和 Milvus 分数不能直接相加
在一个典型的混合检索 RAG 中,用户的问题会同时进入两路:
✔ES 稀疏检索:常用 BM25,擅长关键词、固定术语、编号、实体、结构化过滤和 FAQ。
✔Milvus 向量检索:通过 Embedding 找语义相近内容,擅长长文本、口语化表达、同义改写,以及图片、音频等向量检索。
两路都有自己的分数,但这些分数的值域、分布和含义不同。一个系统的 8 分,不代表它比另一个系统的 0.8 分“恰好强 10 倍”。
这就像一位老师用 100 分制,另一位老师用 5 分制。直接把分数相加,满分 100 的老师天然更有话语权。
RRF 的思路是:先别管考了多少分,只看在各自班级里排第几。
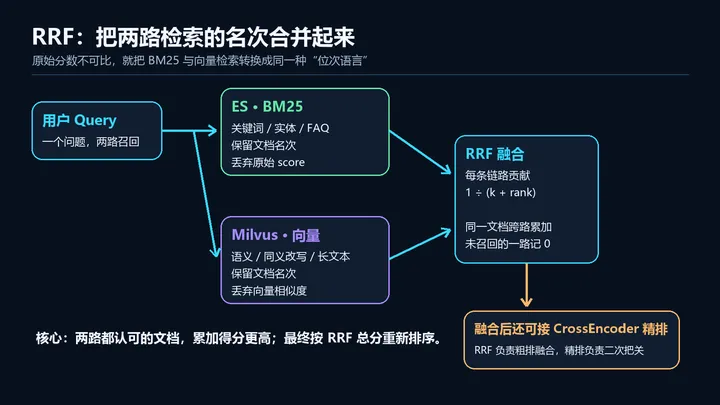
RRF 融合流程
CHAPTER 02
二、RRF 的核心:把名次变成可以累加的贡献
RRF 全称 Reciprocal Rank Fusion,中文通常译为“倒数排名融合”。
标准公式可以写成:
RRF(d) = Σ 1 / (k + rank(d, r))
其中:
✔d:一个文档或 Chunk。
✔r:某一条检索链路,例如 ES 或 Milvus。
✔rank(d, r):文档 d 在链路 r 中的名次,从 1 开始。
✔k:平滑常数,常见默认值是 60。
✔Σ:把同一文档在各条链路里的贡献加起来。
如果文档没有出现在某一路的召回列表里,这一路对它的贡献就是 0。
最后,按照 RRF 总分从高到低重新排序。一个 Chunk 如果在 ES 和 Milvus 中都靠前,它就能拿到两份贡献,自然更容易排到前面。
所以 RRF 的一个重要思想是 共识优先:两路都认可的结果,通常比只有一路叫好的结果更值得关注。
它有四个鲜明特点:
✔ 只使用名次,不使用 BM25 或向量相似度的原始数值。
✔ 名次越靠后,k + rank 越大,单项贡献越小。
✔ 可以融合不同引擎、不同模态的召回结果。
✔ 它属于粗排融合,不会利用原始分数里的置信信息;高精度链路通常还会接 CrossEncoder 做二次精排。
因此,RRF 也可以理解为一种“位次归一化”:不是把原始分数压到 0~1,而是在次序空间里对齐多路结果。
CHAPTER 03
三、标准 RRF:两个文档为什么会打成平手
固定一个例子,后文反复使用:
Chunk A:ES 第 1,Milvus 第 2。 | Chunk B:ES 第 2,Milvus 第 1。 | 平滑常数 |
第 1 名的分母是 60 + 1 = 61,第 2 名的分母是 60 + 2 = 62。
两个基础倒数为:
|
|
标准 RRF 中,ES 和 Milvus 地位相等,直接相加:
| 0.03252 | |||
| 0.03252 |
A 的计算是:
0.01639 + 0.01613 = 0.03252
B 的计算是:
0.01613 + 0.01639 = 0.03252
两者完全相等。
原因并不神秘,就是 加法交换律:1/61 + 1/62 与 1/62 + 1/61 必然相等。
推广一下,只要两个文档拿到的名次集合相同,只是在不同链路中互换,例如一个排名第 3、第 5,另一个排名第 5、第 3,它们的标准 RRF 总分也会相同。
这不是算法出错,而是标准 RRF 没有回答一个问题:当两路意见相反时,我到底更信谁?
CHAPTER 04
四、加权 RRF:给更可靠的一路更多表决权
加权 RRF 只做一处改动:每一路的倒数贡献,在累加之前先乘上该路的权重。
Weighted_RRF(d) = Σ w_r / (k + rank(d, r))
工程上通常让各权重之和为 1,这样更容易理解。
沿用刚才的例子,设置:
ES 权重 | Milvus 权重 |
这表示我们更信任 Milvus 的语义排序。
Chunk A:
ES 单项: | Milvus 单项: | 总分: |
Chunk B:
ES 单项: | Milvus 单项: | 总分: |
此时 B 排在 A 前面。
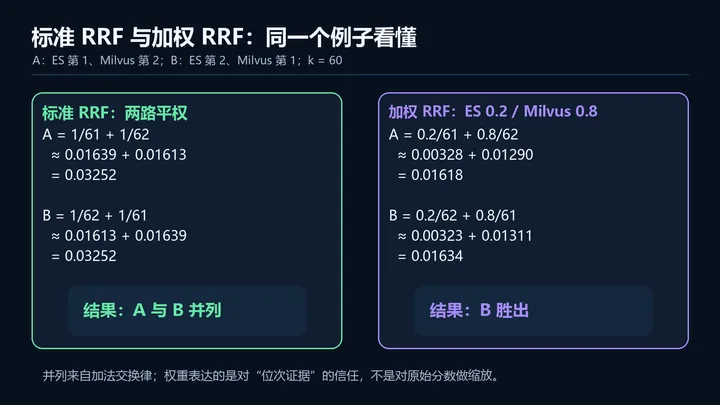
标准 RRF 与加权 RRF
要特别注意:权重乘的是 RRF 倒数项,不是 BM25 原始分,也不是向量相似度。后两者属于原始分数融合,不是这里讨论的加权 RRF。
权重方向决定谁更可能胜出,权重差距则会影响领先幅度。
CHAPTER 05
五、平滑常数 k:控制“前进一名值多少钱”
如果没有 k,第 1 名贡献是 1,第 2 名是 0.5,第 3 名是 0.333,头部差距会非常陡峭。
加入 k 后,分母变成 k + rank,名次之间的差异被平滑了。
当 k = 60:
第 1 名: | 第 2 名: | 两者差约 |
当 k = 10:
第 1 名: | 第 2 名: | 两者差约 |
同样是从第 2 名前进到第 1 名,k = 10 时的收益约为 k = 60 时的 28.7 倍。
因此:
k 越小:头部名次优势更突出,曲线更陡。 | k 越大:不同名次的贡献更平缓,头部与尾部的差距被压缩。 |
继续用 A、B 例子,k = 10、ES 权重 0.2、Milvus 权重 0.8:
A: | B: |
B 仍然胜出,但两者分差被放大。
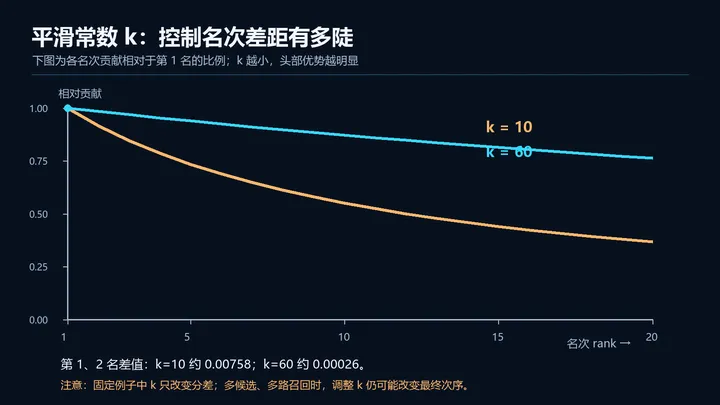
平滑常数 k 的影响
这里需要补充一个重要边界:“调整 k 只会改变分差、永远不会改变排序”并不适用于所有情况。
在原文这个两个文档、名次互换、权重固定的例子里,先后顺序确实不变;但在多候选、多路召回、缺失结果较多的真实场景中,改变 k 可能改变各文档的累加优势,进而改变最终次序。
常见默认值 60 来自原论文实验经验,后续不少实现沿用了这个默认值。但生产环境仍应使用自己的数据评测,而不是把 60 当成永远最优的答案。
CHAPTER 06
六、静态权重:按业务入口设置固定偏好
静态权重指的是:同一个检索入口下,所有 Query 共用同一组权重。
它适合查询风格相对稳定的业务。例如,合同编号检索和开放式技术问答,最好不要共用一套全局权重,而应按入口分别配置。
下面三组可以作为起步基线,不是不可修改的行业标准:
关键词优先时,可以适当放宽 Milvus 召回阈值,让语义候选先进入融合池,避免因为权重偏低而彻底漏掉。
语义优先时,建议保留 CrossEncoder 精排,进一步过滤“看起来很像、实际答案不对”的 Chunk。
均衡模式下,可以提前定义并列时的第二排序规则,例如固定参考某一路名次,或使用精排模型继续区分。
静态权重不是拍脑袋决定的,它应当是对一类查询长期偏好的固化表达。配置时要遵守四条原则:
✔ 权重表达对位次证据的信任,不是原始分数缩放。
✔ 权重之和通常设为 1,便于解释和比较。
✔ 按检索入口配置,不建议一个全局权重包打所有业务。
✔ 先用 Golden 基准集做离线 A/B,再小流量灰度上线。
CHAPTER 07
七、静态权重什么时候会失效
静态权重能跑稳,隐含了几个前提:用户提问风格、知识库内容、分词方式和 Embedding 模型没有发生明显变化。
一旦出现下面两类信号,就要重新评估:
离线指标分层下降:实体类查询变准了,语义类却经常漏掉真值;或者语义检索正常,编号和证件查询开始出错。 | 线上反馈两极分化:一类问题好评增加,另一类问题投诉、“没用”标记明显增加。 |
优化时,可以在冻结的 Golden 子集上做网格搜索和 A/B 对照,只保留相对基线有稳定收益的候选权重,再进入灰度验证。
如果用户问题类型非常分散、长尾 Query 很多,一套固定权重很难同时照顾所有场景,这时就需要动态权重。
CHAPTER 08
八、动态权重:每条 Query 先判断该信哪一路
动态权重与静态权重的区别很直观:
静态:入口提前定好一套权重。 | 动态:每条 Query 单独选择一套权重。 |
动态方案常用两类轻量信号。
第一类是槽位信号。 看 Query 中是否有编号、注册号、物料编码、合同号或专有参数。命中这类结构化信息,通常更需要 ES 的精确字面匹配。
第二类是意图信号。 判断用户是在查实体编号、查固定 FAQ、进行开放式提问,还是做多跳推理。
槽位并不只是简单关键词命中,意图也不是看到产品名就判定精确查询。例如,Query 中虽然有产品名称,但用户问的是“怎样设计改造方案”,意图仍属于开放式语义检索,不应盲目偏向 ES。
一种清晰的映射方式是:
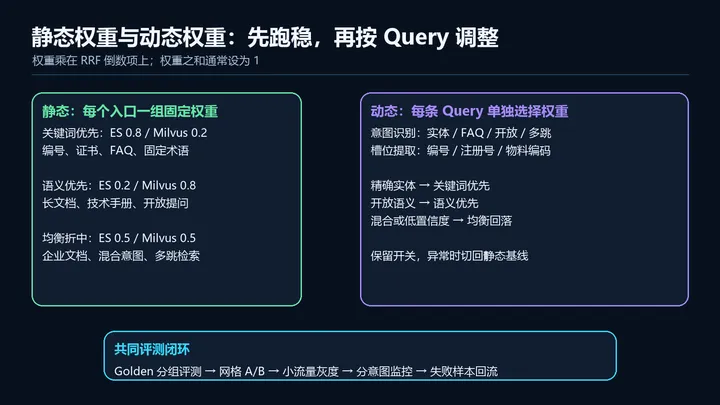
静态与动态权重
动态分支必须有 置信度回落机制。识别不确定时不要强行偏向某一路,而是退回均衡或当前入口的静态权重。
落地顺序上,更稳妥的做法是:先把静态分组权重跑稳,积累足够的标注样本,再上线意图驱动的动态权重。线上还要保留开关,识别服务异常时可以一键切回静态基线。
CHAPTER 09
九、评测不能只看全局平均值
动态权重新增了意图识别和槽位抽取,也就新增了失败来源。
典型故障是:一个开放式语义问题被误判为实体查询,系统把权重偏向 ES,结果大量语义相关 Chunk 被压低,真正答案反而没有进入前排。
因此,Golden 测试集应按类型拆开:
实体查询子集。 | 语义查询子集。 | 混合意图子集。 |
分别观察各组的 Context Recall、最终排序效果,以及下游回答的 Faithfulness。后者还会受到生成模型和 Prompt 等因素影响,不能全部归功于 RRF。
比较理想的动态收益是:实体子集召回不下降,语义子集召回有所提升。 如果某一组明显差于静态基线,就应关闭或回滚对应分支。
线上还需要记录每条 Query 的识别结果、槽位、输出权重、召回文档和最终反馈,把失败样本持续回流到意图与槽位模型的优化中。
RAGAS 等评测框架可以参与这条迭代闭环,但关键不是工具名字,而是固定基准、分组对照、灰度验证和可回滚。
CHAPTER 10
十、用几十行 Python 实现一个加权 RRF
下面的示例只接收“每一路的文档 ID 排名”,完全不读取原始检索分数:
def weighted_rrf(rankings, weights=None, k=60):
    weights = weights or {}
    scores = {}

    for channel, doc_ids in rankings.items():
        weight = weights.get(channel, 1.0)
        for rank, doc_id in enumerate(doc_ids, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + weight / (k + rank)

    return sorted(scores.items(), key=lambda item: item[1], reverse=True)


rankings = {
    "es": ["chunk-a", "chunk-b"],
    "milvus": ["chunk-b", "chunk-a"],
}

print(weighted_rrf(rankings))
print(weighted_rrf(rankings, {"es": 0.2, "milvus": 0.8}))
没有出现在某一路列表中的文档,自然只会累加其他链路的贡献,相当于该路贡献为 0。
真实工程还需要处理文档 ID 统一、候选列表截断、并列时的确定性排序、权重配置、指标埋点和异常回退。
RRF 完成融合后,可以把前 N 个候选交给 CrossEncoder 精排,再把最终上下文交给生成模型。
CHAPTER 11
写在最后:面试时可以这样回答
RRF 的核心不是发明一种新的相似度,而是 换一种统一的比较单位。
ES 的 BM25 分数与 Milvus 的向量相似度不可直接比较,RRF 就丢掉原始分数,把每一路的名次转换成 1 / (k + rank),再把同一文档的多路贡献累加。
标准 RRF 两路平权,可能出现名次互换后的并列;加权 RRF 在倒数项上乘以链路权重,用来表达对不同检索结果的信任程度。
k 控制名次贡献曲线的平缓程度:越小越突出头部,越大越平滑。静态权重适合查询稳定的入口,动态权重则根据意图与槽位逐条调整,并必须保留低置信度回落、分组评测和一键回滚。
最后用一句话收束:
RRF 负责把多路召回“合成一张候选榜”,CrossEncoder 再负责把这张榜单“排得更准”。
说明:本文依据用户提供的参考材料重新组织和通俗化表达。原始文本未附图片地址,文中 4 张示意图均依据原文数据重新制作,并非原发布页图片。静态权重数值应视为起步示例,生产配置以实际评测为准。