ARTICLE · 1344423
从源码看 Qwen2.5-VL:窗口注意力到底是怎么实现的?
关于 Qwen2.5-VL 视觉编码器,不同资料对窗口注意力、RoPE 和窗口大小的描述略有差异。这里直接以 Hugging Face Transformers 中的 Qwen2.5-VL 源码为准,顺着实际实现看一遍它的视觉处理流程。
下面涉及的结构和数值,均以当前主分支代码为准;具体部署时,应以所使用版本对应的源码为准。
先看完整的整条视觉通路。
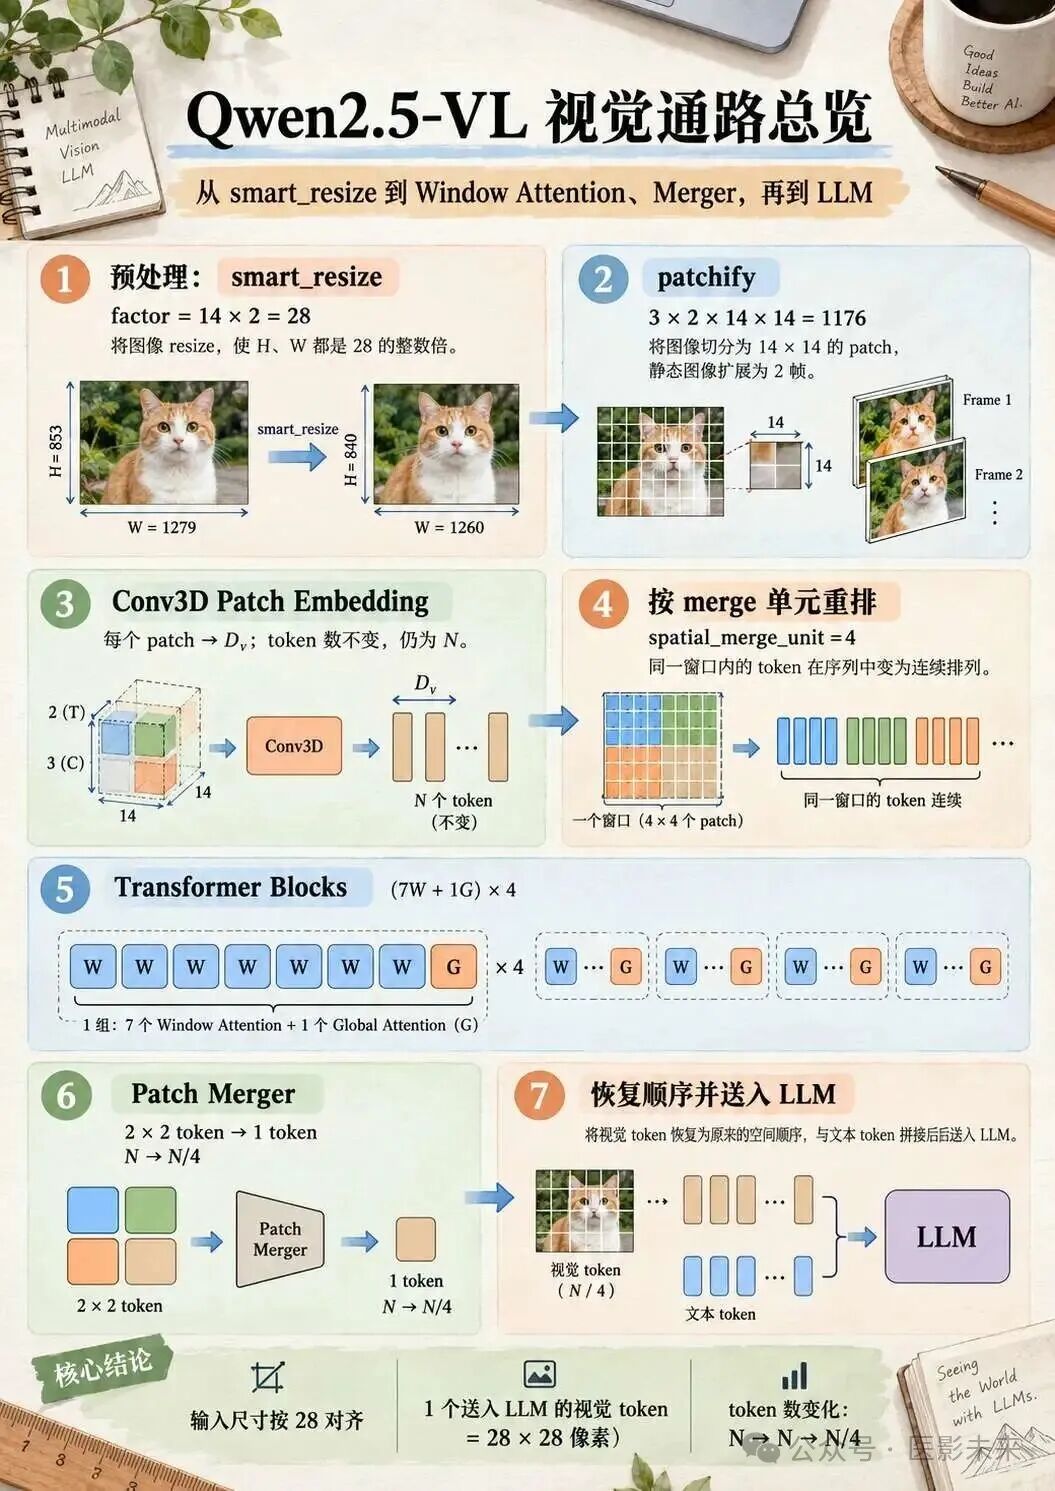
预处理:smart_resize 与 patchify
很多 ViT 会把输入统一 resize 到 224 或 336,Qwen2.5-VL 不这么做。图像处理器走的是 smart_resize(),只保证三件事:宽高能被指定 factor 整除、总像素数量落在预算区间内、宽高比尽量不变。这个 factor 等于 patch_size 乘 spatial_merge_size(因为 token 化分两级,先按 14 切 patch、再按 2×2 合并mergee,两级都要能整除,所以边长必须对齐到 ):
处理后的宽高因而都是 28 的倍数。动态分辨率并不等于完全不缩放,这一点容易被误解。
接下来 patchify() 把图像铺平。对静态图,预处理器用 unsqueeze(6).expand(...) 把同一组像素沿 temporal patch 维扩展到长度 2,所以每个扁平 patch 的维度是
单张图的输出是 (grid_h × grid_w, 1176),多张图再沿第一维 torch.cat 拼起来。也就是说传给视觉塔的 pixel_values 是一个二维 packed tensor,batch 被打包进了 sequence 维,边界由 grid_thw 和 cu_seqlens 记录,而不是传统的 (B, C, H, W)。
以一张 的图为例,两条边都是 28 的倍数,不需要再调整,patch 网格是 ,于是 。
Conv3D Patch Embedding
Qwen2_5_VisionPatchEmbed 里定义的是三维卷积:
kernel_size = [temporal_patch_size, patch_size, patch_size]self.proj = nn.Conv3d(in_channels, embed_dim, kernel_size=kernel_size, stride=kernel_size, bias=False)**kernel 和 stride 完全相同,窗口不重叠,数学上等价于对每个 patch 做一次线性映射。forward 里先把扁平 patch 还原成 (-1, 3, 2, 14, 14),卷完再 flatten 回 (N, Dv)**。这一步不减少 token 数量,只是把像素块投到视觉隐空间。
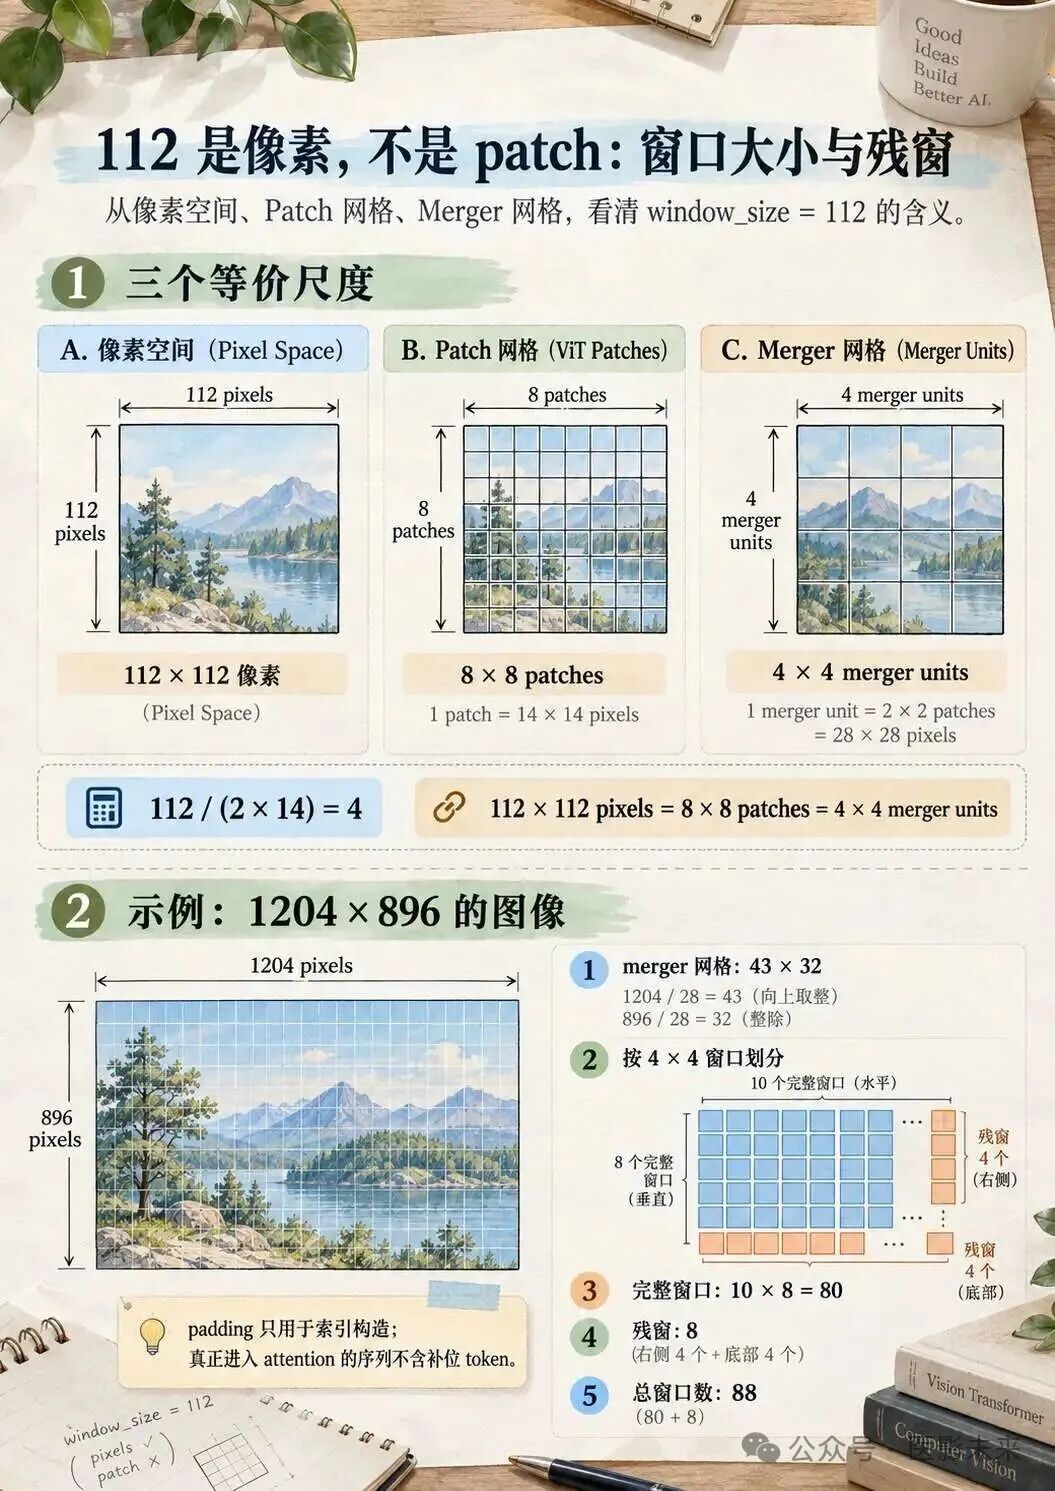
window_size = 112 的三种等价尺度
配置里的 window_size=112 指的是窗口边长为 112 像素,因此一个完整窗口实际覆盖的是 像素区域。
ViT 的 patch 边长是 14 像素,所以沿单个方向看:
也就是说,一个窗口的边长对应 8 个 ViT patch,因此二维窗口大小是 个 patch。
接下来,每 个 patch 会组成一个 merger 单元,所以沿单个方向还要再除以 2:
因此,窗口有多大可以用三种尺度表示:
如果图像边缘不能被 的 merger 窗口整除,代码会在生成窗口索引时临时 padding,方便 reshape;这些补位随后会被过滤掉,不会真正进入 attention 计算。
以 的图像为例,merger 网格是 。其中 ,所以一个方向会留下宽度为 3 个 merger 单元的残窗;,另一个方向正好整除。
最终共有 88 个窗口:80 个完整窗口,每个包含 个 patch token;8 个残窗,每个包含 个 patch token。
按 merge 单元的序列重排
整套窗口注意力能成立,靠的是进入 Transformer 之前的这次重排,而这一步在多数介绍里都被跳过了。
defpermute_input_for_window_attn(self, input_tensor, window_index, seq_len): input_tensor = input_tensor.reshape(seq_len // self.spatial_merge_unit, self.spatial_merge_unit, -1) input_tensor = input_tensor[window_index, :, :] input_tensor = input_tensor.reshape(seq_len, -1)return input_tensor其中 spatial_merge_unit = spatial_merge_size ** 2 = 4。代码把每 4 个 patch token 当作一个不可拆的空间单元,再按 window_index 重排这些单元的先后顺序。
(示图中token数只是为了说明,与实际数字不符)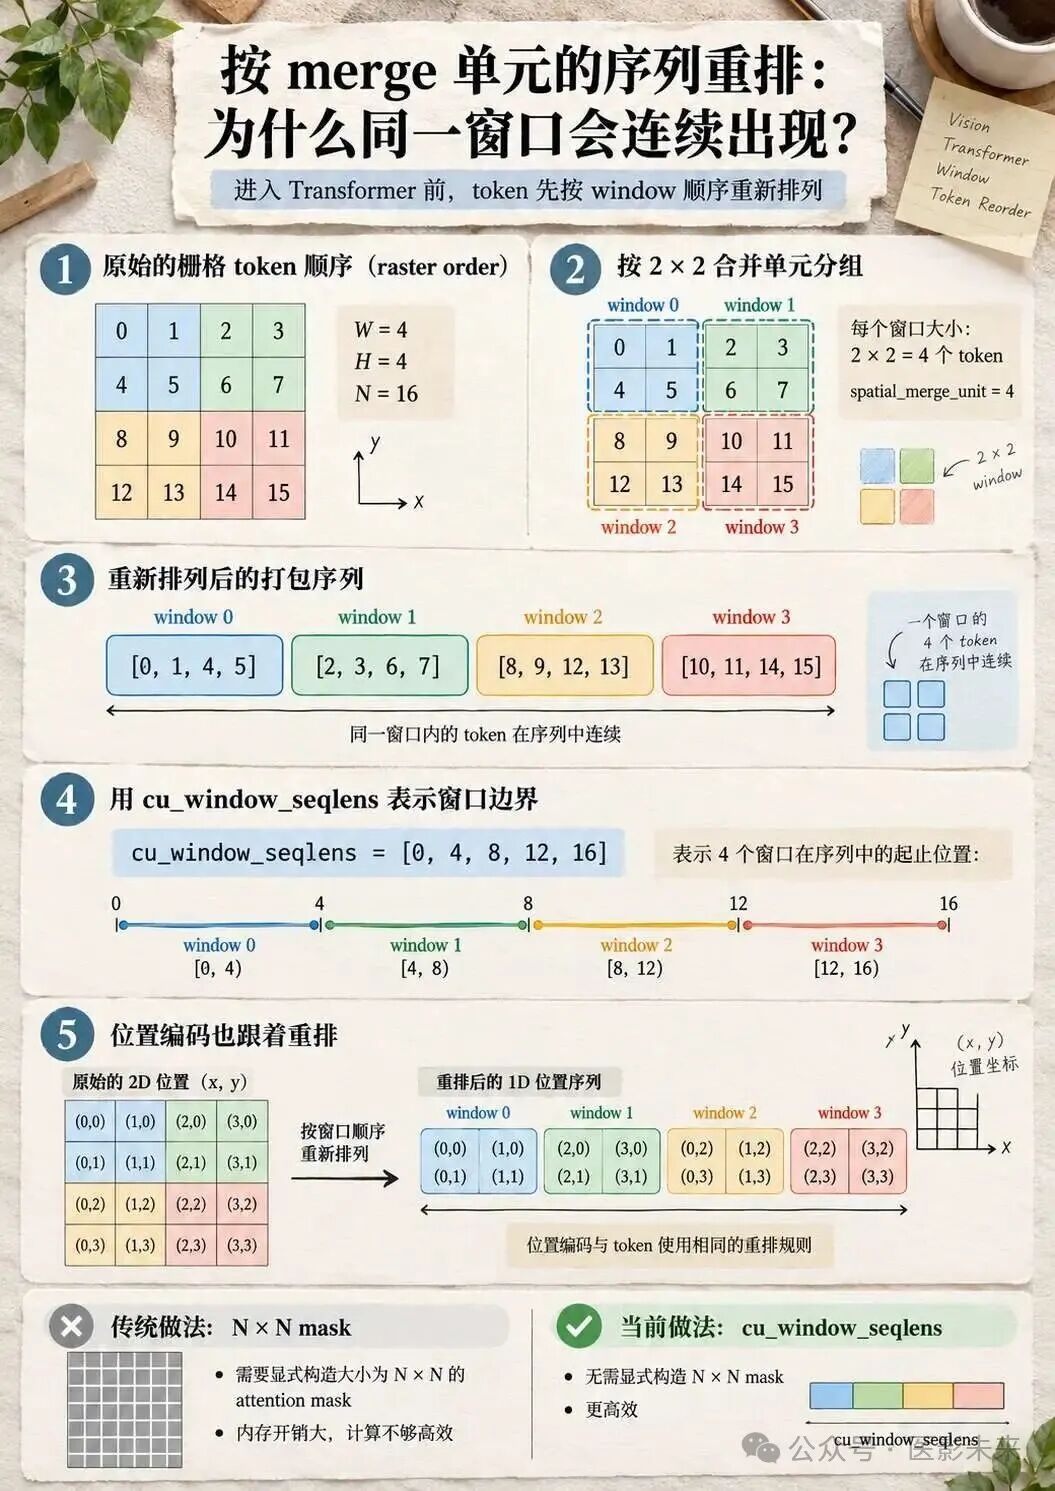
shape 前后都是 (5504, Dv),变的只有排列。这样同一窗口的 token 在 packed sequence 里连续,窗口边界可以直接由 cu_window_seqlens 描述(cumulative sequence lengths),不必显式构造一个 的窗口 attention mask。(hidden_states 负责存所有 token,cu_window_seqlens 负责告诉 attention 这些 token 应该分成哪些独立窗口)
位置编码也跟着重排:cos/sin 在原始顺序下算好,再用同一个 window_index 打乱,这样每个 token 带的始终是它真实的空间坐标。
32 层的窗口与全局排布
配置里写得很直白:
fullatt_block_indexes = (7, 15, 23, 31)索引是 0-based,对应第 8、16、24、32 层。32 层里只有这 4 层是全局注意力,其余 28 层全是窗口注意力,排布可以写成 ,也就是七层窗口接一层全局,循环四次。3 local + 1 global 那种密集交替属于另一类设计,和这里不是一回事。
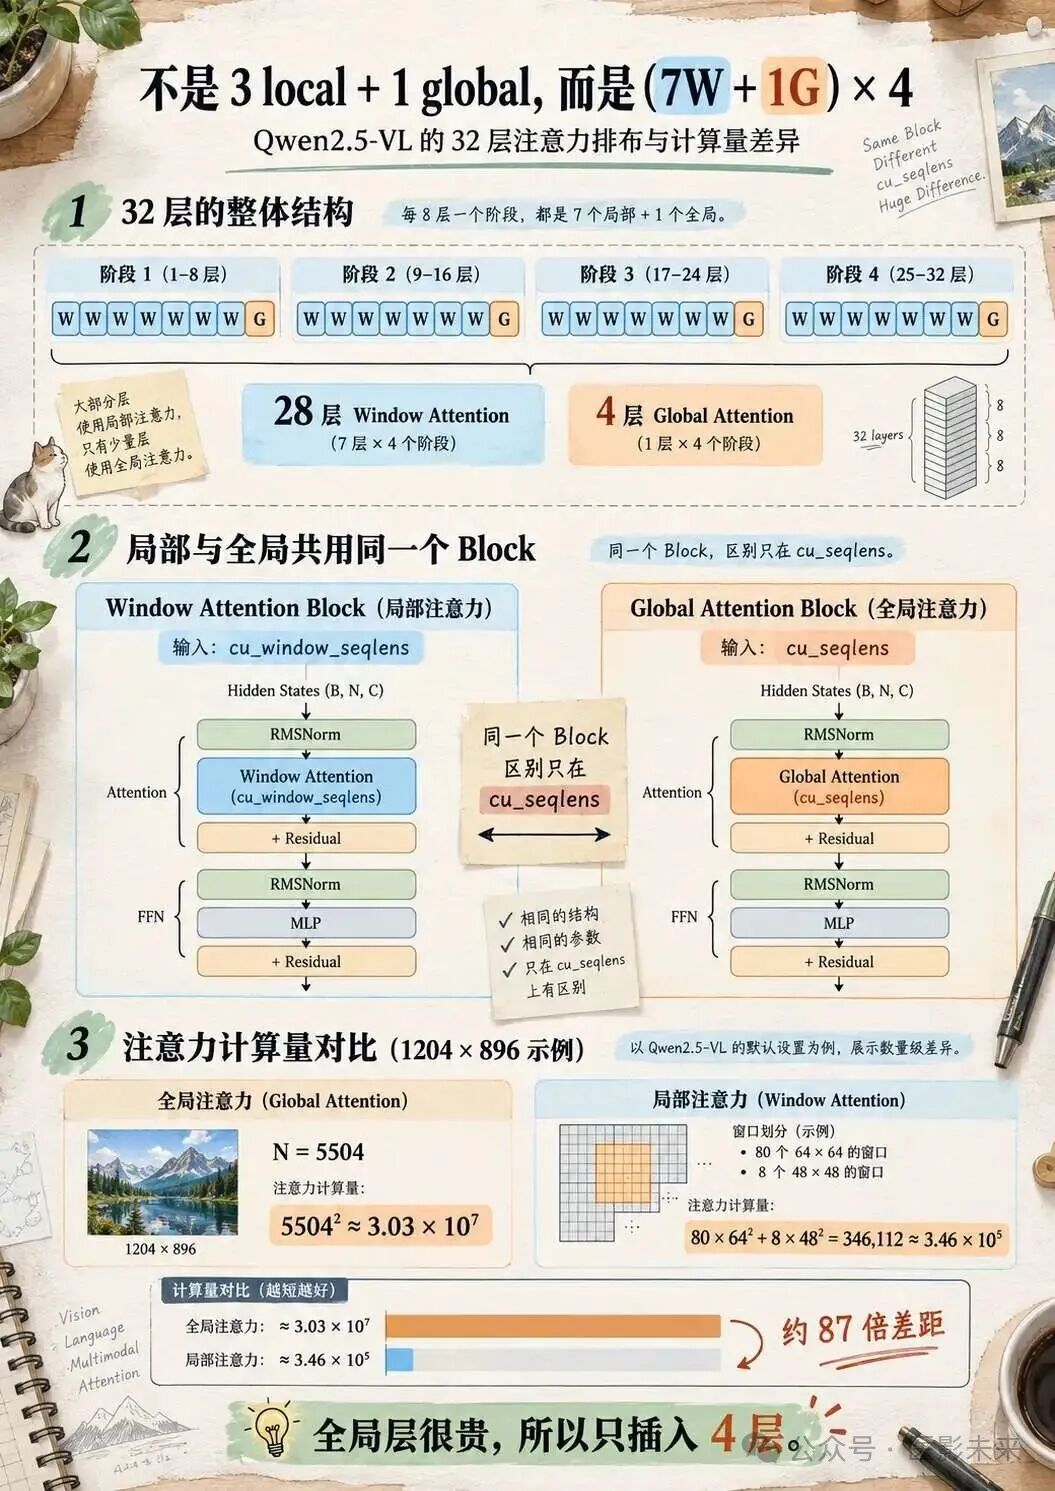
值得注意的是,代码里根本没有 WindowAttention 和 GlobalAttention 两个类。视觉塔的循环体是这样:
for layer_num, blk in enumerate(self.blocks):if layer_num in self.fullatt_block_indexes: cu_seqlens_now, max_seqlen_now = cu_seqlens, max_seqlenelse: cu_seqlens_now, max_seqlen_now = cu_window_seqlens, max_window_seqlen hidden_states = blk(hidden_states, cu_seqlens=cu_seqlens_now, ...)同一个 Block,同一套权重结构,QKV、RoPE、attention kernel、projection 全都没换,唯一的变量是传进去的 cu_seqlens, 也就是哪些 token 属于同一个 attention segment。
计算量的差别也来自这里。全局层要考虑的 query-key 组合随 token 数平方增长,示例图是
窗口层则要按每个窗口的真实长度分别平方再求和,不能简单写成 ,因为其中 8 个残窗只有 48 个 token:
两者相差约 87 倍,而且图越大差距越悬殊,把全局层压到只剩 4 层的原因就在这个量级差上。
Vision Block 的内部结构
结构是标准 Pre-Norm,但用的是 RMSNorm 而不是 LayerNorm,eps 为 :
hidden_states = hidden_states + self.attn(self.norm1(hidden_states), cu_seqlens=cu_seqlens, ...)hidden_states = hidden_states + self.mlp(self.norm2(hidden_states))Attention 里 qkv = nn.Linear(dim, dim * 3, bias=True),带 bias。shape 走向是 (N, Dv) 到 (N, 3Dv),reshape 成三份 (N, 16, head_dim),应用视觉 RoPE 后进入变长 attention,输出再 proj 回 (N, Dv)。
FFN 不是传统 ViT 的 Linear → GELU → Linear,而是门控结构,并且同样带 bias:
hidden_act 配的是 silu,中间维度 intermediate_size = 3420。这两点都更接近语言模型那一侧的写法。32 层跑完,shape 始终保持 (5504, Dv)。
ViT 内部的二维 axial RoPE
Qwen2_5_VLVisionRotaryEmbedding 的类注释原话是 simple axial 2D rope,接收的 position_ids 形状是 (2, N),两行分别是 h 坐标和 w 坐标。频率的构造方式是:
spatial_dim = dim // 2inv_freq = 1.0 / (base ** (torch.arange(0, spatial_dim, 2, dtype=torch.float) / spatial_dim))inv_freq 长度是 ,h 和 w 各算一份拼成 ,再整体复制一遍覆盖完整 head dim,不存在部分旋转。
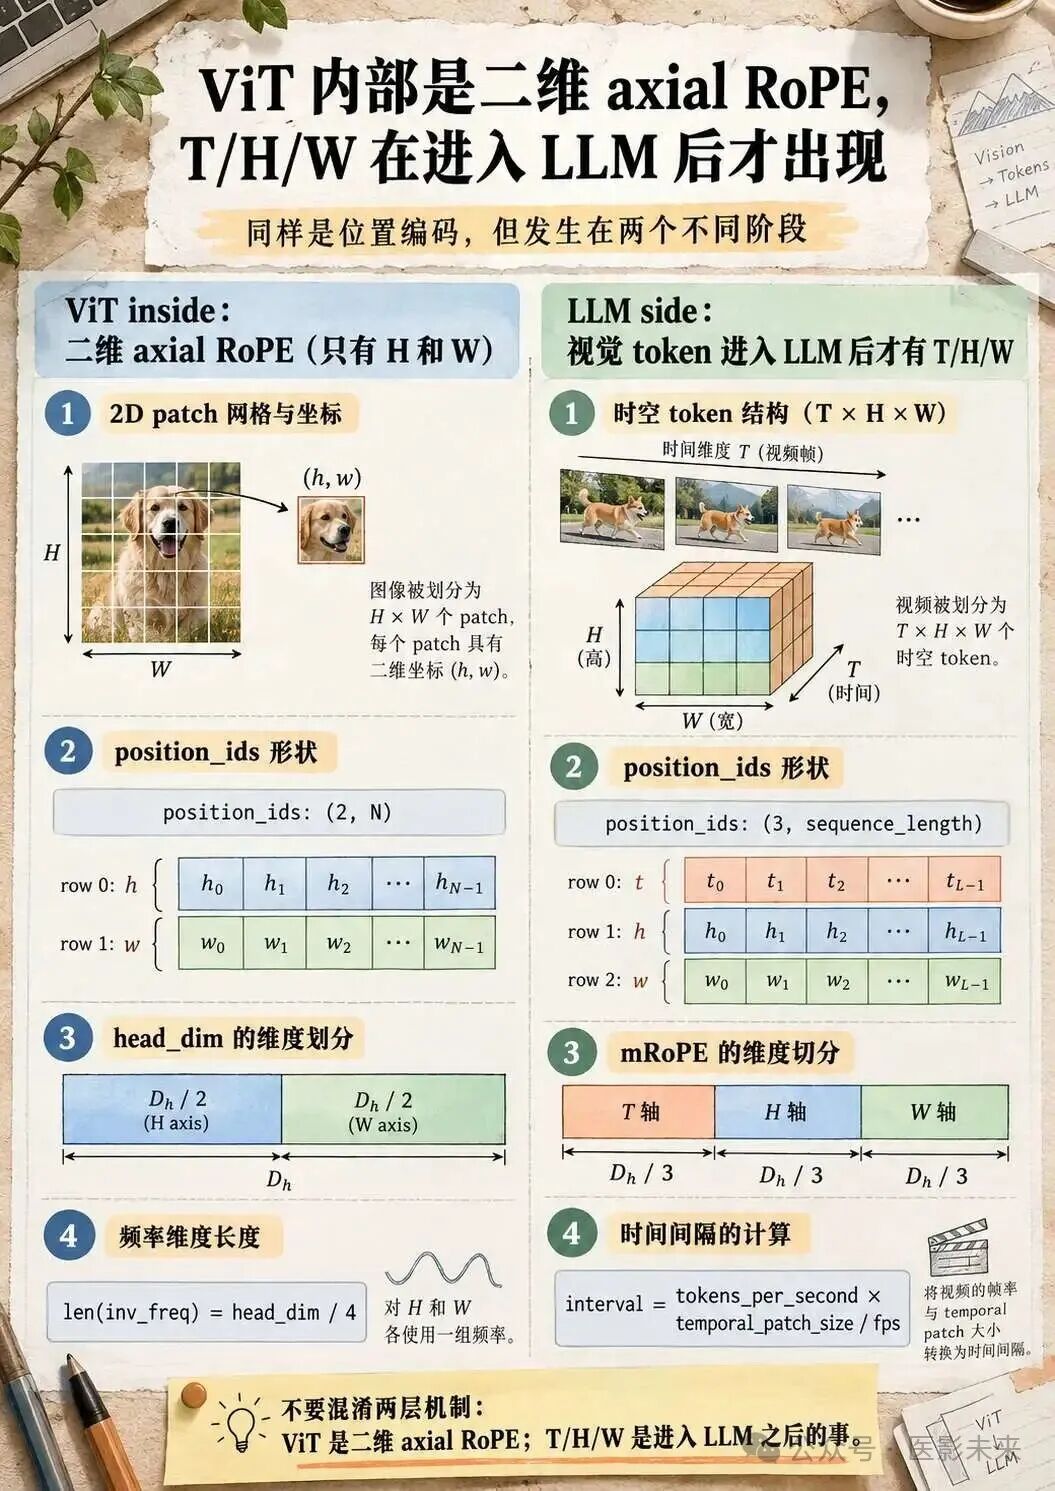
时间维度出现在另一个地方。Qwen2_5_VLModel.get_vision_position_ids() 才生成 T/H/W 三维索引,输出 (3, sequence_length),语言模型侧的 rotary embedding 再按 mrope_section 把三组频率切片交错拼回去。时间间隔和帧率挂钩,docstring 给的关系是
所以更严谨的表述是:ViT 内部是二维 axial RoPE, T/H/W 是视觉 token 进入语言模型之后才有的事,这是两层不同的机制。
Patch Merger 与顺序还原
self.ln_q = Qwen2_5_VLRMSNorm(context_dim, eps=1e-6)self.mlp = nn.Sequential( nn.Linear(self.hidden_size, self.hidden_size), nn.GELU(), nn.Linear(self.hidden_size, dim),)其中 hidden_size = context_dim * 4。forward 里先 RMSNorm,再 view(-1, 4Dv) 把相邻四个 token 拼到通道维,最后过两层 MLP 投到 out_hidden_size,token 数降到 ,通道对齐到语言模型的维度。view 之所以能正确对应 空间邻域,前提正是前面那次重排保证了同一 merge 单元的四个 token 序列连续。
除了压缩和投影,这个模块还承担第三件事:
reverse_indices = torch.argsort(window_index)merged_hidden_states = self.merger(hidden_states)merged_hidden_states = merged_hidden_states[reverse_indices, :]窗口顺序只在 ViT 内部成立,送进语言模型之前必须还原成光栅顺序,否则 LLM 侧的 T/H/W 位置全都对不上。window_index 索引的是 merge 单元,merger 输出恰好 行,一次 argsort 就还原完毕。
另外视觉塔返回的 last_hidden_state 是窗口顺序的 (N, Dv),pooler_output 才是还原后的 (N/4, Dl)。取错不会报错,但后续计算全部基于错误的空间位置。
1300 × 1200 输入的完整数据流
前面的例子边长恰好是 28 的倍数,现实里更常见的是不整除的情况。换一张 的图,整条链路的数字如下。
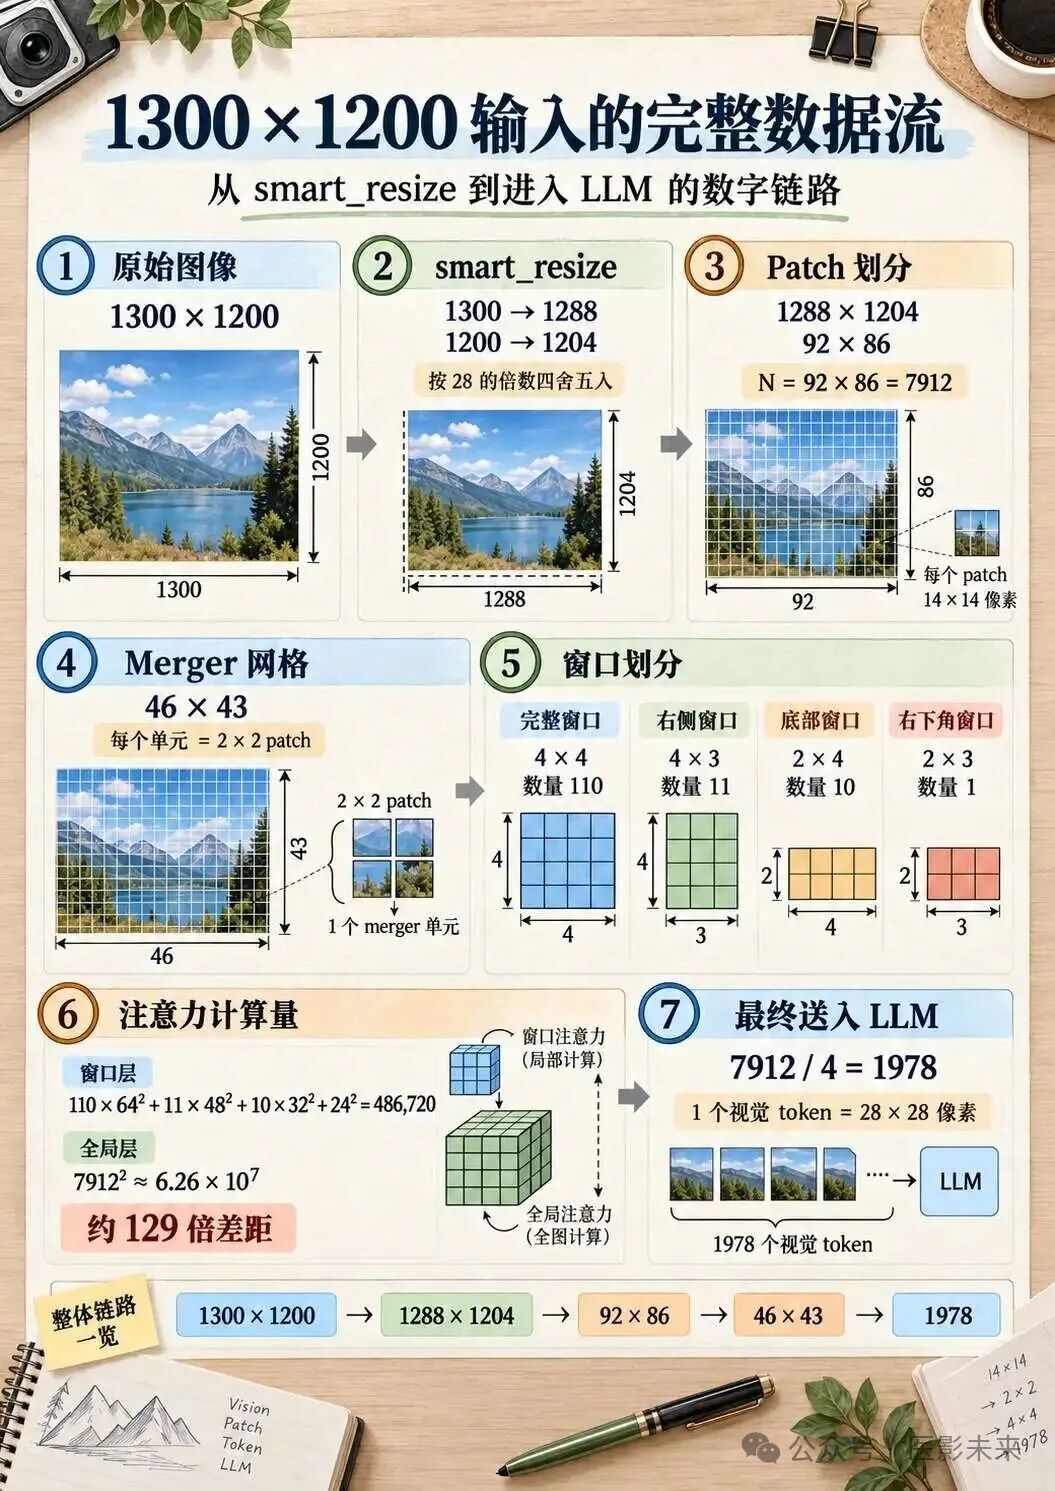
smart_resize 先把两条边四舍五入到 28 的倍数:,。patch 网格变成 ,,送进视觉塔的是 (7912, 1176)。
merger 网格是 ,两个方向都不整除:,。于是 132 个窗口里只有 110 个是完整的 ,另外三类分别是右侧的 、底部的 和右下角那一个 。把各类窗口的 patch 数加起来正好是 7912,可以反过来印证残窗确实按实际长度参与计算,没有补位。
attention 的计算量差距在这个尺寸上更明显。全局层要算 个组合,窗口层按四类窗口的真实长度求和是 ,相差约 129 倍。
最终 个 token 进入语言模型,和 对得上。这里用的是 resize 之后的 ,直接拿 去除 784 是对不上的。
视觉 token 数与像素的换算
patch 是 ,merger 再合 ,所以送进语言模型的一个视觉 token 覆盖 像素。对静态图,若 、 指 smart_resize 之后真正进入 patchify 的尺寸,则
必须是 resize 之后的尺寸,拿原图边长直接除 784 往往除不尽。用前面的示例图验算:,最初的 5504 个 patch,最终只剩 1376 个 token 进入 LLM。
整条链路串起来是这样:像素切成 patch,Conv3D 投影,按 merge 单元重排,七层窗口加一层全局循环四次, 合并后投到语言模型维度,还原顺序,与文本 token 拼成一条序列。
这套设计的思路不是把 ViT 彻底改造成局部网络,而是让绝大多数层在固定窗口内交互,周期性插入全局层做跨窗口汇总,最后靠 merger 把高分辨率网格压成四分之一长度再交给语言模型。实现层面局部和全局共用同一套代码,区别只在一个 cu_seqlens。
小团队做 on-policy 蒸馏,OPD 和 OPSD 到底该选哪个
递归自我改进 RSI(Recursive Self-Improvement):AI 造 AI 现在走到哪一步了?
Kimi K3 为什么舍 RoPE 而用 NoPE?位置信息从哪里来
DEIMv2 解读:如何把 DINOv3 的单尺度表征接入实时 DETR
一张图片,是如何变成视觉 Token 的?——拆解 Qwen3-VL 视觉数据流,兼谈 Qwen3.5 的架构取舍
从 OPD 到 OPSD:让"知道答案的自己"去教"不知道答案的自己"
大模型缓存命中时为什么便宜那么多:从 KV Cache 说清大模型推理的成本结构
如何把Qwen 的视觉塔换成 3D 编码器(医学CT、MRI)
Atlas/Pillar-0:3D 医学影像的多尺度注意力机制,如何为MedVLM选择合适的图像编码器
为什么 PPO 把 KL 放 reward,GRPO 放 loss?——位置与估计量其实是同一个问题:从策略梯度的两条路径说起
Hybrid Transformer是什么?Qwen3.5 为什么 3/4 的层根本不用 Attention?