ARTICLE · 1362456
我在本地搭了一个零成本的知识库问答,源码开源了
一句话说清楚:这篇文章讲的是一个能跑、能评测、零 API 成本的本地知识库问答工具,你可以 clone 下来,喂进自己的 PDF 和笔记,在完全离线的状态下问答,并且能自动验证它答得准不准。
我写了大半年的 Agent 框架源码分析,LangGraph、DeerFlow、DeepSeek Super-Agent 挨个扒。扒得多了,反而越来越清楚一件事:光讲「源码怎么实现的」,读者看完点点头就划走了。真正能让人留下来、跟着做、转给朋友的,是「一个能亲手跑起来的东西」。
所以我把手伸向了落地。这篇文章要讲的,是我搭的一个小工具:一个本地知识库问答。名字很直白,叫 local-rag-qa。
它解决一个很具体的问题:我想问自己的一堆 PDF、笔记、文档,但不想把内容上传到任何云服务,也不想为每次提问付 API 费。答案就是:把模型和数据都留在本机,离线跑一个 RAG。
更重要的是,它不是「又一个 RAG demo」。我给它定了一条主线:同一个功能,我会用四种不同的 Agent 框架各实现一遍,借每个框架最核心的设计,把同一个问答做出不同的「内核气质」。这是后面几篇要展开的事,这一篇先把第一版讲清楚。
一、它到底是个什么东西
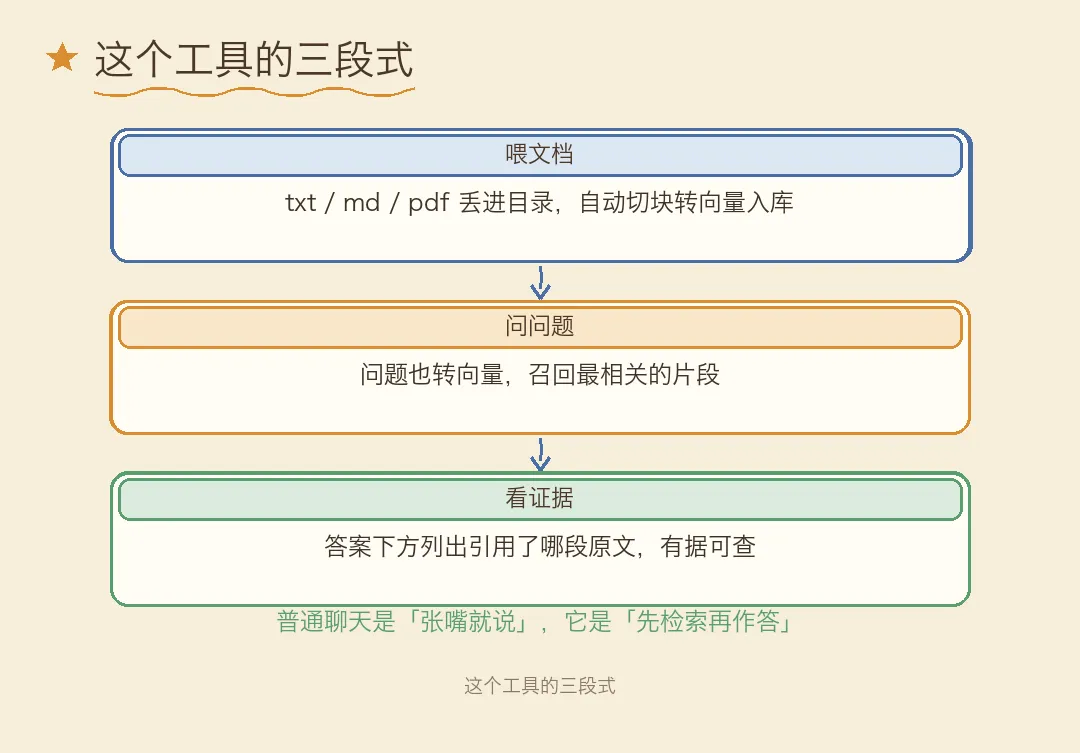
一句话说清楚:它是一个「喂文档、问问题、看证据」的三段式工具,全程本地离线。
用大白话说,你把它跑起来之后,能做的就三件事:
把一个目录里的 .txt、.md、.pdf文档丢进去,它自动切块、转成向量、存进本地向量库。在网页上问一个问题,它从你的文档里检索出最相关的片段,再让本地模型基于这些片段写答案。 答案下方会列出「检索到的证据片段」,你能看到它到底引用了你哪段原文。
第三点是它和普通聊天机器人最大的区别。普通聊天,模型张嘴就说,你不知道它是不是在编。这个工具,答案是有据可查的:它先检索,再作答,证据摆在你面前。
技术栈刻意选了「全离线、零成本」的组合:生成用千问 qwen3,嵌入用智源的 bge-m3,向量库存 Qdrant 的本地嵌入式模式。没有一个组件需要联网,也没有一个组件要付钱。
二、为什么我不直接抄一个 RAG 教程
一句话说清楚:市面上的 RAG 教程只教你「怎么搭」,没人回答「为什么这么选」,而「为什么」才是能沉淀的东西。
如果你搜「本地知识库 RAG 教程」,会看到一堆内容,套路基本一样:装 LangChain,接一个向量库,跑通就完事。它们很少回答下面这些问题:
向量库为什么选这个而不是那个?Chroma、Qdrant、pgvector、Milvus、Elasticsearch,差别到底在哪? 嵌入模型为什么选这个?中文文档用 nomic 还是 bge,效果差多少? 生成模型用 4b 还是 8b,差在哪? 最重要的一条:怎么验证它「答得准不准」?还是说,跑通了就算做完了?
这些「为什么」,才是把一个 demo 变成一个能复用、能升级、能写文章的东西的关键。我搭这个工具的时候,每一个选型都逼自己回答「为什么」,而不是「跑通就行」。后面几节,我把几个最关键的决策摊开讲。
三、选型:不是跑通就行,是给未来留地基
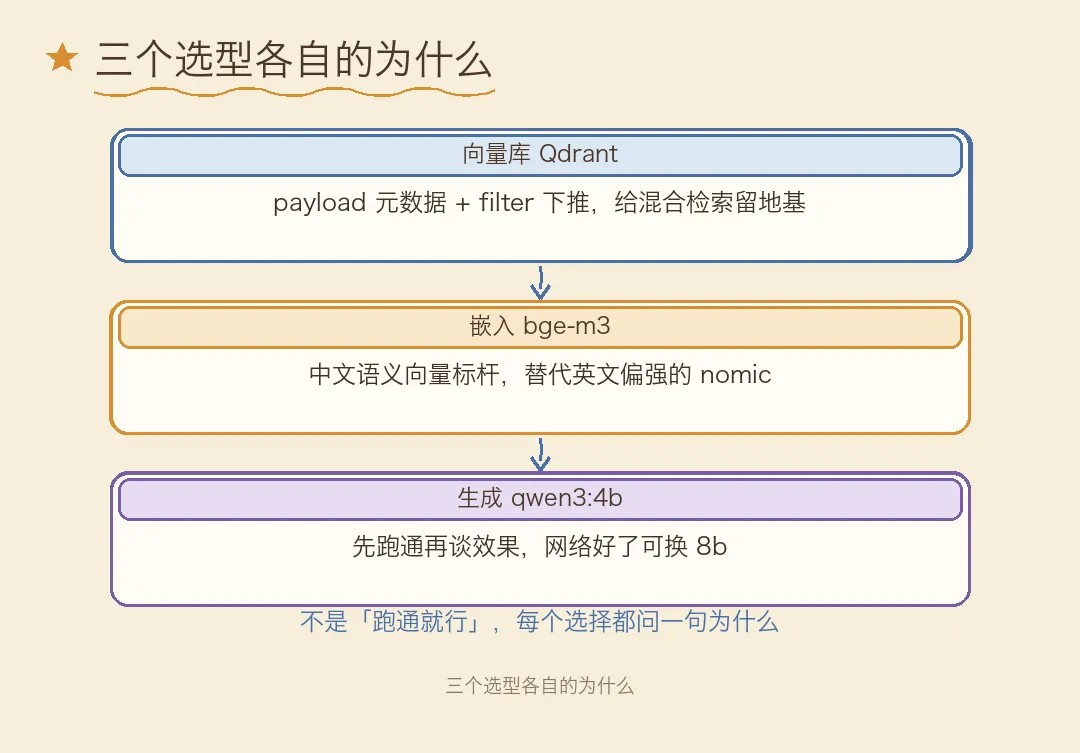
一句话说清楚:向量库、嵌入模型、生成模型这三个选择,每一个都藏着「为什么」,它们决定了这个工具能走多远。
先说向量库。很多人图省事用 Chroma,因为它 pip 一装就能用,零配置。我一开始也是。但很快发现它撑不起「深挖内核」这个目标:Chroma 定位是「嵌入式最小可用」,做 demo 没问题,但它的过滤能力和元数据能力都比较弱,到后面想上「混合检索」这种进阶功能时,底子不够。
于是我换成了 Qdrant。理由很具体:Qdrant 有 payload 元数据和 filter 下推的能力。这带来两个直接的好处:第一,检索时能按元数据过滤,比如「只查某个来源的文档」;第二,这是后续「混合检索」(向量加关键词)的地基。换库不是为了炫技,是为了给后面的功能升级预留正确的数据模型。
再说嵌入模型。嵌入模型负责把文本转成向量,它的质量直接决定检索准不准。默认很多人用 nomic-embed-text,但它是英文偏强。我的文档和提问都是中文,所以我换成了 bge-m3,这是智源出的中文语义向量标杆。这个选择对中文场景是实打实的提升。
生成模型则是 qwen3。一开始想上 8b,效果最好,但 8b 有 5 个多 G,国内网络下载时反复断。权衡之后先降到 4b,跑通优先,效果略降但下载快得多,以后网络好了随时换回 8b,代码一行不用改。
这三个选择的共同点:每个都问过一句「为什么这么选、给未来留了什么余地」,跑通只是及格线。
四、怎么验证它答得准不准
一句话说清楚:一个知识库如果没法验证「准不准」,那它再能跑也只是个玩具。我给它配了一套评测。
这是我最想强调的一点。很多 RAG 项目做到「能跑」就停了,但「能跑」和「答得准」是两回事。一个知识库,如果它检索时找错了段落,生成时编了内容,你完全不知道,那这个工具就不可信。
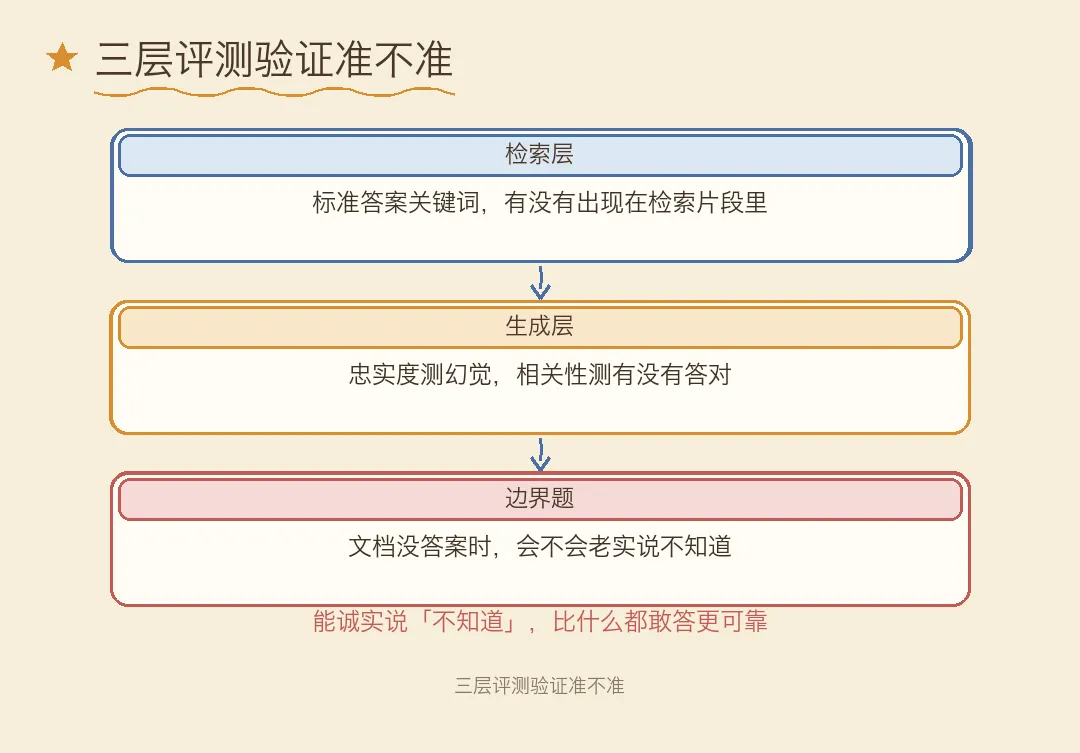
所以我配了一套评测。思路分三层:
检索层,看「找得准不准」。这是硬指标:对每个问题,标准答案里的关键词,有多少出现在检索到的片段里。检索错了,生成一定错,所以这是根。 生成层,看「答得对不对」。让本地模型当裁判,给答案打两个分:忠实度(答案有没有被上下文支撑,测幻觉)和相关性(有没有正面回答问题)。 边界题,看「会不会编」。我故意出了一批「文档里根本没有答案」的问题,比如问它「Qdrant 的 HNSW 参数怎么调」「下一阶段用什么框架」。理想情况下,它应该老实说「根据现有资料无法回答」,而不是硬编一个答案。
第三层是最见功力的。一个知识库的幻觉,恰恰最容易在「文档之外的问题」上暴露。能诚实说「不知道」的模型,比一个什么都敢答的模型可靠得多。
这套评测的另一个价值在后面:等我用 DeerFlow、DeepSeek、Codex 把同一个功能各重写一遍时,每一版都跑一遍同一套评测,就能横向对比「哪个内核检索更准、生成更稳」。评测,是逼出内核优劣的标尺。
光说不练是假把式。我把这套评测真实跑了一遍:20 条测试(事实查询 7 + 综合理解 6 + 边界题 7),全部在本机离线跑完,耗时约 35 分钟。结果是这样:
先说最亮眼的:诚实度满分。7 条「文档里根本没有答案」的刁钻问题(问 HNSW 参数怎么调、下一阶段用什么框架、量化格式区别),它一条都没编,全部回答「根据现有资料无法回答」。这正是 RAG 提示词里那句「如果上下文不足以回答,请直接说无法回答」在起作用:约束写进提示词,模型就能守住。
再说那个不好看的数字:关键词召回 0.67。我如实告诉你它的局限:这个指标是「字面匹配」,标准答案里的关键词必须在检索到的片段里逐字出现才算命中。所以答案对了但措辞不同,它也会扣分。它是「检索质量」的下界估计,不是准确值。要更准的评估得上人工标注相关性(比如 BEIR 那套 qrels),那是后面的事。
最后还有一个有意思的发现:裁判本身也有噪声。相关性均分 0.80 里有两道题被判 0 分,但回看答案,其实答对了,是 qwen3 当裁判时打分不稳定。这暴露了 LLM-as-Judge 的固有局限:让小模型当裁判,裁判自己也会犯错。严谨的做法是换更大的裁判模型或人工复核,这里先如实记录。
五、现在能怎么用
一句话说清楚:clone 下来,起 Ollama,跑起来,就能在浏览器里喂文档、问问题。
具体三步:
# 1. 拉模型(本地 Ollama,零 API 成本) ollama pull qwen3:4b ollama pull bge-m3 # 2. 起服务 cd stage1-langgraph uvicorn app:app --reload --port 8000 # 3. 浏览器打开 http://127.0.0.1:8000仓库地址我会放在文末。代码里自带了三份测试文档,可以先用它跑通,再换成你自己的 PDF 和笔记。
总结
这篇文章讲的是一个零成本、能离线、带评测的本地知识库问答工具。它的核心不是「又一个 RAG demo」,而是三件事:每一个选型都回答「为什么」、配了一套三层评测来验证「准不准」、并且把「用四种框架内核重写同一个功能」定成了主线。
它现在只是第一版,用的是 LangGraph 内核。后面我会陆续用 DeerFlow、DeepSeek Super-Agent、Codex 各重写一遍,每一版都顺着那个框架最核心的设计往前走一步,也都会单独写文章讲清楚「同一个问答,换一个内核,差别在哪」。
如果你也被「光读源码不过瘾」困扰,想亲手搭一个能跑、能评测、还能持续深挖的东西,这个仓库是一个不错的起点。clone 下来,跑一遍,把评测那套思路用在自己的知识库上。
材料来源
项目仓库:github.com/cindycode/local-rag-qa(MIT 协议) 评测脚本:eval/eval_local.py(三层评测:检索召回率 / 忠实度与相关性 / 边界题诚实度) 测试集:eval/qa_testset.py(20 条,事实查询 7 + 综合理解 6 + 边界题 7)