ARTICLE · 1363971
测试人醒醒!还在手敲Excel造假数据?这套Skill早该火了!
“这个接口又报错了,你们查一下,是不是参数传错了?”“哥,我按文档传的,是你们测试数据不对吧?订单和支付金额对不上啊!”
作为一名在测试圈摸爬滚打多年的老鸟,看到这段对话,你是不是血压已经上来了?
在软件测试的鄙视链里,写自动化脚本的看不起点点点的,但无论你是搞自动化的还是做功能测试的,“造测试数据”这件事,绝对是所有测试人共同的噩梦。
为了测个下单退款流程,你要在测试环境里像个不知疲倦的流水线工人一样:注册新账号 -> 新建地址 -> 挑商品 -> 下单 -> 支付 -> 申请退款。如果遇到状态流转、并发回调、异常越权,还得手工去数据库里改字段、拼字符串。
一天下来,代码没写几行,Bug没测出几个,人倒是被几十条“格式不对、校验位不合法、外键关联失败”的假数据折磨得死去活来。
但最近,我在测试圈看到一个大佬分享的神仙玩法,直接颠覆了我对“造数据”的认知。
他抛弃了那些陈旧的数据生成器,也懒得手写一行行枯燥的Faker脚本,而是用了一个专门针对测试工程师定制的 Skill——lemon-test-data-engine。
看完他的实操,我当场就悟了:别再造假数据了,把测试的精力浪费在造数据上,简直就是对测试工程师才华的亵渎!
今天,我就把这个彻底拯救测试人生命的 Skill 拆解给你看,看完你就会发现,以前加过的班,全特么是白加的。
💥 为什么你造的测试数据,总是“一跑就崩”?
我们先来反思一下,为什么手工造的数据总会被研发打回?文档里一针见血地指出了痛点:测试数据不是越多越好,而是要“符合业务关系”。
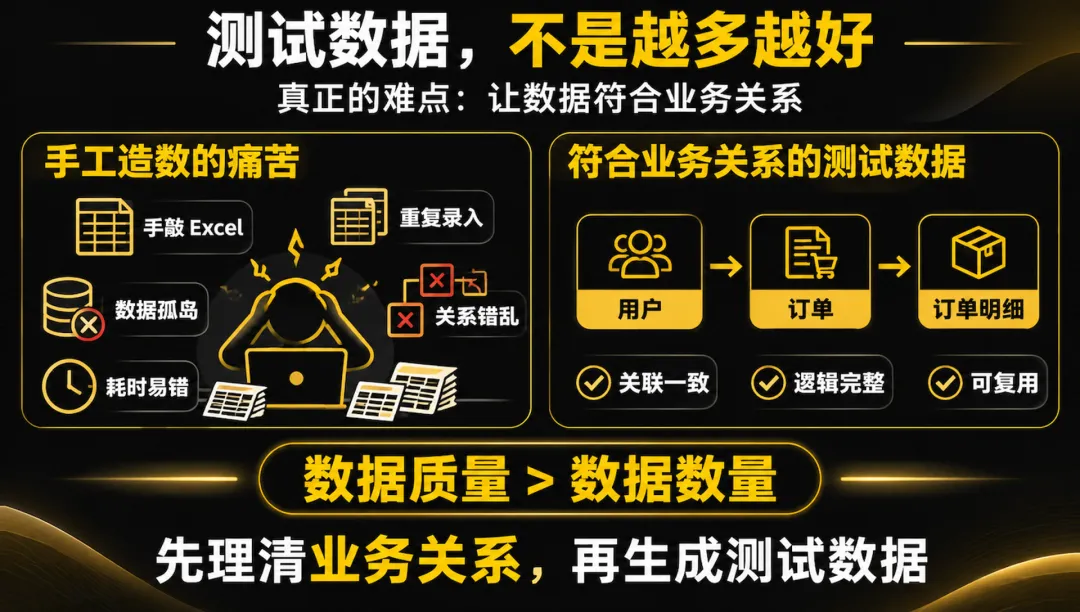
想象一下这几个让你窒息的真实场景:
- 规则全靠“口口相传”:
订单号是 NO+日期+6位流水,结果新来的测试同事不知道,造了一堆Order12345,接口校验直接拦截。 - 隐性错误防不胜防:
手机号造了11位数字,但前三位不是合法号段;身份证造了18位,但最后一位校验码是错的;金额写了 100.5,但系统只收两位小数。 - 表关联比登天还难:
你造了100条会员数据,又造了100条订单数据。结果一测发现,订单里的 customer_id在会员表里根本找不到!你开始手动去 Excel 里玩“连连看”,眼都看花了。 - 异常场景只能靠“玄学”:
你想测“重复支付回调”,手工点两次?结果第二次被前端拦截了。你想测“部分支付”,系统根本不存在这种流程,只能硬造数据,一造一下午。 - 造完一次,无法复用:
辛辛苦苦造了一百条数据,测完就废弃了。下次换个大促场景需要一万条,你只能对着屏幕继续抓头发。
传统的数据生成工具,脑子里装的是“标准的订单长什么样”。但真实的业务千变万化,这叫**“削足适履”**。
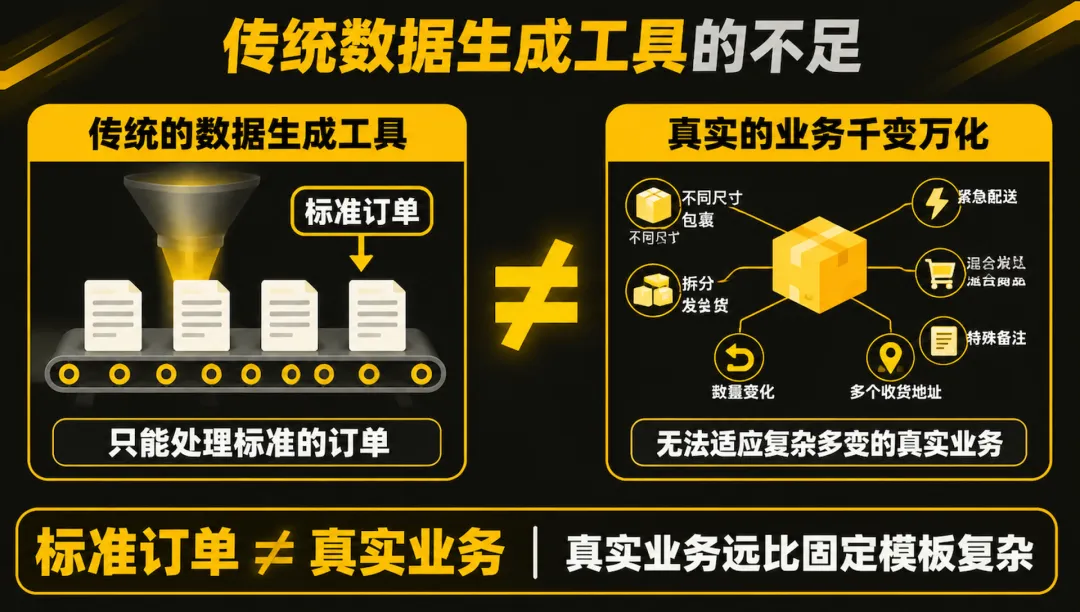
而 lemon-test-data-engine 这个 Skill 的核心理念是:不猜业务对象,优先理解你定义的规则。 你把脑子里的业务规则告诉它,它来帮你搞定底层的一切。
🚀 降维打击:从“手工拧螺丝”到“全自动流水线”
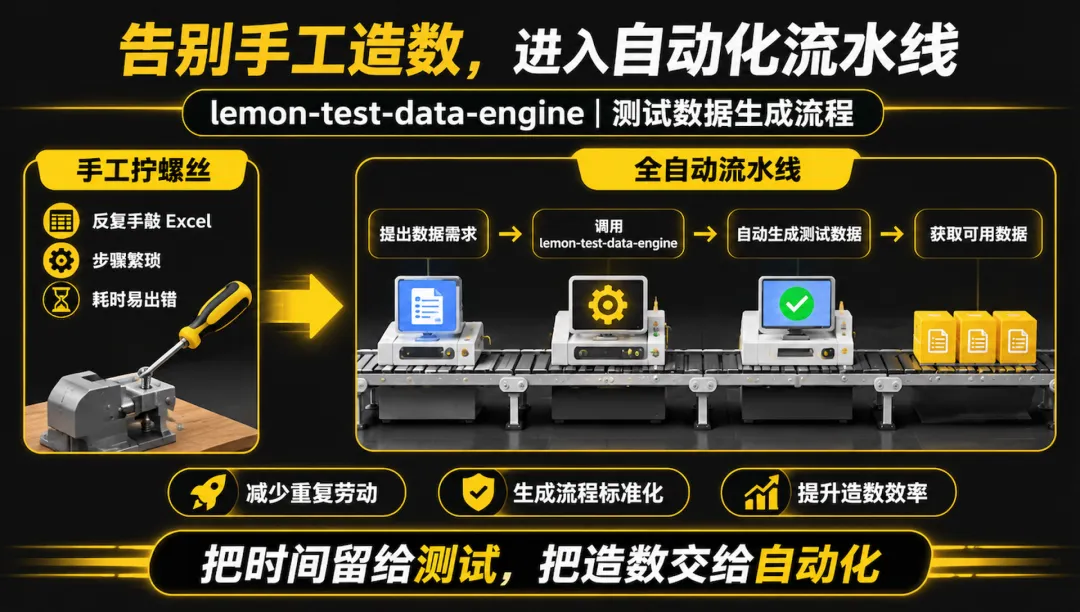
这到底有多爽?我们直接来看实战场景,看看这个 Skill 是怎么把你从苦海里捞出来的。
场景一:接手老系统,没有文档怎么办?
过去: 面对没有完整接口文档的遗留系统,你只能去数据库导出十组历史订单号,然后瞪大眼睛找规律:“嗯……这是日期,这是流水号……”。然后去代码里翻它们是怎么生成的。 现在: 你直接把这几组样例甩给 Skill:
NO20261012000001NO20261012000002NO20261013000001
然后输入指令:“请拆分这些订单号的组成规则,判断序号是否按天重置;先输出你的分析,不要直接生成。”
Skill 会像一个资深架构师一样告诉你:“日期段为 yyyyMMdd,六位序号按天重置。我将其抽象为规则:order_no: "NO{date:yyyyMMdd}{seq:6}"。请确认。” 你只需回一个“确认”。接着,上万个符合历史规则、跨天自动重置、补零位绝不遗漏的完美数据,瞬间生成。
场景二:搞不定的“数据关联”,一句话搞定
过去: 要测会员中心,你需要造100个会员,要求:姓名中文、城市上海、身份证校验位合法,最关键的是——**身份证的地址码必须和城市上海对应!** 手工造?你准备查多少次行政区划代码表? 现在: 你给 Skill 写一段规则:
{"name": "{name}", "city": "{choice:北京市,上海市,广州市,深圳市,杭州市}", "id_card": "{idcard:city}"}
注意看 {idcard:city} 这个指令。它意味着:先生成城市,再根据城市自动匹配对应的身份证地址码。生成出来的人,城市是上海,身份证号绝对是 310 开头,最后一位校验位绝对合法。 这才是真正的懂业务! 彻底告别“城市是上海、身份证却是北京110开头”的弱智逻辑错误。
场景三:复杂的“一对多”与“状态机”
过去: 你想测“一个会员拥有多个订单”的场景,还需要订单状态有已完成、已退款、已作废。 现在: 直接下指令:“生成 100 个会员和 180 个订单,其中 60 个会员拥有 2~3 个订单,其余会员至少拥有 1 个订单;订单通过 customer_id 关联会员。并覆盖草稿、已完成、已退款、已作废状态。”
这个 Skill 内部有极其强大的关系编排(Relationship)模块。它懂得“先造上游、再造下游”,生成的 Excel 或者 JSON 数据,外键严丝合缝,你直接拿去做端到端测试,一键跑通。
场景四:最折磨人的支付幂等与并发回调
过去: 测试支付回调,你需要懂代码的同事帮你写个 Mock 接口,你还要在 Postman 里疯狂造各种“超时”、“重复回调”、“金额不足”的入参。 现在: 你只需要一句话:“生成 50 个订单及支付数据,覆盖全额支付、同一订单两笔支付、三笔支付、部分支付、重复回调、超额支付和零金额异常。”
这个 Skill 生成的数据,连“有效计入金额”、“剩余应付金额”这种极深的业务字段都给你算得明明白白。同一个 payment_id 重复出现时,第二次的回调金额会自动被判定为0。 拿着这种数据去测,研发看了都得喊一声“专业”。
💡 真正的神仙操作:测试经验资产化
整个体验下来,我最震撼的不是它能一键生成上万条数据,而是它真正实现了**“测试经验资产化”**。
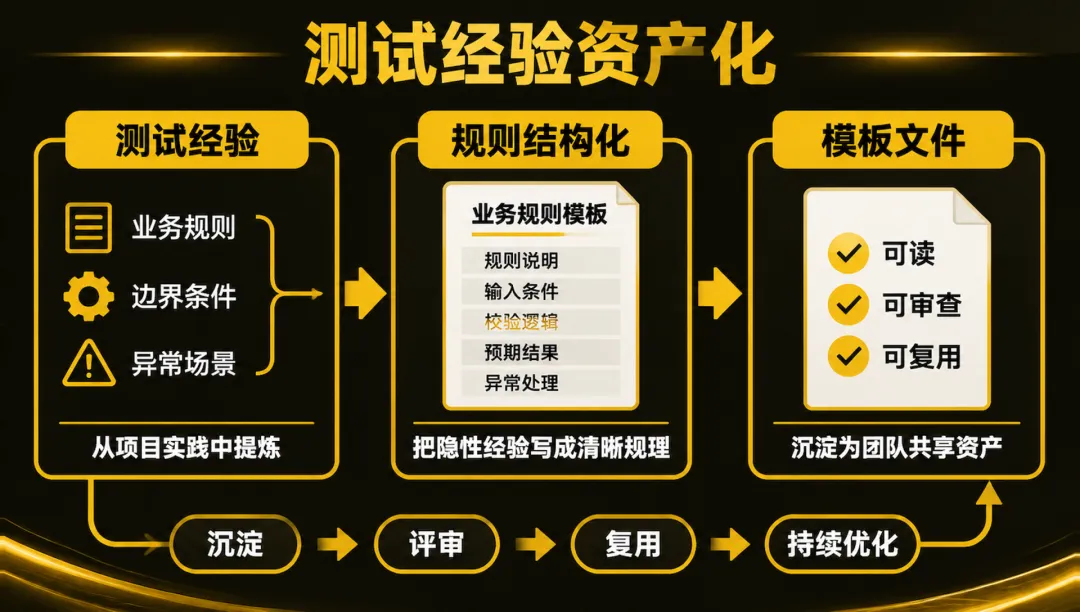
以前,测试老鸟脑子里那些复杂的编号规则、字段约束,随着员工的离职就流失了。新来的员工又得重新踩坑。
现在,你可以把业务规则用 lemon-test-data-engine 沉淀下来,变成一个可读、可审查、可复用的模板文件。
- 接口测试
?导出 JSON/JSONL,直接喂给 Postman。 - 数据库初始化
?导出 SQL INSERT 语句,一键刷库。 - 性能压测
?固定随机种子(Seed),生成十万条关联好的大表数据,且**结果绝对可复现**。第一次跑出 Bug,用同一个 Seed 重新跑,一模一样的 Bug 绝对重现,再也不怕研发说“无法复现”了。
这就是降维打击。当别的测试还在对着 Excel 填数据的时候,你已经建立了一条专属的“数据生产流水线”。
🎁 专属福利:把神仙 Skill 装进你的电脑
看到这里,很多小伙伴肯定心痒痒了:“大佬,这个 Skill 哪里下载?怎么配?”
为了方便大家直接上手,我已经把这个极其强悍的 lemon-test-data-engine 测试数据构造 Skill 打包好了,包括: ✅ 完整的 Skill 压缩包(解压即可在 Cursor/大模型工具中直接调用) ✅ 详细的操作手册和指令模板(连怎么提问都给你写好了) ✅ 五大典型测试场景配置源码(覆盖会员、订单、支付、退款) ✅ 数据校验与导出模块的配置文件
🔥 领取方式:
关注我评论区扣 “666”,我挨个发你。 或者后台直接滴滴我,暗号同上。 
写在最后
AI 时代,淘汰测试人的绝对不是 AI,而是那些比你先拥抱 AI 的同行。
别再用手工的勤奋,去掩盖工具的懒惰。测试的核心竞争力,永远是对业务逻辑的深刻理解和对异常场景的敏锐捕捉,而不是重复劳动。
把造数据这种“脏活累活”扔给 Skill,把省下来的时间拿去喝杯咖啡、多测出几个核心 Bug,他不香吗?
评论区聊聊:你被造测试数据坑得最惨的一次是什么时候? 👇
#软件测试 #AI提效 #测试工程师 #测试开发 #自动化测试 #Cursor #Skill实战 #大厂测试 #职场提效 #打工人日常