ARTICLE · 1370047
DeepSeek 把 App 塞进 API:搜索、读文件、说话一次搞定
这周 DeepSeek 干的事,等于把「毛坯房」改成了「精装房」,你想要的联网搜索、读 PDF、语音对话,开个参数就能用,不用再自己拼三家工具。
我是狐小墨。DeepSeek 把整个 App 塞进 API,我把官方文档从头到尾捋了一遍——搜、读、说、听怎么开、怎么算钱、哪里会踩坑,看完你就能自己上手。
你想过没有:想做个「会上网查资料、能读合同、还能用语音聊」的助手,光是把搜索、OCR、语音这三家工具接进来,就耗掉几周?最烦的不是调接口,是最后还得自己写代码,把三家结果拼回上下文里。
 以前做对话产品,到底累在哪
先说明白,以前你调 DeepSeek 拿到的只是「模型」本身。
想让它上网搜东西、读一份 PDF、用语音回你——这些能力得你自己去外面找。
搜索找一家,文档解析找一家,语音转文字再找一家。
然后写一堆「胶水代码」,把三家的结果拼回 prompt 里,再喂给模型。
最坑的不是调接口,是拼接。
工具调用循环要自己写、中间状态要自己管、多轮引用要自己处理,任何一环出错,整个对话体验就崩了。
 这次到底开放了什么
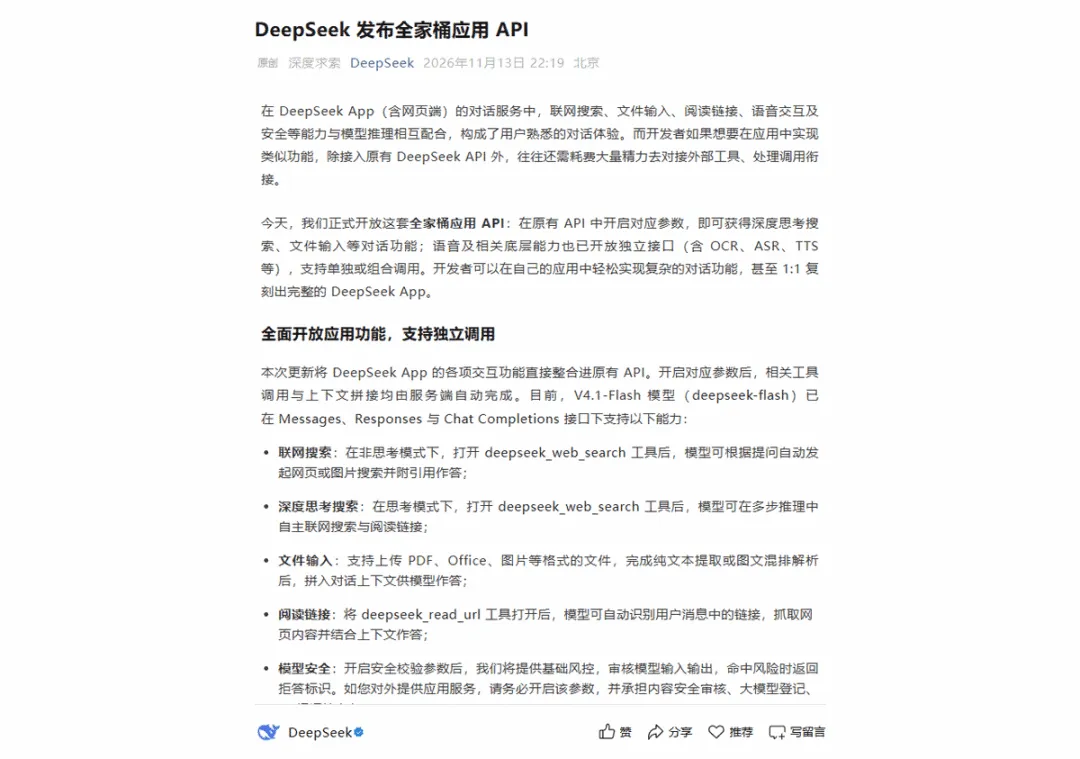
11 月 13 日晚,DeepSeek 正式开放「全家桶应用 API」。
一句话:App 里的交互能力,全开成了可调用的接口。
分两块看,别被一堆功能名绕晕。
第一块:对话内直接开参数——还是调原来的接口,只是多开几个开关。
联网搜索、深度思考搜索、文件输入、阅读链接、模型安全,这五个都是在原有 API 里加参数就有。
第二块:独立接口——不想走整套对话,可以单点调。
Search(搜索)、Fetch(网页抓取)、OCR(文字识别)、ASR(语音转文字)、TTS(文字转语音),都能单独调,也能组合。
官方那句「可以 1:1 复刻完整的 DeepSeek App」,底气就在这两块加起来。
 关键变化:工程负担转移
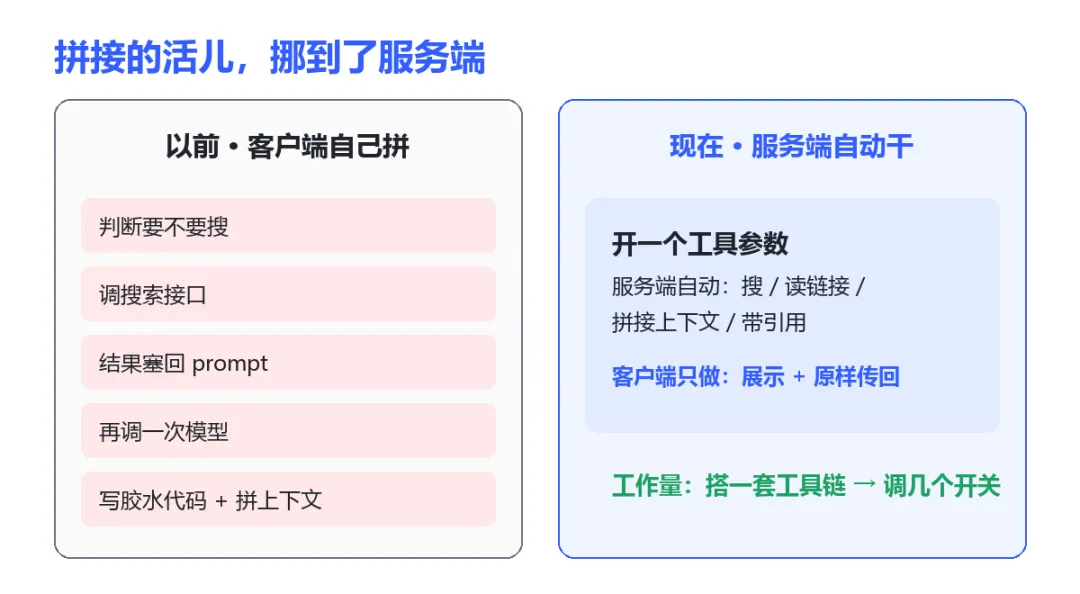
这次最值得说的,是工程负担的转移。
以前你接联网搜索,得自己判断问题要不要搜、调搜索接口、把结果塞回 prompt、再调一次模型。
现在你只要把 deepseek_web_search 这个工具打开,服务端自己决定什么时候搜、搜什么、把结果拼好,连引用标注都帮你做好。
客户端要做的只剩两件事:把返回的内容块展示出来,下一轮原样传回。
工具调用、上下文拼接、多轮引用,全在服务端完成。
对一个开发者来说,工作量从「自己搭一套工具链」压到「调几个开关」。
 怎么接入:最小链路五步
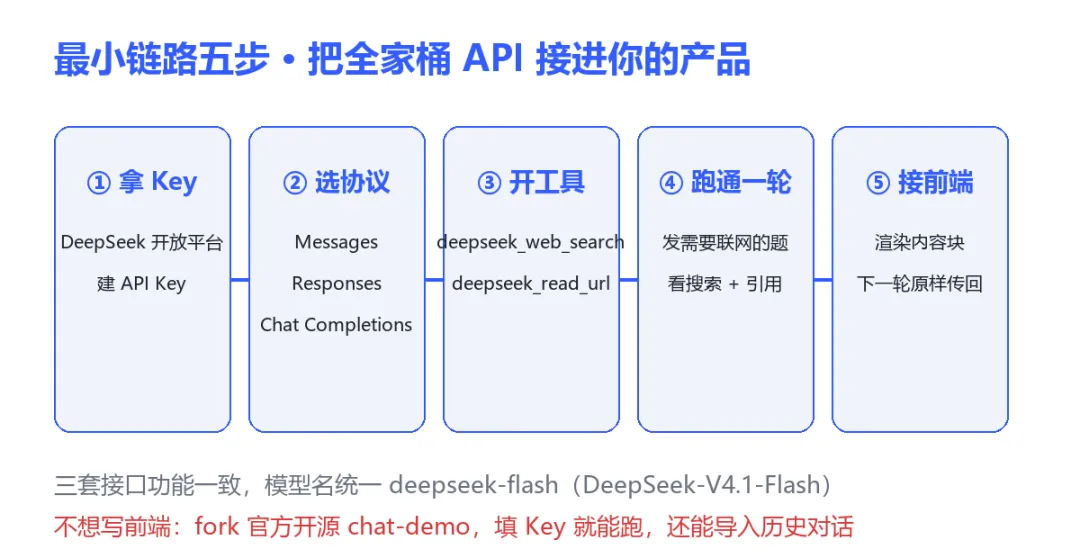
第一步,拿 Key。去 DeepSeek 开放平台建一个 API Key,存到环境变量里,别写进代码。
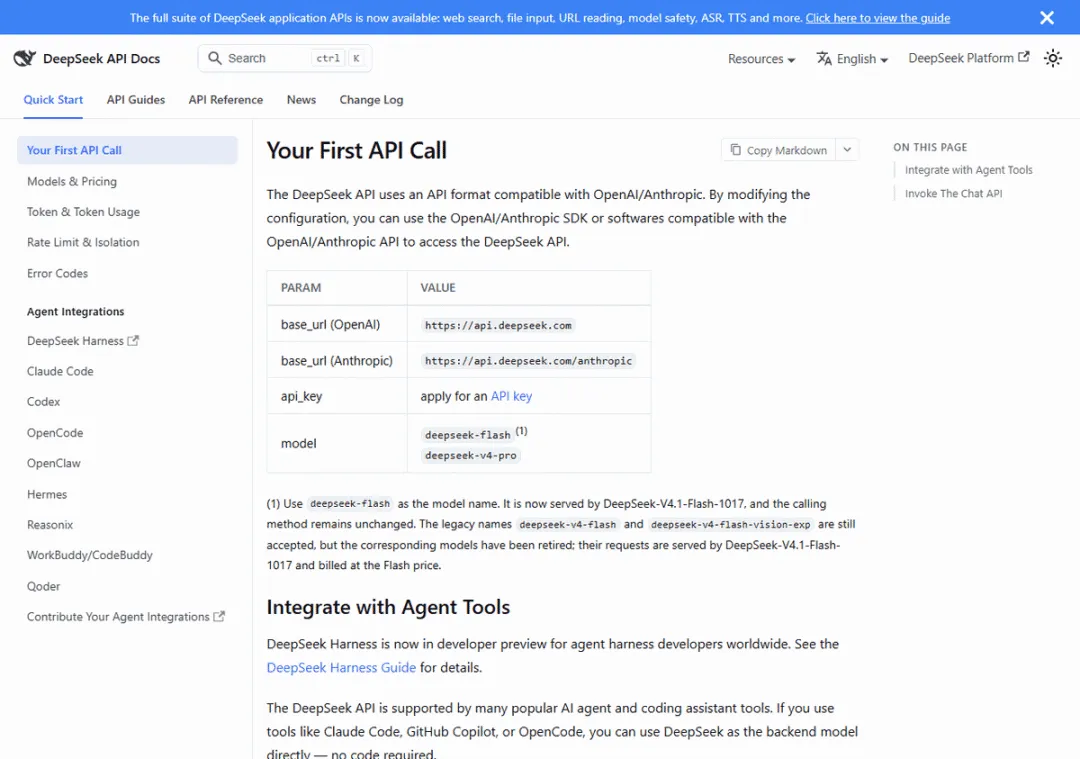
第二步,选协议。Messages(熟悉 Anthropic 风格用这个)、Responses、Chat Completions(兼容性最广),三套接口功能一致,模型名统一填 deepseek-flash。
第三步,开工具。在请求的 tools 里加上 deepseek_web_search 和 deepseek_read_url 两个定义;要安全审核,再加一个 safety_check 参数。
第四步,跑通一轮。发一个需要联网的问题,看返回里有没有搜索过程和引用。
第五步,接前端。把返回的内容块渲染出来,下一轮原样传回,多轮对话就成了。
deepseek-flash,就是 DeepSeek-V4.1-Flash 模型在 API 里的名字,现在这套能力就它支持。
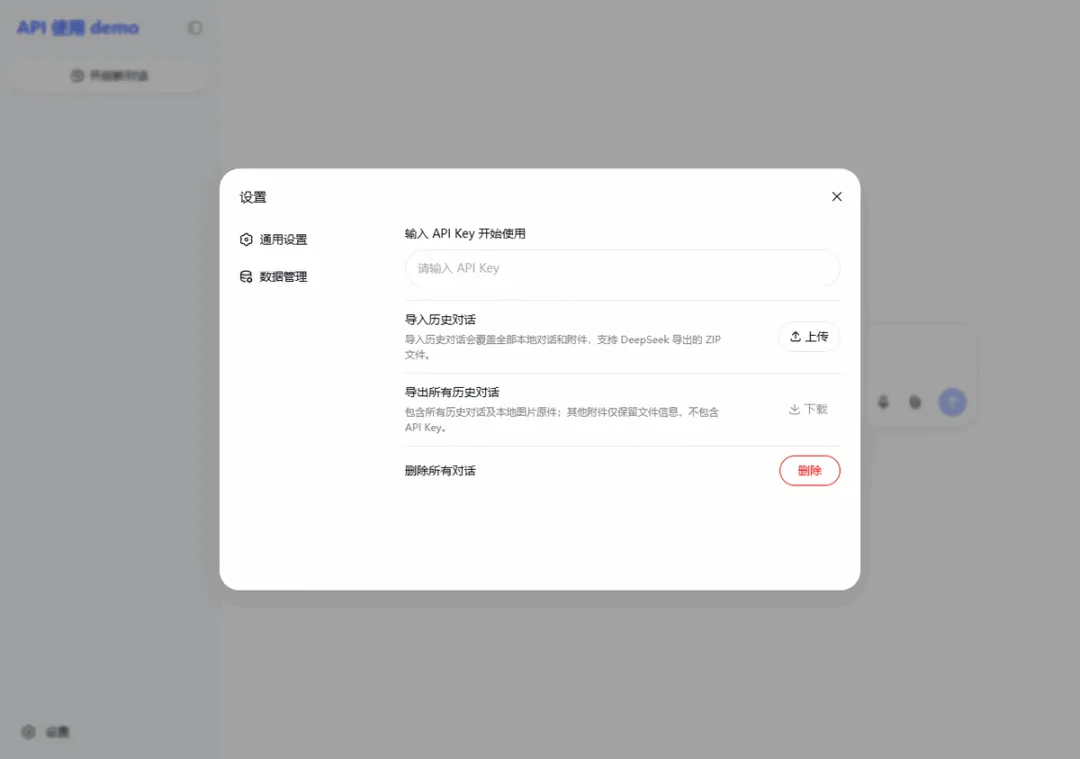
不想写前端的,官方还开源了一个 chat-demo,填 Key 就能跑,还能把你从 DeepSeek 网页版导出的对话历史导进来接着聊。
 算笔账:到底便不便宜
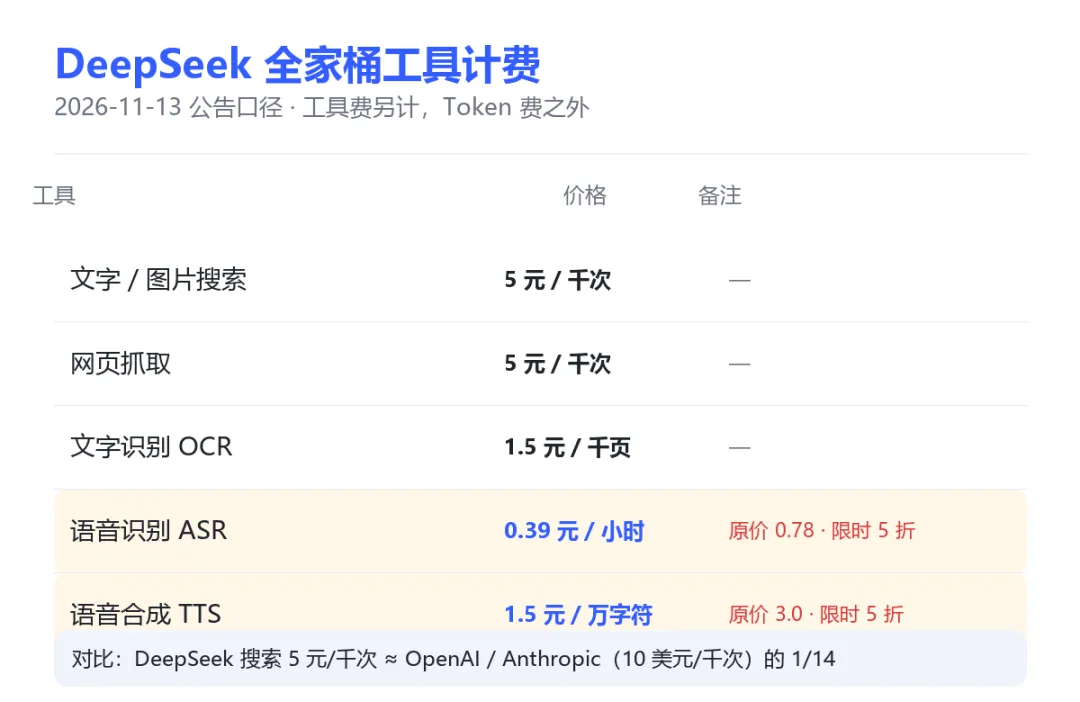
工具费是另外算的,在 Token 费之外。
文字/图片搜索,5 元一千次。
网页抓取,5 元一千次。
文字识别(OCR),1.5 元一千页。
语音识别(ASR),0.39 元一小时,原价 0.78,现在限时五折。
语音合成(TTS),1.5 元一万字符,原价 3.0,同样是限时五折。
做个真实场景算一下:一个每天一万次搜索的对话产品,工具费大概 50 元一天,加上 Token 费也就几十块。
注:以上为官方定价口径,实际以 DeepSeek 开放平台计价为准。
对比一下就更有感觉——OpenAI 和 Anthropic 的同类搜索工具,定价约 10 美元一千次,是 DeepSeek 这个价的十几倍。
 一个容易忽略的坑:参数陷阱
这是我把文档翻到最后才发现的,写在这提醒你。
一旦你开了搜索、读链接或安全校验,服务端会忽略你传的一些采样参数——比如 temperature、top_p、stop。
不是报错,是静默忽略。
对已经在跑的项目,这意味着你之前调的「温度」可能突然不生效了。
还有一个:max_tokens 限制的是单步推理的输出,不是整轮的总输出。
多步工具轮跑下来,实际烧掉的 token 可能比你设的上限多。
已经在用 DeepSeek 的团队,升级前把这两条写进配置评审清单,别上线了才发现。
 这条红线别省
如果你做的是面向公众的服务,必须开启 safety_check 安全校验参数。
官方说得很直白:开启后 DeepSeek 会审核模型输入输出,命中风险就返回拒答标识。
同时你要自己承担内容安全审核、大模型登记、AI 标识这些义务。
这一条属于硬要求,踩到就是合规风险,别等到被约谈才想起来补。
 谁该用,怎么用
想快速验证产品:直接 fork 那个 chat-demo,填 Key 就能跑,界面功能都现成。
已经在用 DeepSeek API 的团队:先加参数试搜索和读文件,升级成本很低,小范围验证后再全量切。
做垂直工具的:用独立接口,只要搜索就调 Search,只要 OCR 就调 OCR,按需付费,不用为用不到的能力买单。
 门槛降低了,然后呢
模型厂商以前卖「脑子」,现在开始卖「手脚」。
把整个 App 的端到端能力打包开放,说明厂商的边界在往应用层延伸。
对开发者是好事:搭对话产品的门槛被砍到脚踝,过去几周的活现在几天能干完。
但另一面,应用层的同质化会加速。
当所有人都能用同一套接口复刻同一个产品,差异就只能来自场景理解、数据积累、体验优化。
门槛降低从来都是双刃剑。
关键看你能不能在这个门槛降下来之后,做出别人做不出来的东西。
OK,就分享到这里,[本文收录到 AI 工具指路]。
我是狐小墨,持续分享 AI 编程干货,觉得有用记得点赞收藏关注。
也欢迎在评论区聊聊:你打算把 DeepSeek 这套全家桶 API 用到哪?是先给自家 Agent 加联网搜索,还是先试试复刻一个语音助手?
#DeepSeek #API #Agent #编程 #大模型