ARTICLE · 1034949
【AI安全】40个Agent/MCP漏洞归成13类后,扫描器为何仍只能找候选
一、从40个披露到13个签名,重复失效比单个漏洞更值得警惕 🧩
AI 时代!人人都在深耕 AI 安全,你缺的就是这关键一步!
AI 正重塑安全边界,与其在门外徘徊,不如直接掌握主动权!
免费课程持续更新
https://space.bilibili.com/452583051/lists/7870008?type=season
agent-security-explore 在 2026 年 9 月 6 日公开固定版本研究材料,把 40 个负责任披露中的 Agent/MCP 漏洞归纳成 13 类失效模式。这些模式包括护栏可被配置工具关闭、名单绕过、可控的收容锚点、默认放行、无鉴权网络暴露、浏览器打开对端 URL,以及白名单命令本身成为出口。🔎 项目的价值不在又列一张漏洞清单,而在证明相同工程错误会跨多个实现重复出现。
Oxo Security 的判断是:Agent 安全的主要缺口常在模型调用之前和之后,模型本身反而不是唯一变量。⚠️ 一个 MCP server 如果默认监听宽地址、没有 Origin/Host 校验、能执行未固定版本包,或把“安全目录”交给模型填写,那么再强的提示词防护也无法修复基础设施边界。
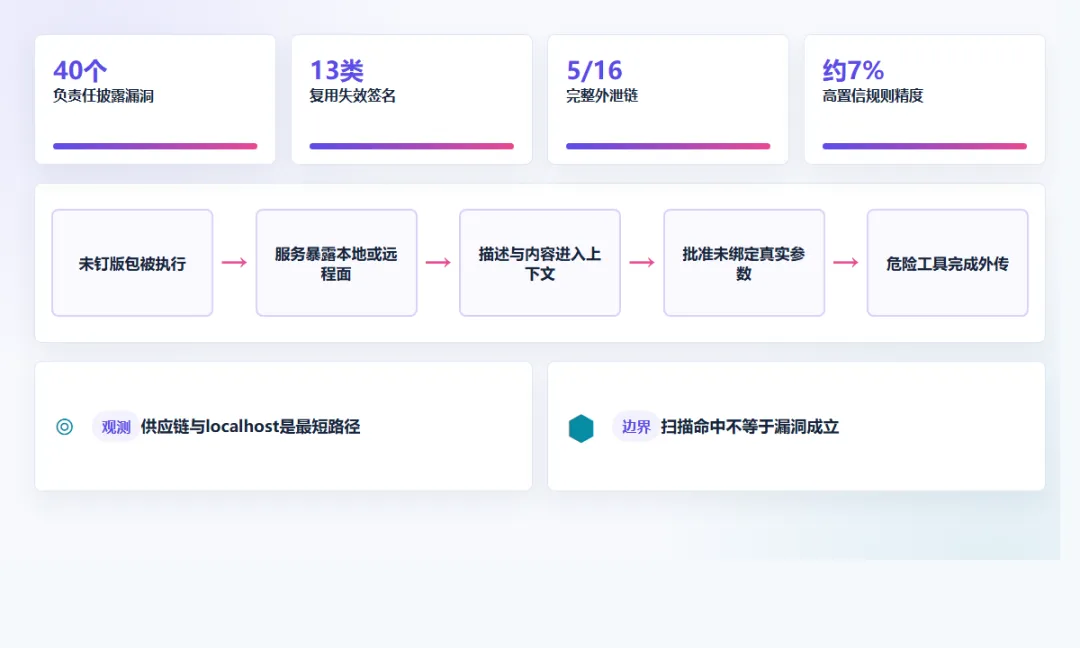
这些比例来自项目选择的公开样本和测量口径,尚未经过独立复现,也不能代表整个 MCP 生态。📌 可行动的结论是把数字当作排查优先级,而不是当作行业发生率。企业应在自己的 server、客户端、配置仓库和网络暴露面上重新测量。
二、五层边界没有接上时,批准按钮只是视觉安慰 🚧
一条真实链路通常跨过包分发、本地启动、工具描述、审批和网络出口五层。未钉版本的 npx/uvx 配置先在机器上拉取并执行包;server 再以 localhost 或远程接口暴露工具;工具描述和内容进入 Agent 上下文;用户批准时看到的摘要可能没有绑定真实参数;最后危险工具把数据发往外部。🔗 每一层都只验证自己看到的局部信息,组合起来却没有任何一层对最终副作用负责。
项目使用 127.0.0.1 接收端、canary 回传、真实 Agent 驱动和三侧日志裁判,在 16 次端到端运行中确认 5 次完整外泄。🧪 这类判定比“模型输出了敏感字符串”更严格:只有 canary 到达接收端才算链路打通。
防守顺序应沿链路反向设置:
📦 分发层要求发布者、哈希和依赖版本固定,禁止首次运行静默下载; 🖥️ 启动层明确展示 server 命令、工作目录、环境变量与网络监听; 🧾 描述层把工具元数据视为不可信供应链输入,保存来源指纹; 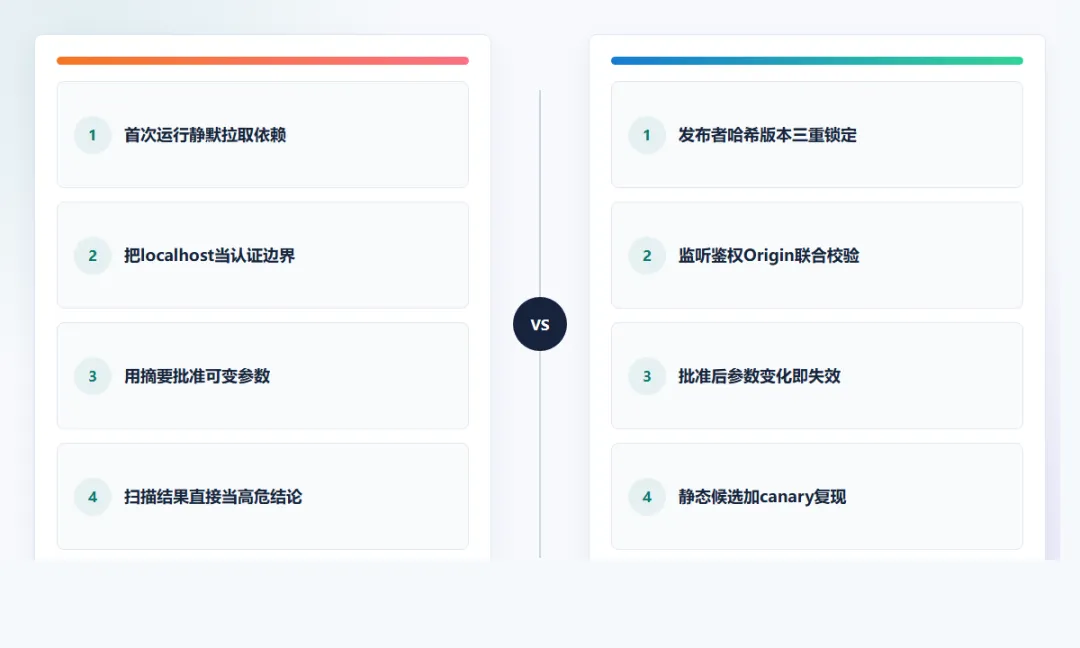
✅ 审批层绑定最终工具名、完整参数、目标资源和会话状态; 🌐 出口层对私网、云元数据和未知域名默认拒绝并记录; 🪪 远程 server 使用独立身份与短期凭证,而不是只判断“能连通”。
批准必须是对即将发生的具体动作签名,不能是对一个模糊意图点头。🔐 参数在批准后被重写、重定向跟随到新主机、或工具内部展开第二次调用,都应使原批准失效。
三、7%的高置信精度,为什么反而是一条诚实的工具边界 📏
🎯【7%的高置信精度,为什么反而是一条诚实的工具边界 📏】
这一节真正关键的不是「7%的高置信精度,为什么反而是一条诚实的工具边界 📏」这个概念本身,而是它背后的判断路径、执行边界和可复用方法。
它怎样落到真实安全团队的工作流里?哪些细节会直接影响 AI 代理的可靠性?
加入 Oxo AI Security 知识星球,可查看本节完整内容,系统掌握「7%的高置信精度,为什么反而是一条诚实的工具边界 📏」的完整拆解与实战用法。
📚 AI 文献解读:最前沿的 LLM 安全论文深度剖析。
🐛 AI 漏洞情报:第一时间掌握主流大模型的 0-day 漏洞与越狱方式。
🛡 AI 安全体系:从红队攻击到蓝队防御的全方位知识图谱。
🛠 AI 攻防工具:红队专属的自动化测试与扫描工具箱。
🚀立即加入 Oxo AI Security 知识星球,掌握 AI 安全攻防核心能力!