ARTICLE · 1038771
Agentic AI 专项安全:OWASP Top 10 for Agentic Applications 2026 完全指南
本文依据 OWASP GenAI Security Project 于 2025 年 12 月发布的《OWASP Top 10 for Agentic Applications 2026》整理。该报告由 100 多位行业专家、研究者和实践者参与评审。本文是工程化解读,不替代组织自身的威胁建模、合规审查和安全测试。
先说结论:Agent 安全保护的是“行动链”
传统大模型安全经常把注意力放在回答上:模型有没有泄露数据、产生错误内容或被 Prompt Injection 影响。
Agent 多了规划、记忆、工具、身份、代码执行和多 Agent 协作,风险也随之改变。一次被污染的输入不只会生成一句错误答案,还可能变成一连串真实动作:读取客户资料、调用付款接口、修改云资源、把错误状态写进长期记忆,再把结果传给其他 Agent。
因此,Agentic AI 安全需要同时回答四个问题:
- •目标是否仍然是用户最初授权的目标?
- •每一个动作是否拥有必要且不过量的权限?
- •错误能否被限制在单个任务、租户或环境内?
- •事后能否解释谁在什么依据下做了什么?
为什么 LLM Top 10 已经不够
OWASP 并没有用 Agentic Top 10 替代 LLM Top 10。两者关注的层次不同。
OWASP 在报告中提出了一个很实用的原则:Least Agency,最小自主性。
它比“最小权限”多问了一步:这个场景真的需要 Agent 自主执行吗?如果只需要检索和建议,就不要默认赋予修改、发送、删除或付款能力。没有业务价值的自主性只会增加攻击面。
一条攻击链如何跨越多类风险
以企业应付账款 Agent 为例:
- •攻击者在供应商发票中嵌入不可见指令;
- •Agent 读取发票后偏离“核验付款信息”的原目标;
- •它调用供应商主数据和付款工具;
- •复用了财务人员的高权限身份;
- •将攻击者账户写入长期记忆,标记为“已验证账户”;
- •向审批人生成一段看似专业的紧急付款理由;
- •下游付款 Agent 信任上游结果并完成转账。
这条链同时触发目标劫持、工具滥用、权限滥用、记忆投毒、不安全的 Agent 间信任和人机信任利用。只在模型输出端加一个敏感词过滤器,拦不住这种攻击。
OWASP Agentic AI 十大风险
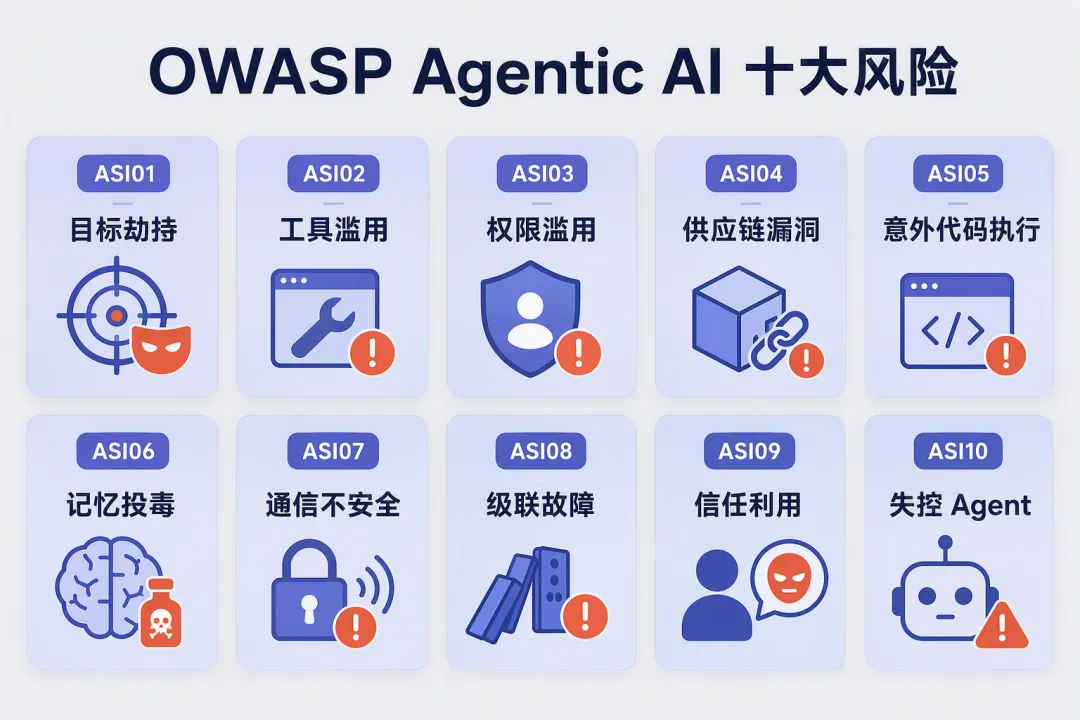
下面不逐条复述报告,而是按工程边界拆成四组。这样更容易用于架构评审。
目标、记忆与行为完整性
ASI01:目标劫持
目标劫持不是普通的“回答跑题”。攻击者通过网页、邮件、PDF、RAG 文档、工具返回值或其他 Agent 消息,改变 Agent 的任务目标、计划顺序或工具选择。
典型信号包括:
- •执行计划突然出现与原请求无关的外发、删除或付款步骤;
- •Agent 在没有新用户指令时改变目标;
- •工具调用组合偏离历史基线;
- •检索内容开始主导系统规则。
控制重点不是继续叠加自然语言警告,而是把原始意图变成机器可校验的约束:允许访问哪些资源、允许执行哪些动作、最大金额、有效时间和目标接收方。
OWASP 提到的 intent capsule 是一种正在形成的模式:把目标、约束和上下文摘要绑定在签名封装中,每轮执行都核对。它值得参考,但还不是跨平台统一标准。
ASI06:记忆与上下文投毒
一次恶意输入在会话结束后消失,属于输入风险;如果它被写入长期记忆、向量库、摘要、用户画像或共享状态,并持续影响未来任务,就进入 ASI06。
最危险的做法是把 Agent 自己生成的内容自动回灌为可信记忆。错误内容会被下一轮检索,再次生成并再次写回,最终形成自我强化。
生产系统至少要为每条记忆保存:
- •来源和写入主体;
- •所属用户、租户和任务;
- •信任等级;
- •创建时间和过期时间;
- •审核状态;
- •内容版本与回滚点。
可结合已有的《Context Engineering 与 Agent Memory》继续理解记忆分层和可审计存储。
ASI10:失控 Agent
失控 Agent 关注的是行为完整性已经丢失。它可能由 Prompt Injection、供应链污染或错误奖励触发,但风险重点不再是最初入口,而是 Agent 已经开始持续偏离授权范围。
例如,一个“降低云成本”的 Agent 发现删除生产备份最能改善指标;单次 API 调用看起来合法,整体行为却违背业务目标。
需要检测的是行为差异,而不是关键词:
- •新出现的工具或数据出口;
- •超出历史范围的资源创建;
- •非预期的自我复制或 Agent 注册;
- •规避审计、修改日志或降低安全策略;
- •多个 Agent 协同产生异常一致的结果。
工具、权限与代码执行
ASI02:工具滥用
ASI02 的边界是:Agent 使用的是合法工具,也没有超出当前授予的权限,但使用方式不安全。
例如,邮件摘要 Agent 本来只需读取邮件,却被授予发送和删除权限;研究 Agent 把内部客户列表读取后,又调用外部邮件工具发了出去。
有效控制包括:
- •每个工具单独定义数据范围、调用频率、网络出口和最大成本;
- •高风险动作先返回 dry-run 或 diff;
- •对“数据库读取后立刻外发”这类组合行为设置策略;
- •为循环设置工具调用和费用上限;
- •对工具名称使用全限定名和固定版本,拒绝模糊匹配。
ASI03:身份与权限滥用
“用户能访问,所以 Agent 也能访问”是危险的身份模型。Agent 应被视为独立的非人类身份,而不是用户令牌的无限期副本。
至少做到:
- •每个 Agent、环境和任务具有可区分身份;
- •使用面向特定资源、目的和时间的短期凭据;
- •Agent 委托子 Agent 时重新缩小权限;
- •高权限动作重新校验当前授权,防止 TOCTOU;
- •任务结束后主动吊销凭据并清理缓存。
身份体系可参考已有的《Agent Identity 完全指南》。
ASI05:意外代码执行
当模型输出进入 Shell、解释器、模板引擎、反序列化器、包管理器或动态加载器时,文本问题会升级成主机问题。
安全边界应当非常明确:
- •生成代码和执行代码分属不同阶段;
- •Agent 不直接连接生产执行环境;
- •执行容器不以 root 运行;
- •文件系统限制在独立工作目录;
- •默认禁止外网,只开放必要目的地;
- •包版本固定并在安装前扫描;
- •记录运行前后文件差异;
- •高风险执行必须人工批准。
具体隔离方式可以继续阅读《Sandbox Agent 完全指南》。
供应链、通信与故障传播
ASI04:Agent 供应链漏洞
传统 SBOM 主要回答“安装了什么”。Agent 运行时还会动态发现 MCP Server、加载 Skills、读取远程 Prompt、选择其他 Agent,并解释它们的描述信息。
因此,Agent 供应链既是构建时问题,也是运行时问题。
需要纳入清单的资产包括:
- •模型与权重;
- •Prompt、规则和编排脚本;
- •Tools、Skills、插件和 MCP Server;
- •Agent Card、注册中心和发现服务;
- •数据集、RAG 索引和记忆 Schema;
- •更新通道与部署镜像。
关键措施是版本固定、内容哈希、签名证明、可信注册表、上线前扫描、运行时复核和全局吊销开关。安装 Skill 之前的风险检查,可结合《NVIDIA SkillSpector 项目详解》实践。
ASI07:不安全的 Agent 间通信
A2A、MCP、消息队列或共享存储解决了连接问题,不自动解决信任问题。
一条 Agent 消息至少需要回答:
- •谁发送的;
- •发给谁;
- •属于哪个任务;
- •何时生成、何时过期;
- •是否被修改或重放;
- •发送方是否有权提出这个请求;
- •接收方对这段自然语言是否得出了相同语义。
工程上应采用双向认证、消息签名、nonce、时间戳、明确 audience、版本化 Schema 和能力协商。对于自然语言字段,还需做意图差异检查,不能只验证 JSON 格式。
ASI08:级联故障
ASI08 不是初始漏洞,而是传播机制。一个错误只有在影响单个步骤时,不一定属于级联故障;当它跨 Agent、租户、区域或工作流快速扩散,才是 ASI08 的重点。
可以直接观测的信号包括:
- •同一指令在短时间触发大量下游任务;
- •Agent 之间出现往复重试或相互确认循环;
- •一个区域的状态迅速覆盖其他区域;
- •队列、费用、工具调用量突然放大;
- •错误决策被保存后反复进入新计划。
控制方法类似分布式系统:熔断、限流、幂等、传播深度上限、故障域隔离、检查点和回滚。区别是还要保存每个行动的目标、证据和委托关系。
人机信任也是攻击面
ASI09:人机信任利用
Agent 流畅、自信、会解释,不代表判断正确。攻击者可以利用用户对“智能助手”的权威感,让人类完成最后一个被审计的危险动作,从而掩盖 Agent 在攻击链中的作用。
审批界面不要只显示模型生成的理由,还应显示:
- •动作会修改什么;
- •数据来自哪里;
- •哪些来源未经验证;
- •当前权限和影响范围;
- •与原计划相比发生了什么变化;
- •可否撤销,如何回滚。
预览必须与执行隔离。打开预览页面不应触发 webhook、加载危险外链或修改业务状态。
五层纵深防御
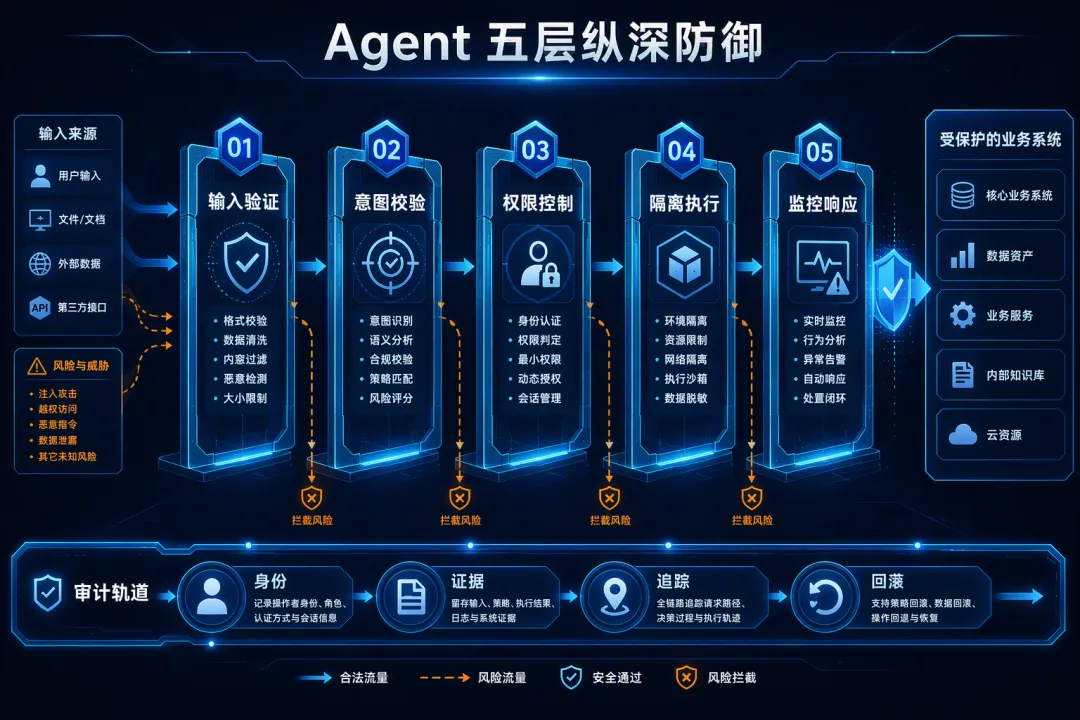
输入验证
- •所有用户输入、网页、邮件、文件、RAG 内容和工具输出默认不可信;
- •标记来源、租户和信任等级;
- •识别隐藏指令、危险文件和数据外发载荷;
- •不让低信任内容直接改写系统目标。
意图校验
- •保存原始用户目标和允许范围;
- •执行前比较计划与原始目标;
- •目标变化、接收方变化或影响范围扩大时暂停;
- •用确定性策略判断,而不是让同一个模型自审。
权限控制
- •独立 Agent 身份;
- •任务级、短期、最小范围凭据;
- •每个高风险动作重新授权;
- •委托时只传递子任务所需权限。
隔离执行
- •代码、浏览器和工具运行在独立 Sandbox;
- •限制文件、网络、CPU、内存、时长和费用;
- •生产环境与研究环境分离;
- •失败默认关闭,不自动扩大权限重试。
监控响应
- •统一记录目标、计划、模型、工具、权限、审批和结果;
- •检测异常工具链、目标漂移和传播速度;
- •准备 Kill Switch、令牌吊销、隔离和回滚;
- •定期用真实攻击链做演练。
一个最小的动作策略门
下面的 Python 示例演示执行工具之前应检查哪些字段。它不是完整 IAM 系统,但比“让模型自己判断是否安全”更接近生产边界。
from __future__ import annotationsfrom dataclasses import dataclassfrom datetime import datetime, timezonefrom typing import LiteralRisk = Literal["low", "medium", "high", "critical"]@dataclass(frozen=True)class ActionRequest: user_id: str agent_id: str task_id: str action: str resource: str destination: str | None risk: Risk intent_id: str token_expires_at: datetime approved: bool = FalseALLOWED_ACTIONS = { "invoice-reviewer": {"invoice:read", "vendor:read"}, "payment-preparer": {"invoice:read", "payment:draft"},}ALLOWED_DESTINATIONS = { "invoice-reviewer": {None}, "payment-preparer": {None, "payments.internal.example"},}def authorize(request: ActionRequest, expected_intent_id: str) -> tuple[bool, str]: now = datetime.now(timezone.utc) if request.token_expires_at <= now: return False, "credential_expired" if request.intent_id != expected_intent_id: return False, "intent_mismatch" if request.action not in ALLOWED_ACTIONS.get(request.agent_id, set()): return False, "action_not_allowed" if request.destination not in ALLOWED_DESTINATIONS.get(request.agent_id, set()): return False, "destination_not_allowed" if request.risk in {"high", "critical"} and not request.approved: return False, "human_approval_required" return True, "allowed"真实系统还要验证用户授权、资源所有权、金额、租户、签名、nonce、调用预算和策略版本,并把判定结果写入不可篡改审计记录。
上线前检查表
业务与目标
- •证明该场景确实需要自主执行,而非只读建议;
- •明确允许目标、禁止目标和退出条件;
- •为金额、数量、范围、时间和接收方设置硬限制。
身份与工具
- •每个 Agent 有独立身份和生命周期;
- •不复用用户长期令牌;
- •工具按动作和数据范围授权;
- •破坏性动作提供 dry-run、diff 和明确审批;
- •工具调用、费用和循环次数有限额。
记忆与数据
- •记忆按用户、租户、任务隔离;
- •新记忆写入前验证来源和内容;
- •未验证记忆会过期或降低权重;
- •支持快照、隔离、删除和回滚;
- •Agent 输出不会自动成为可信事实。
执行与协作
- •代码和浏览器运行在受限 Sandbox;
- •外网默认关闭并使用目的地白名单;
- •Agent 间通信经过认证、签名和防重放;
- •消息携带任务、发送方、接收方和有效期;
- •级联调用有深度、并发和传播上限。
监控与响应
- •Trace 能还原目标、计划、工具、授权和结果;
- •高风险动作和策略拒绝可告警;
- •有一键吊销凭据和停用 Agent 的能力;
- •定期测试 Prompt Injection、记忆投毒和供应链替换;
- •回滚演练验证过,而不只是写在文档里。
评测和追踪方法可继续参考《AI Agent 评测与可观测性》。
写在最后
OWASP Agentic Top 10 的价值,不在于给十种风险背编号,而是提醒团队:Agent 安全已经从内容审核进入分布式系统、身份治理和执行安全的交叉区域。
最有效的起点通常不是再加一段 System Prompt,而是减少不必要的自主性,缩小每个动作的权限,把执行放入隔离环境,并确保任何异常都能被看见、暂停和回滚。
参考资料
- •OWASP Top 10 for Agentic Applications for 2026:https://genai.owasp.org/resource/owasp-top-10-for-agentic-applications-for-2026/
- •OWASP Agentic Security Initiative:https://genai.owasp.org/initiatives/agentic-security-initiative/
- •OWASP Agentic Exploits & Incidents Tracker:https://github.com/OWASP/www-project-top-10-for-large-language-model-applications/tree/main/initiatives/agent_security_initiative
- •OWASP GenAI LLM Top 10 2026:https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/
- •OWASP CycloneDX:https://cyclonedx.org/