ARTICLE · 1039710
我给10个AI写作工具发了同一套试卷,最后只准备留下3个
【为什么突然开始测AI】做这个账号的第六天,我把镜头转回来对准了自己。前五天都在研究平台、项目、粉丝、阅读和收益,但真要长期做小红书、公众号、知乎、百家号和头条,最大的缺口不是灵感,是时间——查资料、搭结构、写初稿、改平台、核事实,每一步都在吃时间。所以这次我不做「10款AI推荐」,做一场岗位面试:谁适合查资料,谁适合写,谁适合改,最后留下哪3个。
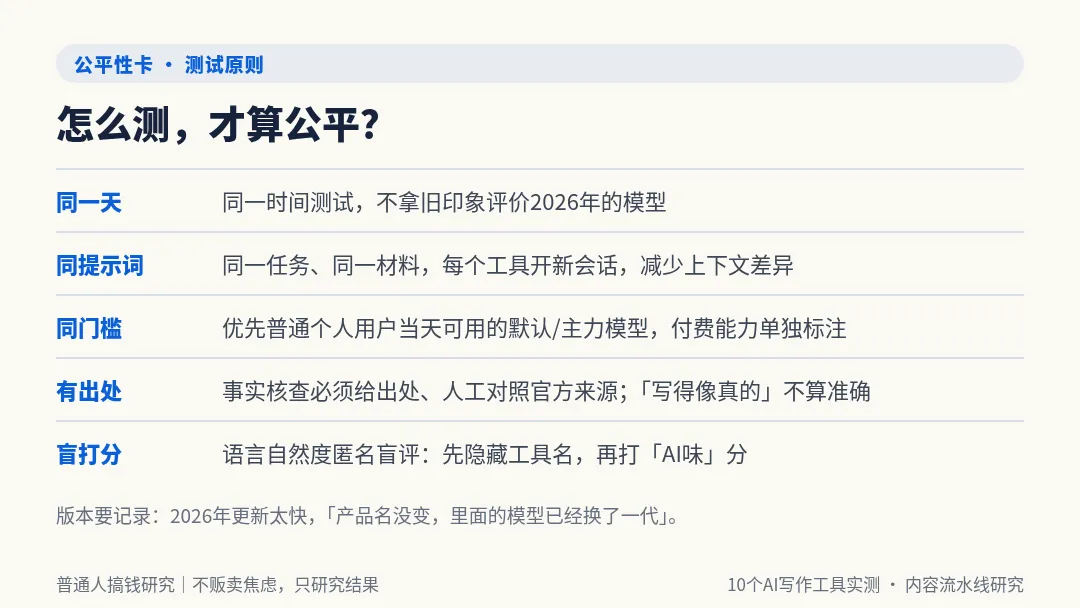
【先交代公平性是怎么定的】出卷之前我干的第一件事不是写题,是核对版本。因为我发现自己一直在拿旧印象说话——比如DeepSeek,我脑子里还是V3时代的样子,去官网一看,9月10日已经发了V4.1-Flash,官方说明带原生多模态,API文档列着1M上下文。差点用几年前的眼光给现在的模型出题,这个坑算是当场填上了。
规则最后定成这样:所有工具同一天开考,同一套提示词、同一份材料,每个工具都开新会话,避免上下文互相污染。付费和免费怎么办?我犹豫了很久,最后决定不混榜:优先用普通个人用户当天能直接用的默认或主力模型,付费能力单独标注。如果你觉得有更公平的处理方式,欢迎在评论区教我。
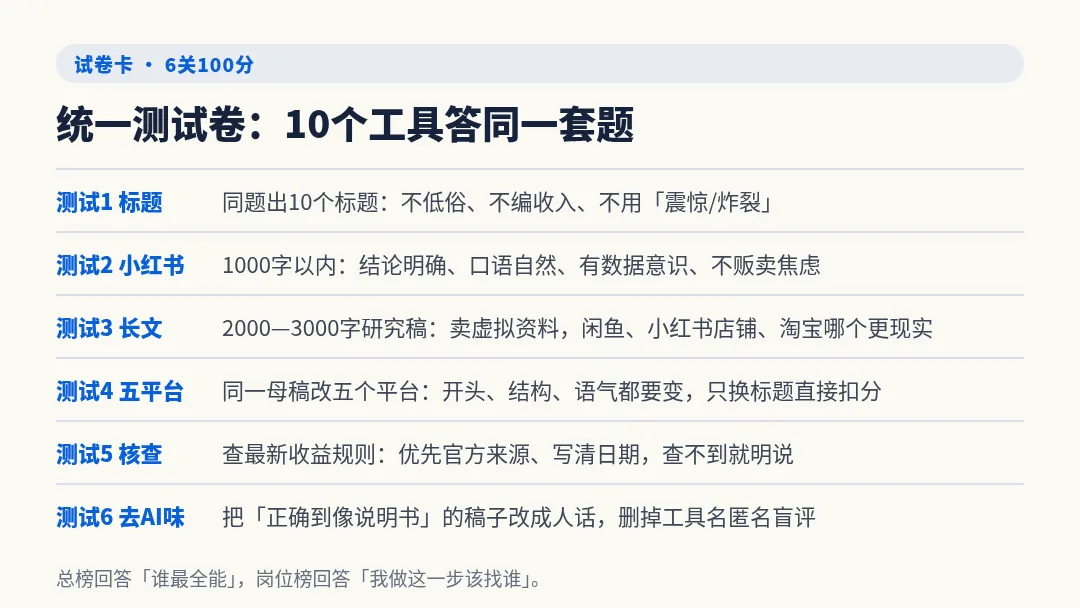
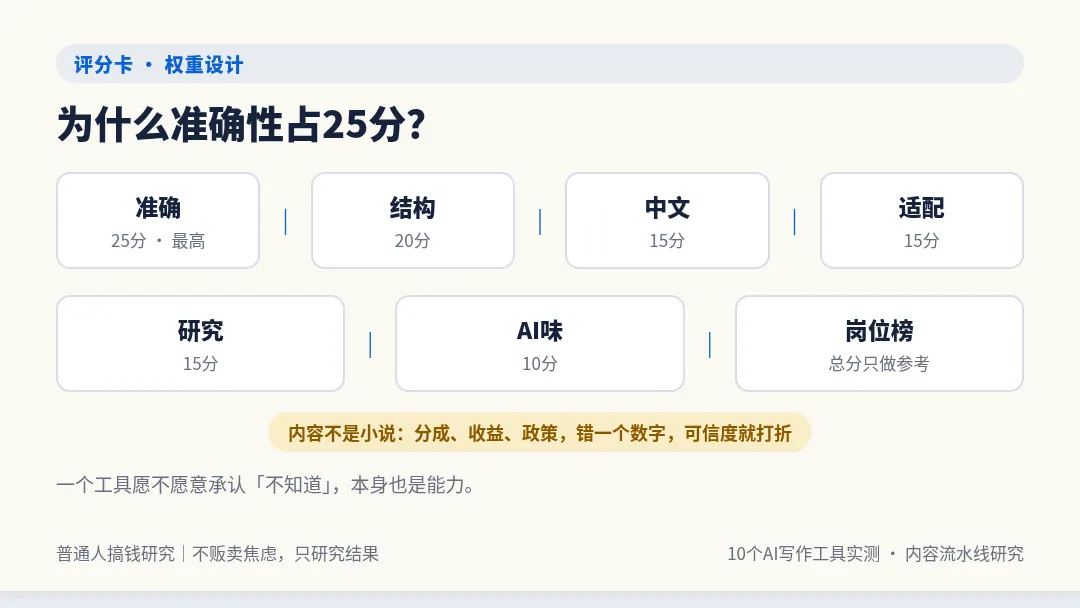
【为什么准确性单独给25分】因为这个账号写的不是小说,是平台分成、作者福利、广告收益和规则。一个关键数字错了,读者不会管句子漂不漂亮。所以事实核查这道题我卡得很死:必须给来源,优先官方,必须看日期,找不到就明说找不到。「不知道」三个字,在这里是能力,不是缺陷。
【我为什么不准备只发一个第一名】还有个问题我到现在也没完全想通:秘塔AI搜索算不算「写作工具」?它是检索型的,让它跟长文模型比作文,赢了不体面,输了更冤。所以最终我会发两张榜:总分榜做参考,岗位榜做答案——查资料找谁、写初稿找谁、改小红书找谁、一稿五平台找谁。对普通人更实际的问题是:不想同时养10个工具,只留3个,哪3个组合最划算。
【我想搭的不是收藏夹,是流水线】研究资料,用最靠谱的研究工具;整理逻辑,用最会处理长文的;写初稿,用综合稳定的;改小红书、知乎,用中文最自然的;最后事实核查,回到来源和人工。AI的价值不是「帮我写一篇」,是把一个人的活拆成几个可重复的岗位。
【实测结果,考完回填】总分榜:Claude 90分第一,腾讯元宝85分第二,DeepSeek和ChatGPT并列83分第三,秘塔AI搜索80分第五,Gemini 77分第六,千问和豆包并列76分第七,文心75分第九,Kimi 46分第十。其中ChatGPT和文心是重测成绩:首测因我这边操作失误被判无效,重测后ChatGPT从52分升到83分,文心从39分升到75分。
【完整评分表】准确25/结构20/中文15/平台15/研究15/AI味10。
Claude:22/19/13/14/14/8=90。
元宝:21/18/11/14/14/7=85。
DeepSeek:20/17/12/13/13/8=83。
GPT:21/17/12/13/13/7=83。
秘塔:21/17/10/12/14/6=80。
Gemini:19/16/11/12/12/7=77。
千问:18/16/11/12/12/7=76。
豆包:18/16/11/12/12/7=76。
文心:18/16/11/12/11/7=75。
Kimi:12/10/10/0/8/6=46。
未完成的任务按0分计:Kimi任务4-6因会员限制缺失。注:GPT与文心为重测成绩,首测因操作失误无效(GPT 52→83,文心 39→75),其余8个工具成绩不变。
【综合写作第一及代表输出】Claude,90分。代表输出:任务4一稿五平台,5个版本结构完全不同——小红书用emoji分段加选项互动结尾,公众号完整叙事加时薪计算,知乎问题拆解体,百家号表格化信息密度,头条短段落快节奏。不是换皮,是真的重写了开头、篇幅、语气和结尾互动方式。
【长文第一及代表输出】Claude。代表输出:任务3研究长文,全文近3000字,最突出的是主动标注了10条「需要核实」,最后给出核实渠道优先级建议:平台官方规则中心 > 官方客服 > 商家后台实际提示 > 其他。是全场唯一在长文里系统标注存疑的工具。
【研究/事实核查第一及代表输出】秘塔AI搜索。代表输出:任务5核查B站创作激励,给出官方规则页URL(bilibili.com/read/cv173108),明确标注页面无更新日期,区分2018年原始规则和当前可能已变更的内容。核查视频号时引用腾讯官方培训资料,标注「优质原创」「符合内容规范」无量化标准。全程引用26个网页来源。
【最意外的翻车点】Kimi从任务4开始要求办会员,不办就不再回答,6道题只完成了3道。另一个测试之外的发现:ChatGPT和文心首测时曾出现跳题和正文空白,我当时以为是工具翻车,重测才发现是我这边的操作失误——重测后ChatGPT 52→83、文心 39→75。给普通人的提醒:给AI下结论之前,先确认测试流程本身没出问题。
【最终留下3个 + 每个负责什么】①Claude——负责综合写作、长文整理、去AI味改稿,是唯一六维无短板的工具;②秘塔AI搜索——负责资料检索、事实核查、来源验证,检索型工具不跟写作工具比作文,但研究岗位全场第一;③DeepSeek——负责日常初稿、中文口语化改写、小红书短文,中文最自然且免费可用。组合逻辑:秘塔查资料 → DeepSeek写初稿 → Claude改长文和去AI味。
【结尾】这篇真正想回答的不是「2026年最强AI是谁」——那个答案几个月就过期。更像是在问:我今天这份具体的活,谁能帮我少花时间、少犯错、少写废话。事实由人核查,观点由人负责,结果由人判断。
如有需要ai测试报告自取。盲评评分报告.pdf
普通人能不能做 · 现在入场值不值得