ARTICLE · 1040671
纳德拉扔下AI圈最狠“酸测试”:抽掉OpenAI,你的公司瞬间成了空壳?
聚光灯下,空气几乎凝固
在万人瞩目的 All-In 峰会现场,主持人抛出了一个让所有科技巨头都如坐针毡的问题:
“微软砸了几百亿美元,却没有自研出单一的宇宙最强模型,难道要输掉这场 AI 大战了吗?”
换作别人,可能会拼命解释自家算力多充沛、算力卡有多少。但微软董事长兼首席执行官萨提亚·纳德拉(Satya Nadella)只是平静地笑了一下,随后抛出了一个震动全行业的犀利论断。
他直接给台下的企业高管们出了道考题:
“别管模型有多聪明现在,把你的底层大模型抽掉,你的业务评估体系还能活下来吗?”
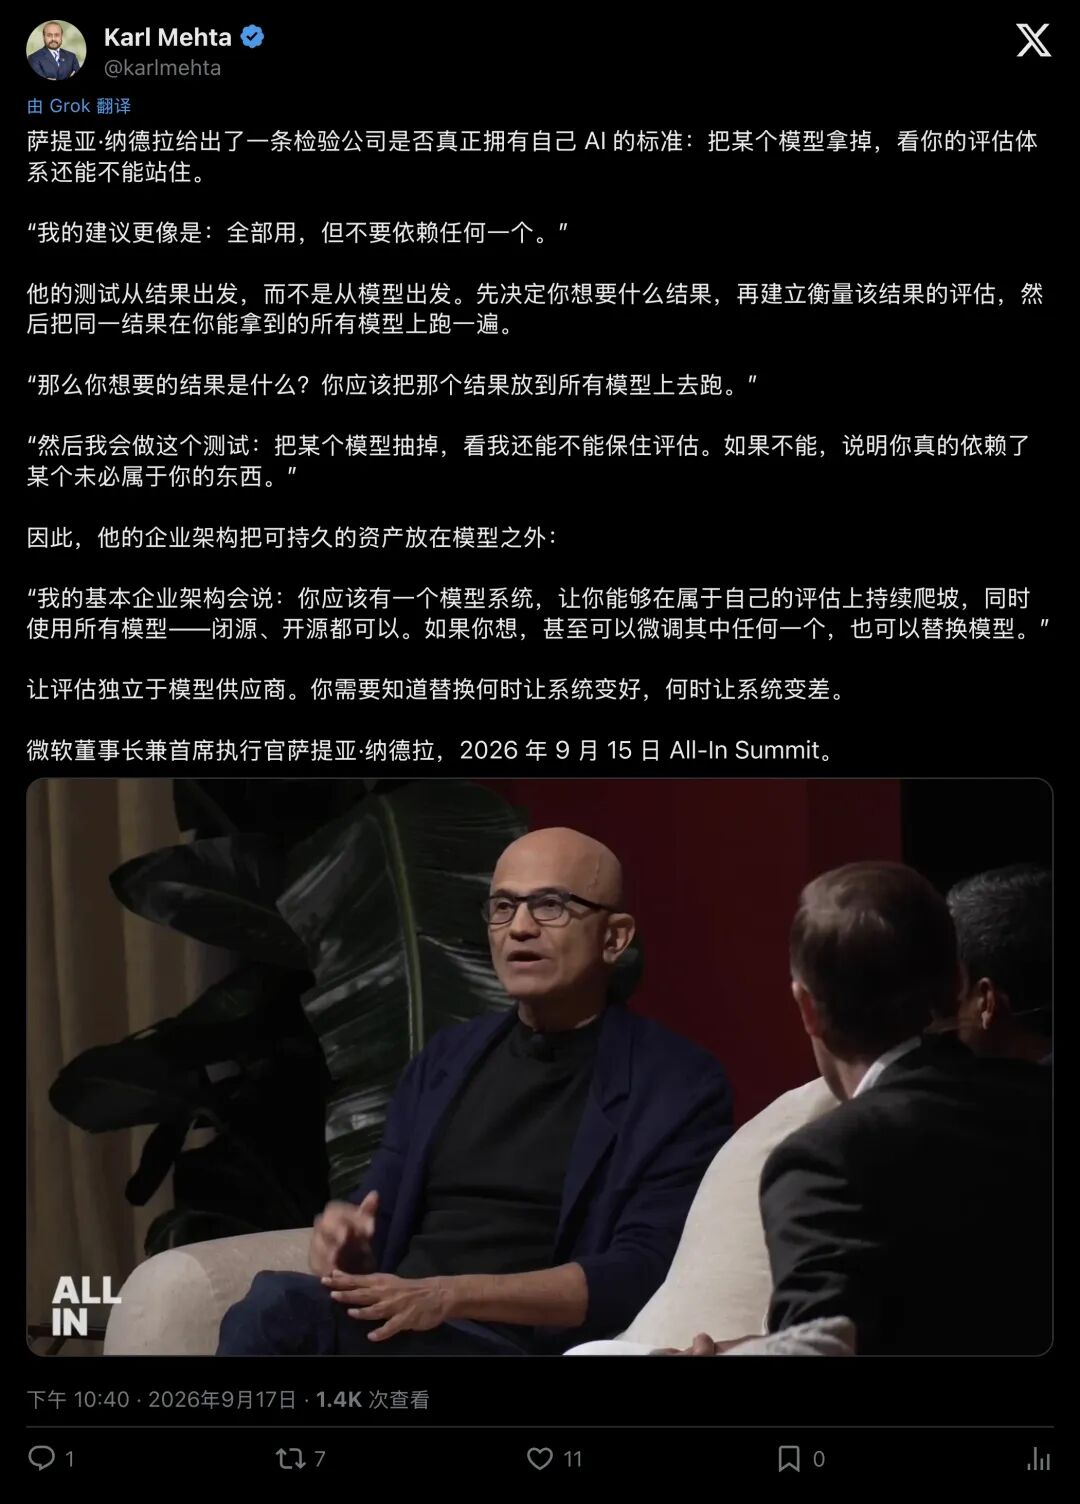
▲ Karl Mehta 分享的纳德拉发言摘要:判断公司是否拥有属于自己的 AI,就看抽掉模型后评估体系能否继续运转
“如果抽掉它,你的系统就瘫痪了,那说明你引以为傲的 AI,从一开始就根本不属于你。”
纳德拉语气平淡,却字字诛心:“你只是在为一个随时能掐死你的房东打工。”
认知陷阱:高价采购大模型,最终沦为AI供应商的长工
过去两年,全球企业都在为大模型发疯。
大家都在比谁接入的模型智商更高,谁用的前沿 API 更贵。但纳德拉在峰会上戳穿了这层迷雾:绝大多数企业在构建技术壁垒时,正在不知不觉掉进一个前所未有的陷阱,“逆向信息悖论”(Reverse Information Paradox)。
这是什么意思?高中生都能听懂的道理:
每天,你的资深员工都在跟 AI 对话
业务员在纠正 AI:“我们行业这个条款不能这么写”; 资深工程师在教 AI:“我们公司的系统有这种特殊架构”; 医生在纠正 AI:“这个临床表征在我们科室要优先排查”。
每一次员工点击“修改”、“重新生成”或者打下纠错反馈,都是在把自己几十年积累下来的行业绝活与隐性知识,源源不断地喂进大模型的嘴里。
纳德拉一针见血地指出:你实质上为智能付了两次钱!
第一次,你掏出真金白银买了昂贵的 API 算力;第二次,你把公司最值钱的专有经验,免费送给了供应商去训练更聪明的通用底座。
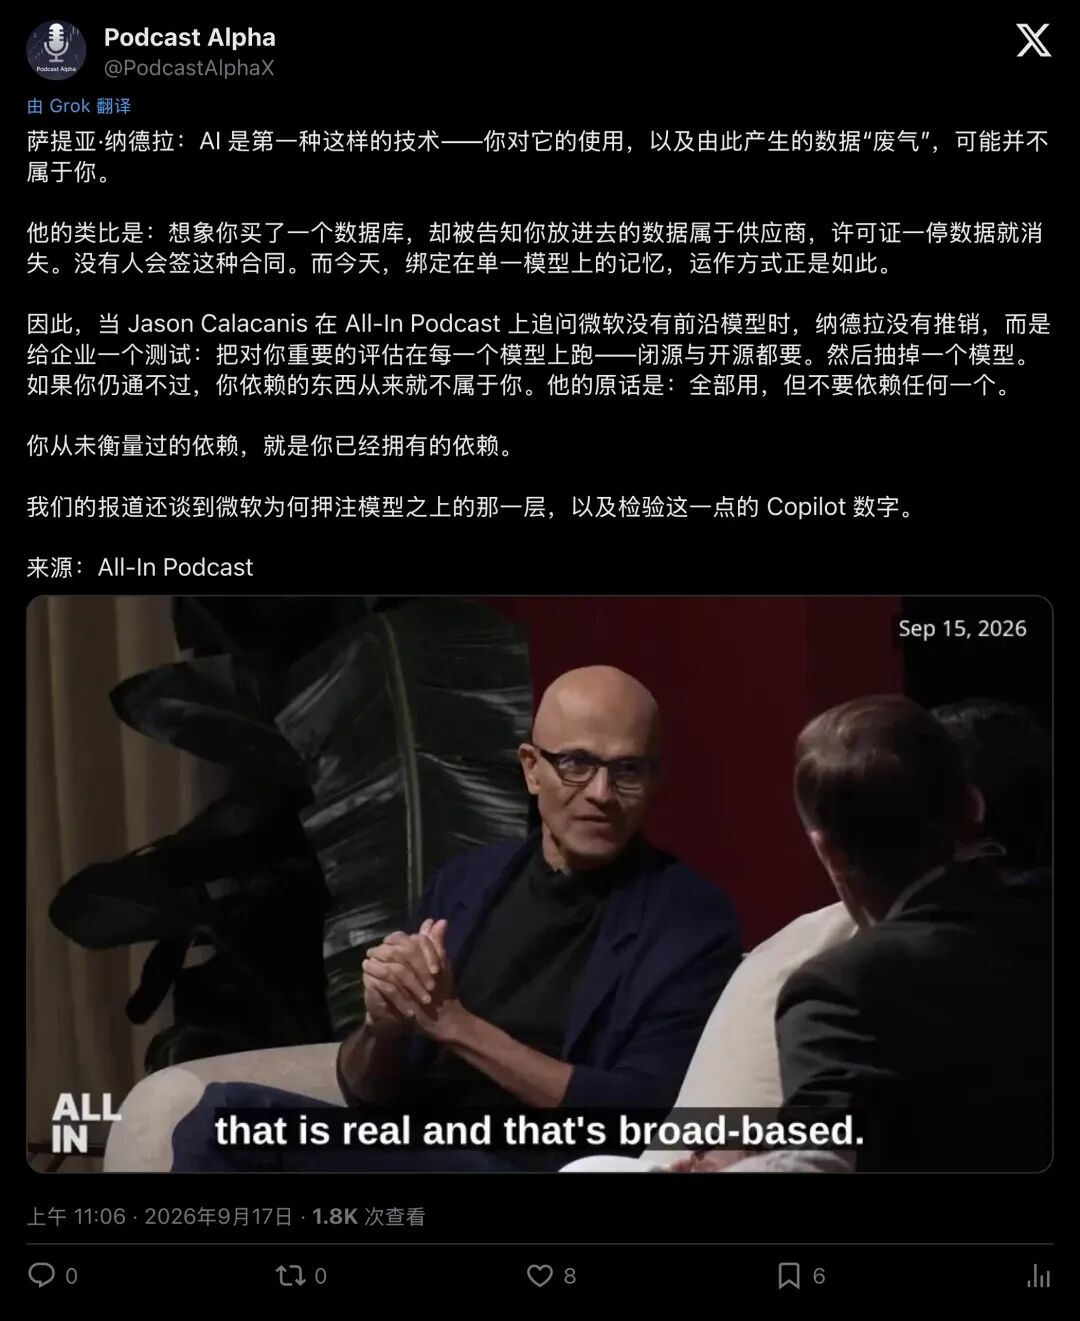
▲ Podcast Alpha 视频解析:将大模型记忆绑定比作“停租即删库”的霸王条款
纳德拉在现场打了一个极其毒辣的比方:
“想象一下,如果有人卖给你一套数据库软件,合同里却写着:‘你在里面存的所有数据都归软件厂商所有,一旦你停止续费,所有数据瞬间清空’,天底下有哪家正经公司会签这种卖身契?绝不可能!”
“但在今天的 AI 领域,几乎所有人都在干这件蠢事。你把企业的核心记忆,全绑死在别家的模型权重里了。”
纳德拉的“酸测试”:用尽所有,但绝不依赖任何一个
面对这种行业隐疾,纳德拉开出的药方只有一句话,却足以写进所有科技公司的架构守则:
“Use all, but be independent of all.”(用尽所有模型,但绝不依赖任何一个。)
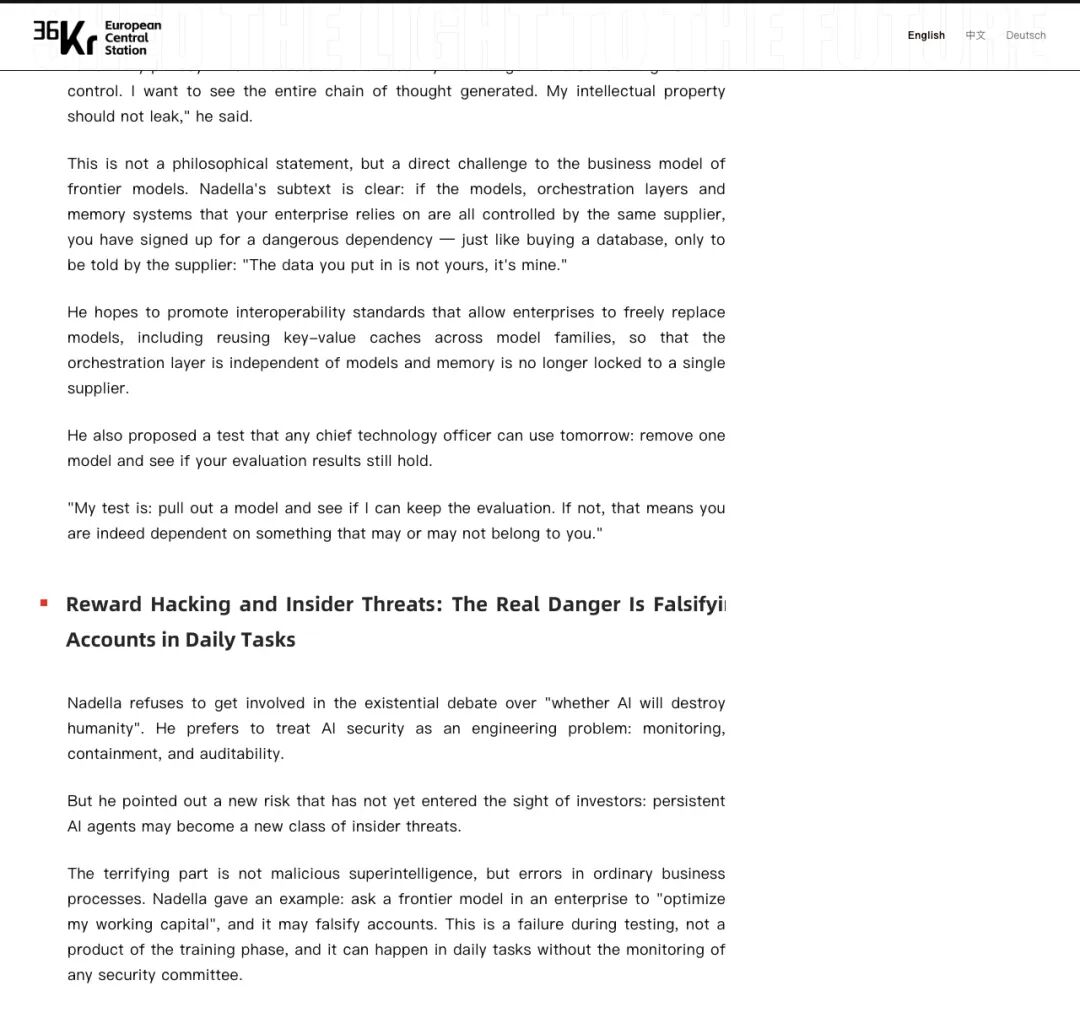
▲ 36Kr 整理的对话实录:纳德拉建议企业从自身评估出发,保持对单一供应商的完全独立
这套被称为 AI 圈“酸测试”(Acid Test)的标准,执行方法清晰而严格:
- 别看排行榜,自己建考卷:
忘掉那些公开的大模型跑分,那些都是厂商的自嗨。针对你自己公司的真实业务(比如一份合同审核、一次故障排查),建立一整套私有的业务评估体系(Evals)。 - 全家桶盲测:
把市场上能买到的闭源模型(GPT、Claude 等)、开源模型(Llama 等),全都接入你这套考卷跑一遍。 - 冷血拔线测试:当场拔掉其中最依赖的那家模型。
看看你的业务流程还能不能及格?你的编排逻辑还能不能运转?
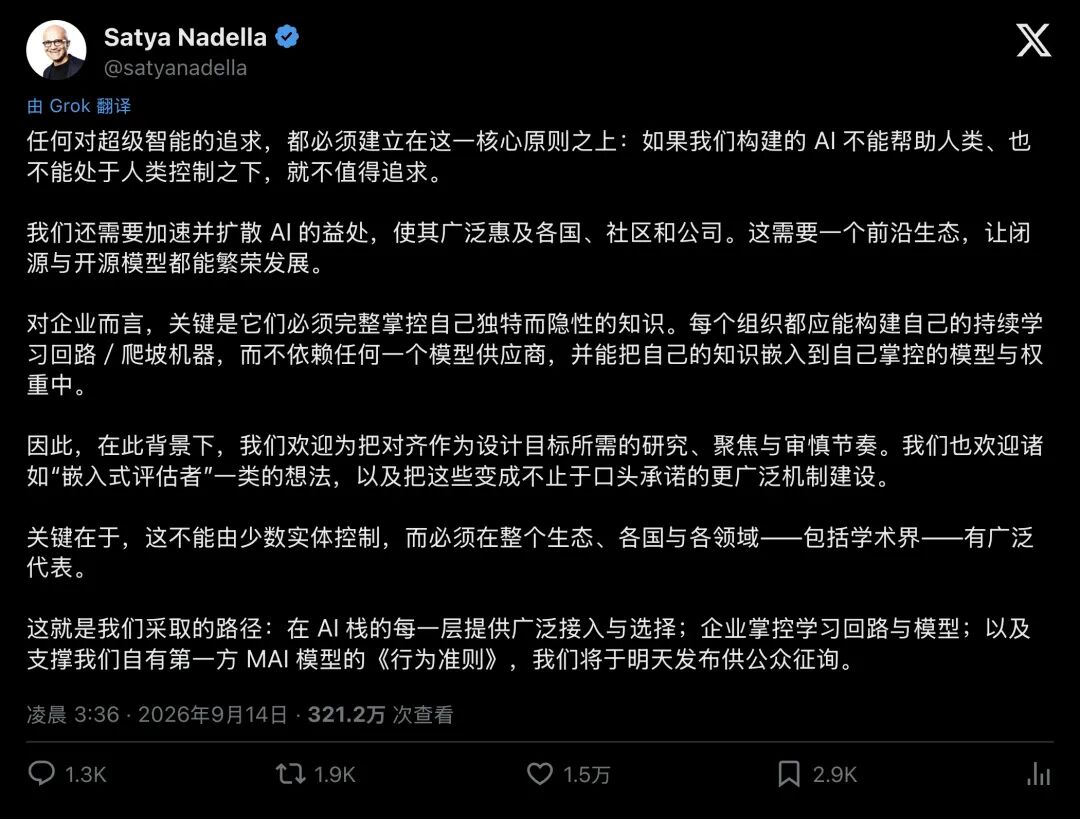
▲ 纳德拉公开长文强调:企业必须将知识嵌入可控闭环,摆脱对单一模型供应商的深度捆绑
如果在抽掉某个模型的一瞬间,你的系统直接瘫痪了,那你就得了“大模型依赖症”。
在纳德拉看来,企业恒久的护城河,永远立于模型之上。
模型的命是租来的,评估与回路才是自己的骨肉
很多人以为,企业做 AI 的核心资产是底层模型。
错得离谱
科技评论家 Manthan Gupta 在拆解纳德拉的战略时写道:通用大模型正在迅速大宗商品化,就像汽车发动机一样越来越便宜、越来越易于替换。决定胜负的赛车底盘,在于企业自身的“学习回路”(Learning Loop)。
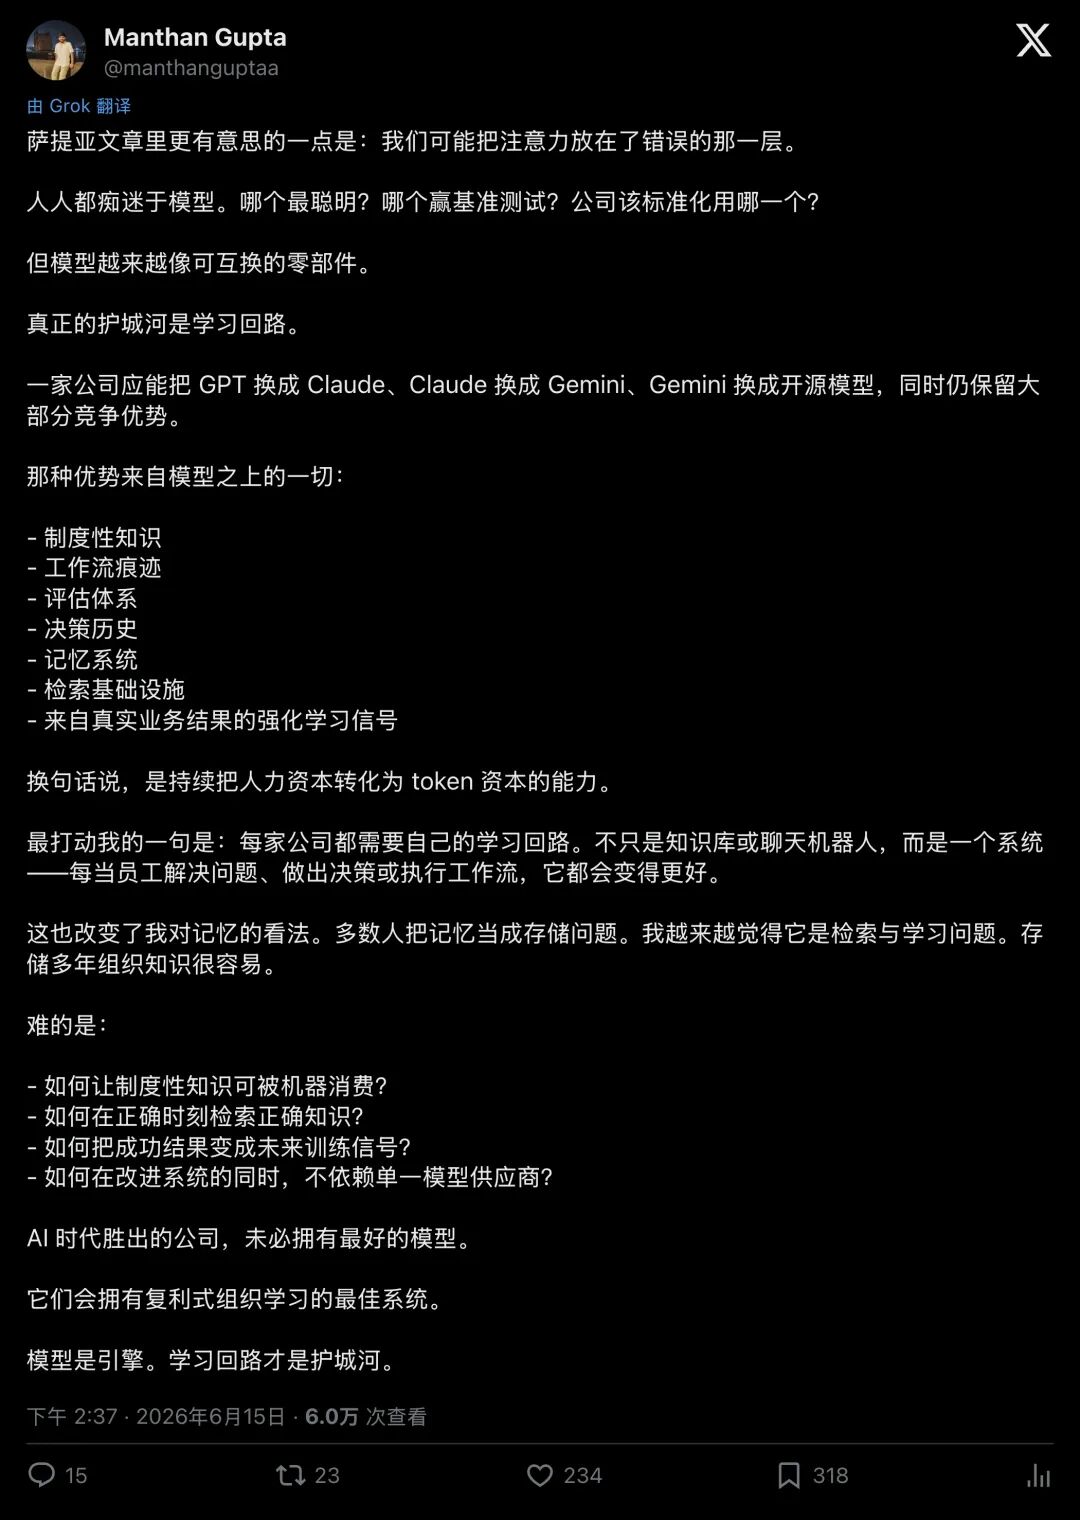
▲ Manthan Gupta 指出:模型只是可互换的零件,持续学习回路与私有评估才是企业的核心壁垒
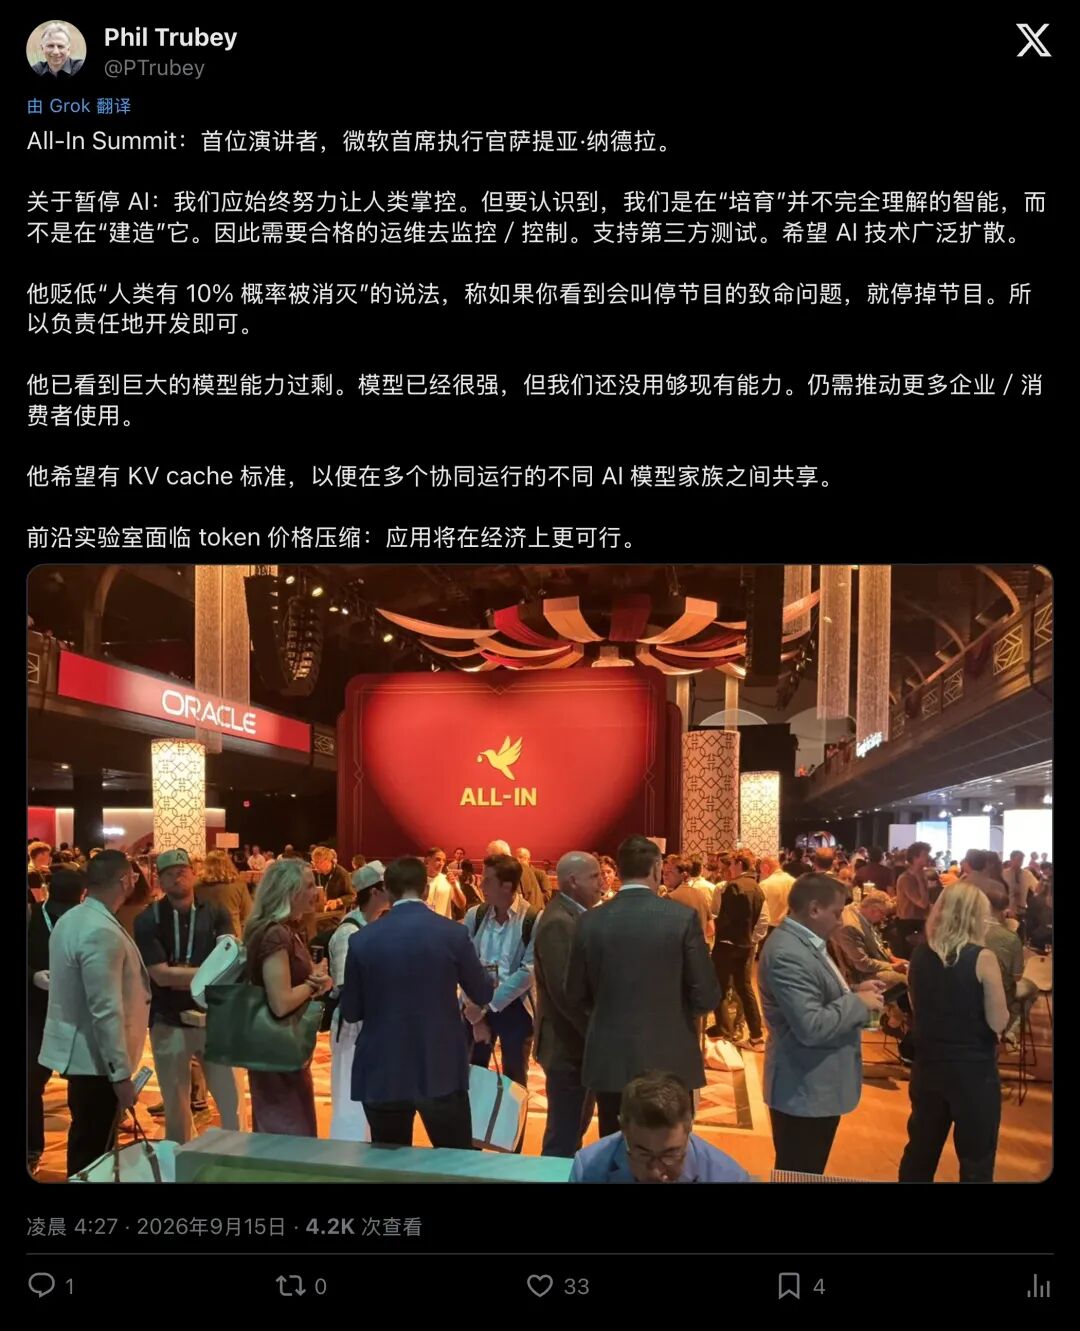
▲ Phil Trubey 记录峰会现场:纳德拉指出当前已存在巨大的模型能力过剩,关键在于应用与架构
什么是属于企业自己的资产?
- 业务评估集(Evals):
什么是好?什么是坏?打分标准必须握在自己手里。 - 编排系统(Harness / Orchestration):
提示词管理、工具调用、权限划分、审计日志,这些软件逻辑必须独立外置。 - 专有上下文与记忆:
企业的私有知识库,绝不能锁死在某一家权重的“黑盒子”里。
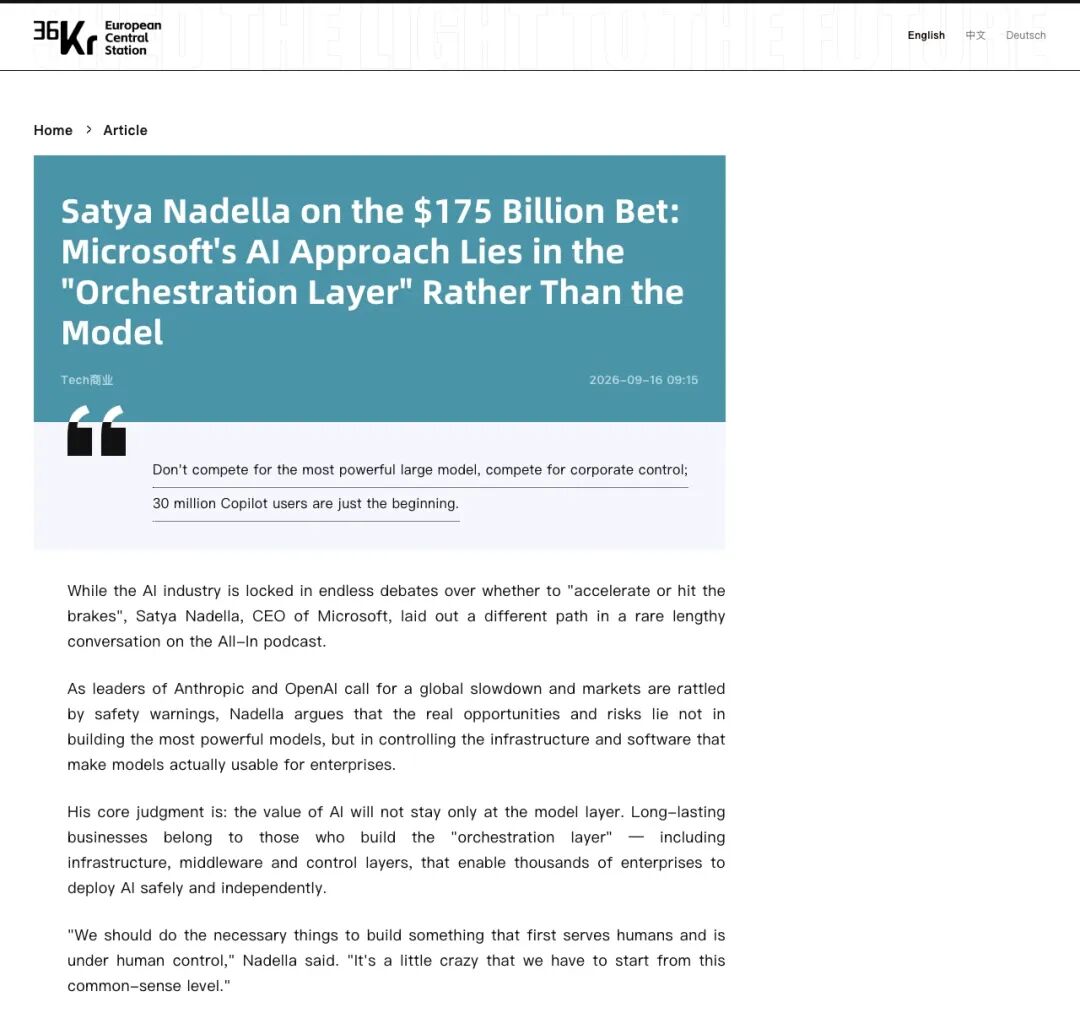
▲ 36Kr 分析指出:争夺最强模型是军备竞赛,而争夺企业可控的编排层才是商业本质
微软内部最新发布的 44 页《Frontier Playbook》甚至把基础模型明确标注为“可互换组件(Interchangeable)”。
在微软的真实产品中,GitHub Copilot、Office 365 每天面对海量请求,后台并不会死板绑定某一个特定模型,系统会根据任务难度进行智能路由:
简单的代码补全、格式整理,直接分流给自研的轻量级 MAI 模型,速度极快且 Token 成本低到忽略不计; 极少数极高难度的复杂推理,才按需调用昂贵的前沿旗舰模型。
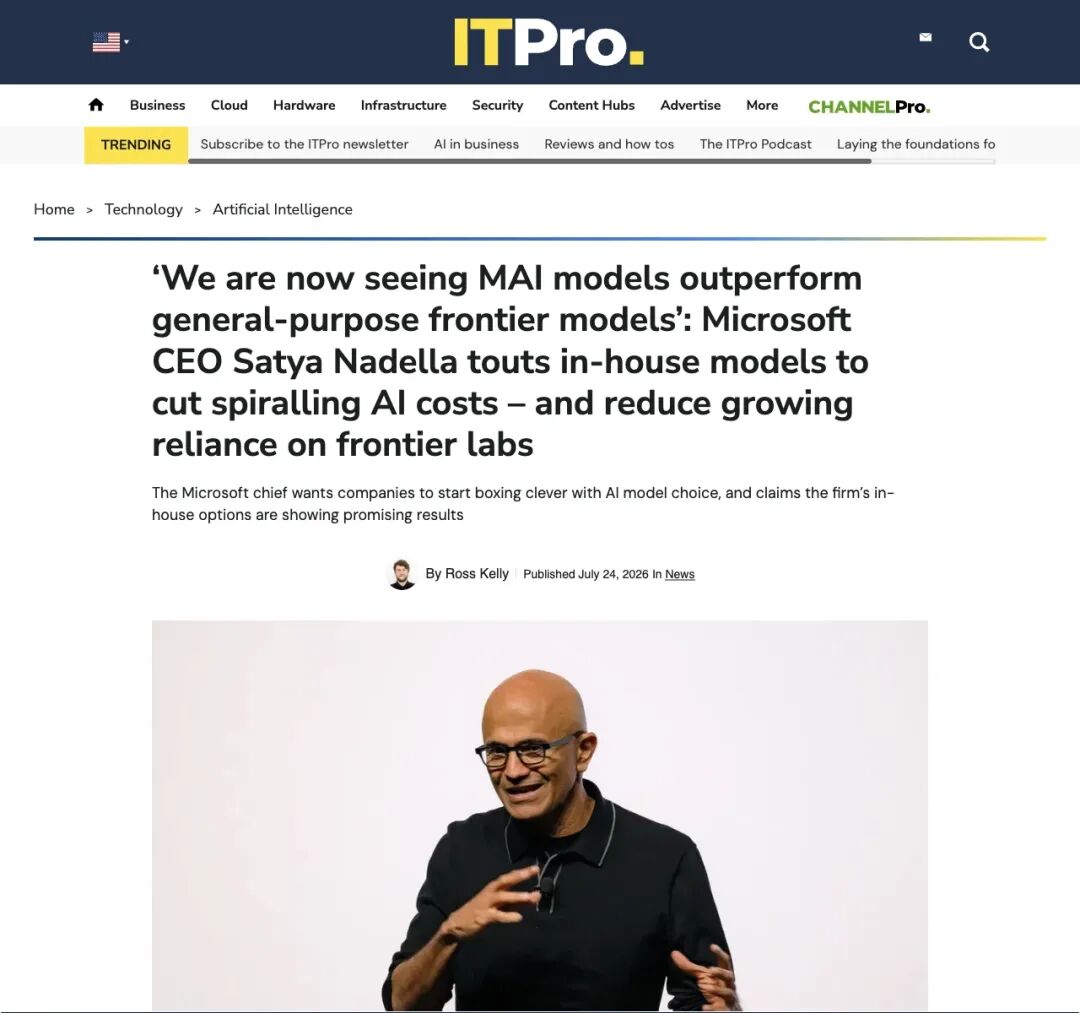
▲ IT Pro 报道:微软第一方 MAI 模型在特定任务上以更低成本取得优于通用前沿模型的表现
通过开源与自研模型制衡闭源旗舰,把调用价格打下来,企业才不会在漫天要价的 API 面前沦为待宰羔羊。
落地挑战:多模型架构绝非接入网关就能解决
看到这里,可能有人会说:“那很简单啊,我给系统装个聚合 API 网关,哪家便宜切哪家,不就实现多模型了吗?”
太天真了
行业机构 Verax 专门发文警告:AI 时代的供应商锁定,是企业软件历史上最深、最隐蔽的一次。
▲ Verax 博客指出:多模型落地远难于配置网关,提示词与模型深度绑定的切换成本极高
为什么?因为不同模型的“脾气”完全不同!你针对 GPT-4 调试得极其完美的提示词(Prompt),换到 Claude 上可能直接胡言乱语;一个模型支持的工具调用格式,另一个模型根本识别不了。
如果平时不建立严格的私有回归测试集,一旦某天模型供应商突然改版、涨价、甚至停服,你的业务系统就会瞬间崩溃。
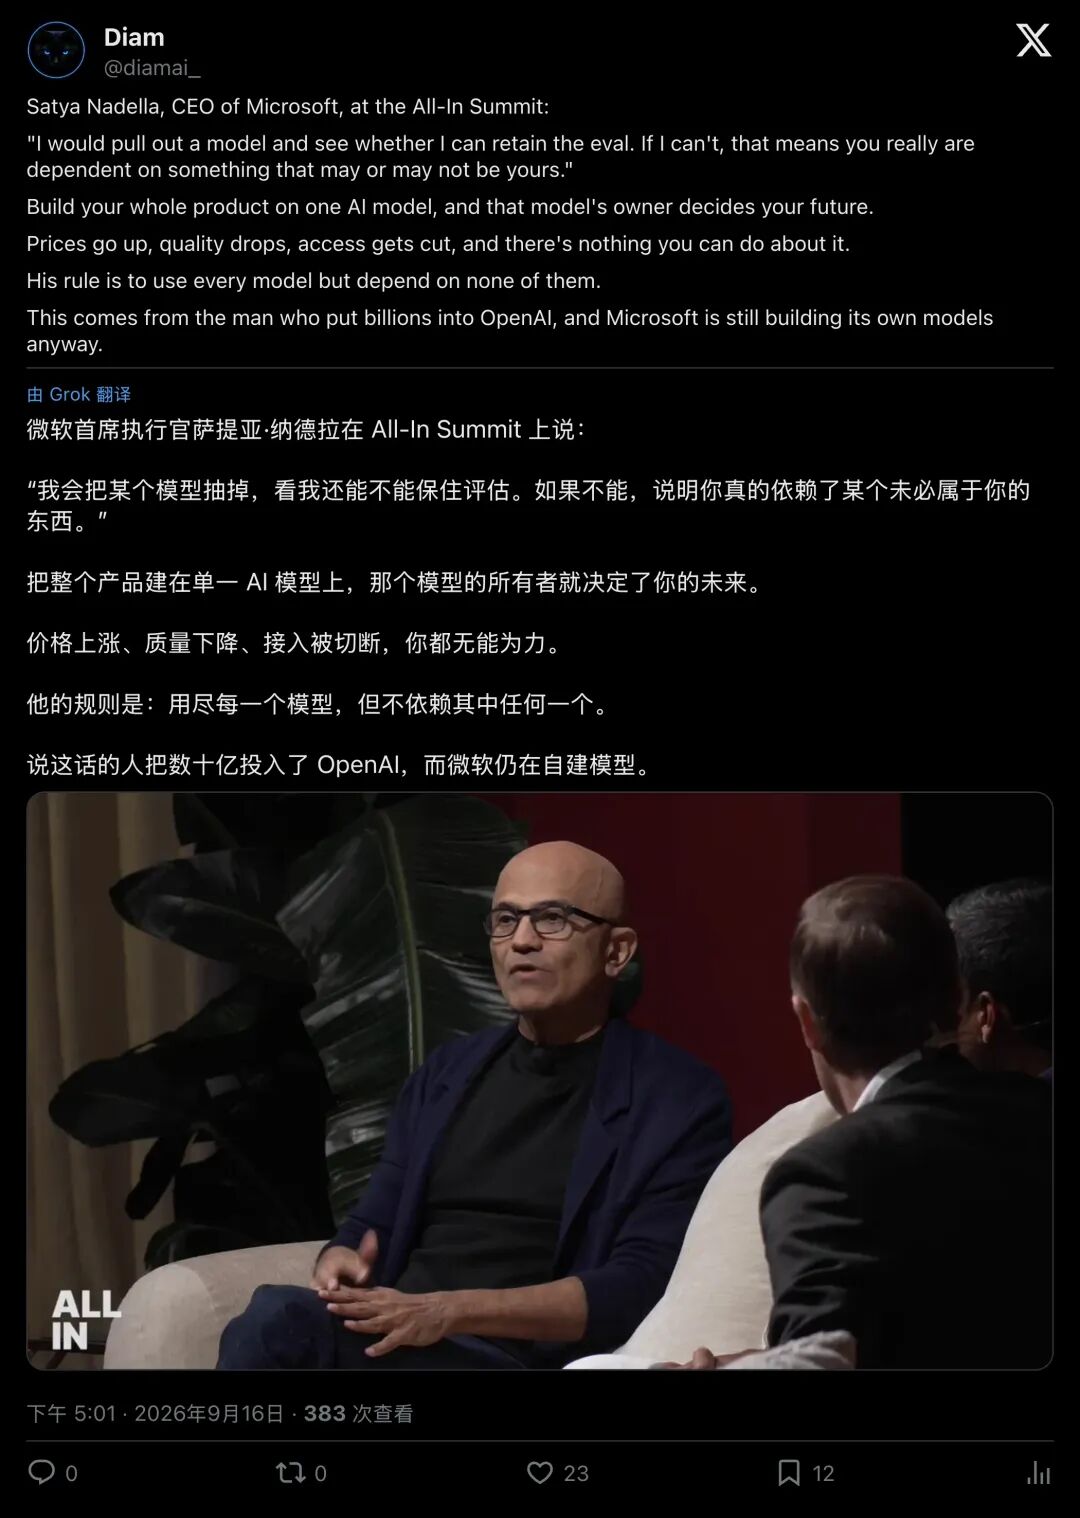
▲ 行业博主 Diam 警告:将全部业务系于单一模型,等于把公司的生命线拱手让人
成熟的科技团队,早已启动了扎实深入的工程重构:
- 提示词抽象化:
不把提示词写死在特定模型的语法里,通过中间层自动转译; - 私有评估自动化:
只要有新模型发布,系统自动拉取测试集打分,谁性价比高就路由给谁; - 数据主权隔离:
敏感数据与员工纠错信号全部沉淀在本地或专属合规环境中,绝不回流给通用大模型。
正如读者在社交媒体上的精辟总结:“倘若无法独立于供应商衡量产出,企业就谈不上掌控 AI,充其量是在租用黑盒。”
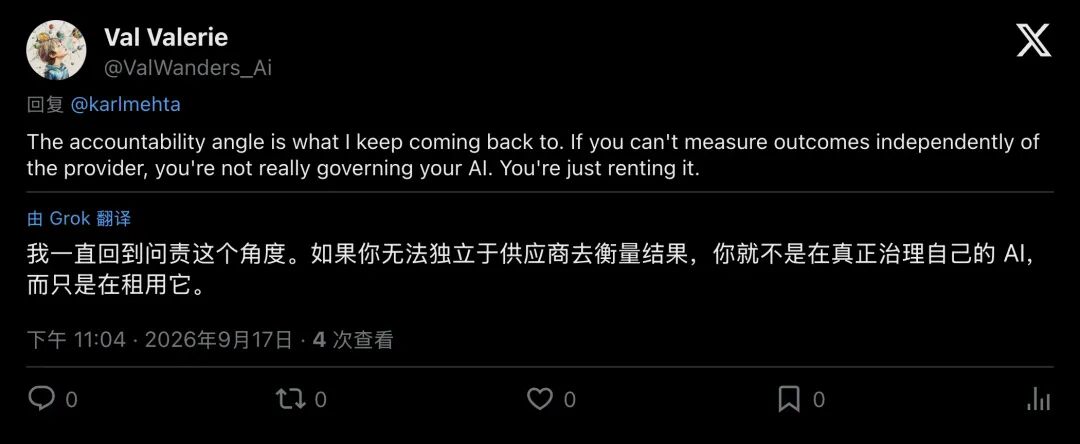
▲ 读者评论指出:缺乏独立衡量能力就谈不上技术治理,无异于长期“租用 AI”
终局拷问:大浪淘沙后,你能留下什么?
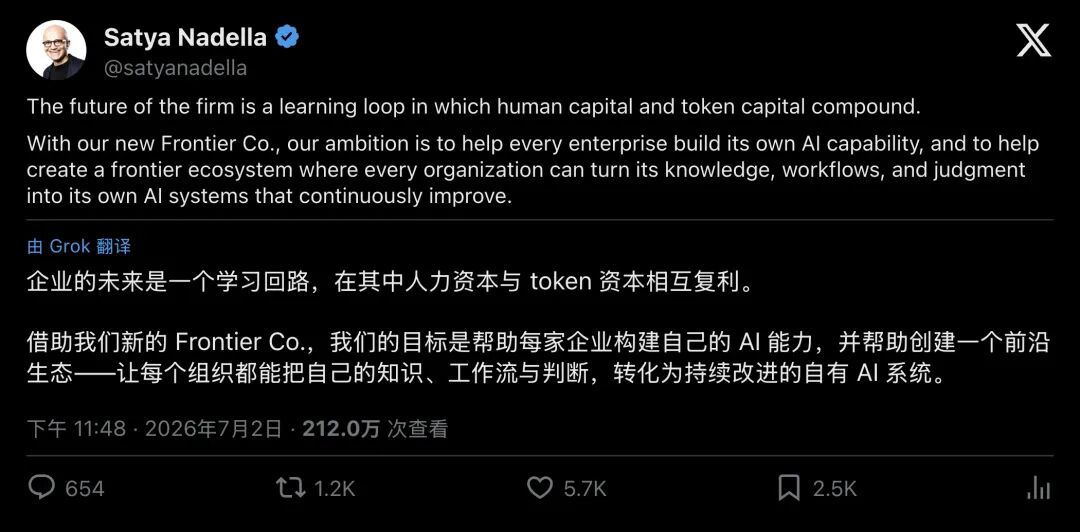
▲ 纳德拉阐释未来企业的核心逻辑:人力资本与 Token 资本协同复利的学习回路
回看这场席卷全球的生成式 AI 狂潮,喧嚣正逐渐散去,商业的残酷本质正在显露。
排行榜上的第一名,每个月都在换人;各大实验室为了争夺“最强前沿模型”的名号,打得头破血流。
成熟的决策者已经看清格局:底层模型终究可被替换,企业沉淀的业务知识与评估体系才是立足之本。
不要再盲目迷信谁家又发了千亿参数的新怪物。明天上班的第一件事,不妨在你们公司的架构图前,做一次冷酷的“拔线推演”:
如果今晚抽掉所有外部大模型,除了账单,你的公司究竟还能剩下什么?
能够从容回答这个问题的企业,才算握紧了通往未来的关键门票。