ARTICLE · 1045361
Nature最新:告别静态PDF!Paper2Agent让科研论文化身交互式AI智能体
过去,论文的主要作用是记录和传播研究成果。研究者阅读论文、理解方法,再根据论文提供的代码和数据进行复现或进一步研究。但对于计算型论文来说,从“读懂”到“真正使用”往往还隔着一道门槛:找到代码、配置环境、安装依赖、理解参数,最后才能运行论文中的方法。
如果AI已经能够阅读论文、理解代码并执行科研任务,那么一个新的问题也随之出现:论文能不能从“可阅读”进一步变成“可交互”?
2026年9月16日,斯坦福大学等机构的研究团队在《Nature》发表论文“Reimagining research papers as interactive and reliable AI agents”,提出了Paper2Agent。
它尝试将论文、代码、数据和分析流程组织起来,把一篇研究转化为一个可以通过自然语言交互、调用研究方法并执行任务的AI智能体。
论文作者将其描述为一种“虚拟通讯作者”。简单来说,过去我们是阅读论文,再自己使用论文中的方法;Paper2Agent尝试让我们直接与论文交互,让论文中的方法参与研究。
Paper2Agent并不是简单地把PDF交给大语言模型。它首先定位论文对应的代码库,再通过多个AI代理完成环境配置、方法提取和自动测试,最终将论文中的研究方法封装为MCP(Model Context Protocol)工具。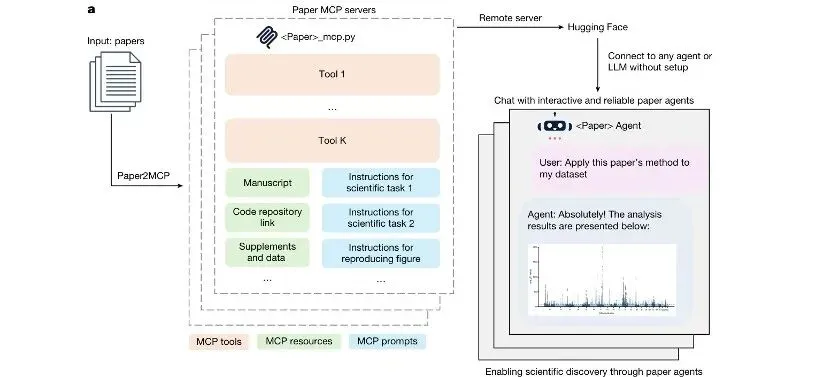
论文Fig.1a|Paper2Agent 的整体架构:论文、代码、数据被封装成MCP 服务器,再接入任意AI 智能体。
整个系统大致包含三部分:
Tools:把论文中的模型、算法和分析函数变成可以直接调用的工具。
Resources:让智能体能够访问论文、补充材料、代码、数据、表格和图形等研究资源。
Prompts:将论文中的多步骤分析流程组织起来,让智能体能够按照相应工作流执行任务。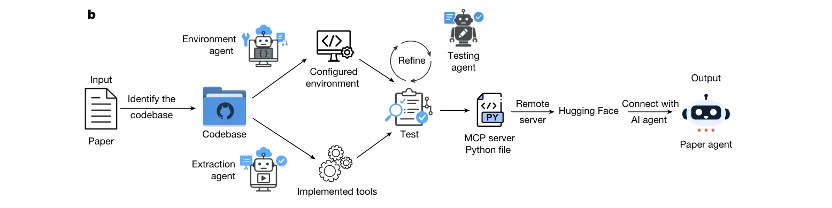
论文Fig.1b|Paper2Agent 的六步流水线:环境、抽取、测试等智能体接力,自动完成从代码库到MCP 服务器的转化。
因此,一篇论文就不再只有一个PDF,而是形成了:
论文内容 + 研究资源 + 可执行工具 + 分析流程
研究者也不一定需要自己操作代码仓库,而可以直接通过自然语言提出问题,让智能体调用论文中的方法。
研究团队首先选择AlphaGenome进行测试,并将其构建成包含22个MCP工具的智能体,整个过程约耗时45分钟、成本14美元,所有工具均通过自动化验证。在测试中,Paper2Agent在15个教程问题上的准确率达到98.7%,在15个全新问题上达到100%。更有意思的是,研究团队还利用生成后的智能体重新分析了一个与低密度脂蛋白胆固醇相关的GWAS位点。
原论文重点讨论了CELSR2和PSRC1,而Paper2Agent调用AlphaGenome后将SORT1排在了更靠前的位置,并进一步结合GTEx eQTL等证据进行比较。
这并不意味着AI“纠正”了原论文,而是说明了一种新的研究方式:
发表之后,论文中的模型仍然可以被再次调用,用于重新分析和检验已有研究。
论文因此从一个记录研究结果的文件,变成了一个可以继续参与研究的工具。
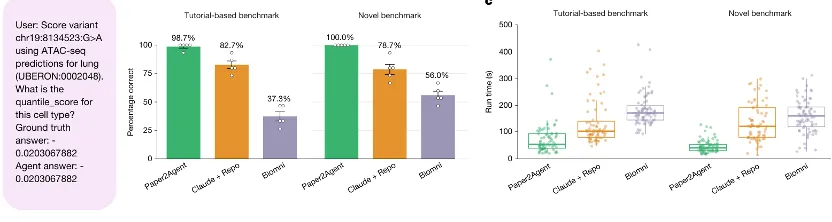
论文Fig.2b,c|AlphaGenome 智能体的准确率与耗时对比,教程问题和全新问题均明显领先。
在Scanpy案例中,研究团队构建了7个工具,覆盖质量控制、标准化、特征选择、降维、聚类等分析步骤。研究者只需要提供数据路径,智能体便可以按照相应流程完成分析。
在多个公开单细胞数据集上的测试中,智能体得到的细胞数量、基因数量以及主要差异表达标志基因等结果,与人工执行分析得到的结果相匹配。
也就是说,论文不只是告诉你:“我们是这样分析的。”
而是可以进一步变成:“把你的数据给我,我按照这套方法帮你分析。”
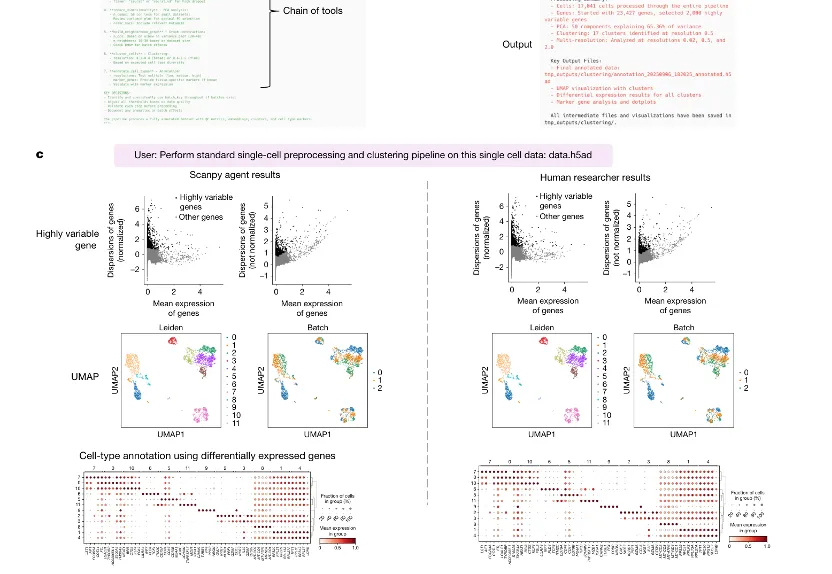
论文Fig.3c|Scanpy 智能体只用数据路径作为输入,就能完成整套单细胞分析,结果与人类研究者一致。
Paper2Agent更进一步展示了多个论文智能体协作的可能性。
在一个与银屑病相关遗传变异的研究任务中,研究团队同时调用了AlphaGenome以及另外两个实验研究的论文智能体。不同智能体分别提供模型预测、基因扰动实验和Perturb-seq数据。AI智能体提出验证策略,研究者选择其中一种方法,对不同研究中的数据进行整合分析。
最终结果为GPR137作为候选因果基因提供了进一步支持。
这意味着,论文智能体的意义可能不只是“一篇论文一个AI助手”。更进一步,它可能让:一篇论文调用另一篇论文的方法。
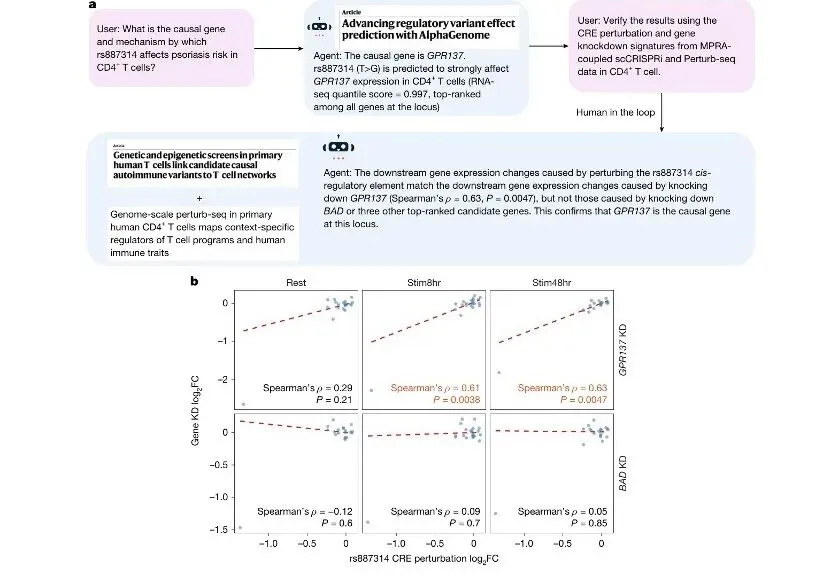
论文Fig.4|三个论文智能体协作,为银屑病变异rs887314 锁定GPR137,并通过独立数据验证。
不同研究中的数据、模型和分析流程,也因此有机会进入同一个科研工作流。
研究团队还对100篇计算生物学论文进行了测试,其中74篇成功完成智能体转换,共生成599个候选工具,593个通过自动化验证。但并不是所有论文都能顺利实现这一过程。代码缺失、数据不完整、环境无法复现以及脚本缺乏通用性,都会成为论文“智能体化”的障碍。
这也说明,Paper2Agent并不是简单地让AI“读懂论文”,而是在推动一个更具体的方向:
让科研成果本身具备被机器调用和执行的能力。
于是,一个关于未来论文的问题也开始变得具体起来。
传统的计算研究成果,大致可以理解为:
PDF + Code + Data
而Paper2Agent展示了一种新的可能:
PDF + Code + Data + Agent
PDF负责向人类解释研究发现和研究逻辑;Code和Data让研究能够被复现;而Agent则成为一个新的交互入口——研究者可以直接向它提问、调用其中的方法,甚至让它执行完整的分析流程。
如果这一方向继续发展,未来我们面对一篇论文时,可能不只是:“这篇论文讲了什么?”
还可以直接问:“把这篇论文的方法应用到我的数据上,会得到什么结果?”
甚至可以进一步:“把这篇论文和另外两篇论文的方法结合起来,能不能解决我的研究问题?”
这意味着论文可能从“被阅读的知识”,逐渐成为“可以被交互的研究对象”。
当然,这并不意味着AI可以替代研究者。Paper2Agent的自动化测试能够提高工具执行的可靠性,但不能保证原始研究本身没有问题,也不能替研究者完成科学假设、研究方向和最终证据判断。
所以,Paper2Agent真正提出的并不是“AI将取代论文”,而是另一种可能:
论文仍然可以是PDF,但它不必只是PDF。
未来的科研成果,或许既可以被人阅读,也可以被AI调用;既可以被引用,也可以被执行;甚至可以与其他论文直接协作。
而这或许就是AI时代“论文可交互”的真正含义。
原文链接:
https://www.nature.com/articles/s41586-026-11044-y