ARTICLE · 1045782
把PDF、Word、PPT变成AI真正看得懂的数据 | GitHub今日值得看 #032
把PDF、Word、PPT变成AI真正看得懂的数据 | GitHub今日值得看 #032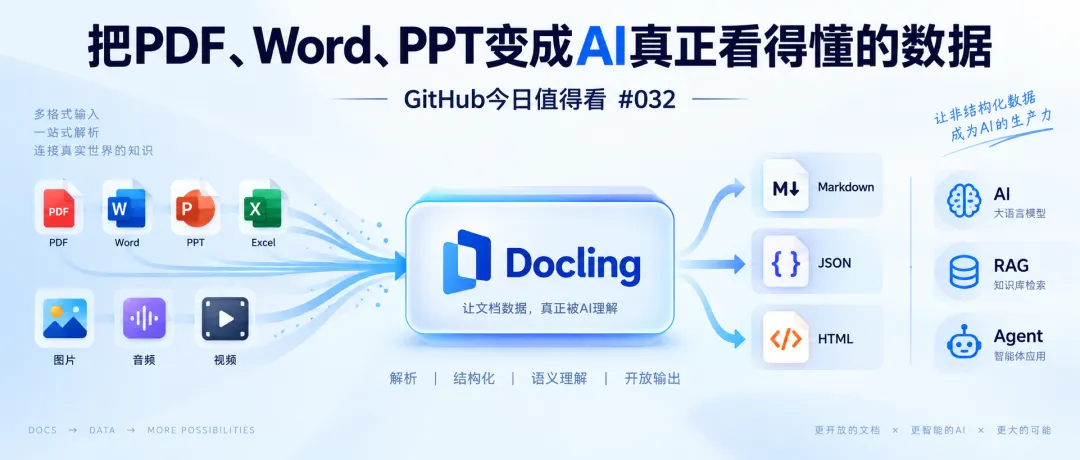
拿到一篇论文、一份 Word 或 PPT,直接扔给 AI,让它总结内容、提取重点、回答问题,已经是很常见的用法。 不过,处理论文、技术报告或几十页的复杂文档时,你可能遇到过这些情况:表格读乱了,双栏论文的段落顺序错了,公式丢了,图片和图注对不上。碰到扫描版 PDF,有时连文字都提取不出来。 这些问题可能出在文档解析阶段。AI 开始理解内容之前,拿到的数据就已经乱了。 今天介绍的 Docling,可以先把 PDF、Word、PPT、Excel、图片和音视频整理成结构化数据,再交给 AI 处理。 Docling 是一个开源文档解析工具,最初由 IBM Research Zurich 的 AI for knowledge 团队发起,目前是 LF AI & Data Foundation 旗下项目。 它负责把复杂文件整理成便于 AI 继续处理的数据,本身不提供聊天机器人或完整知识库的功能。 一篇 PDF 可能有标题、正文、表格、公式、图片和图注,还夹着页眉页脚,采用多栏排版。Docling 会尝试识别这些内容及其结构关系,再导出结果: 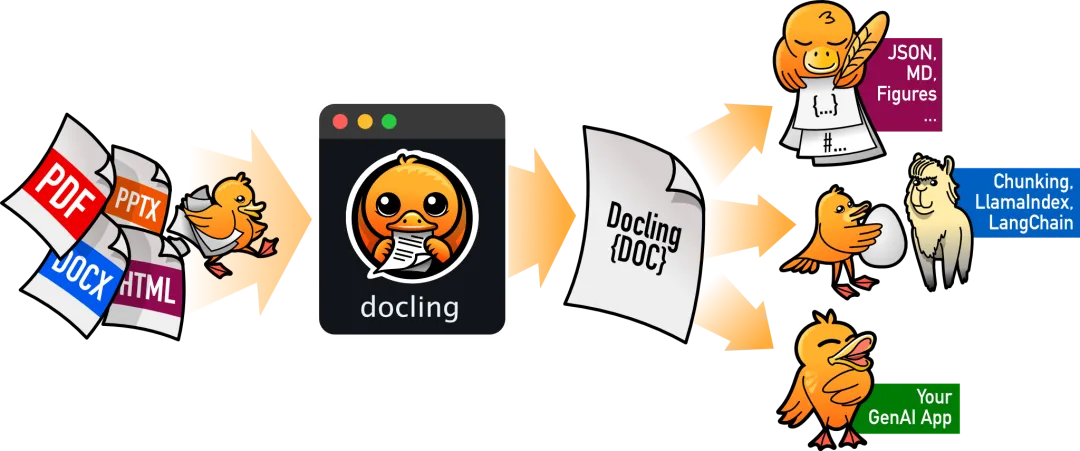
如果 PDF 只有一列文字、几个标题,没有复杂表格和公式,很多 AI 已经能处理得很好。 论文的情况往往复杂一些。同一篇文档里,可能既有双栏排版和跨页表格,也有数学公式、图片和图注、代码块、参考文献、页眉页脚,甚至混着扫描页面。解析工具需要处理这些内容的顺序和关系。 比如,一篇双栏论文原本应该这样读: 如果单纯按页面坐标提取文字,结果可能变成: 文字都在,阅读顺序却乱了。 表格也有类似的问题。原本行列关系很清楚: 提取后却可能变成: 字符一个没少,行列结构却丢了。后续模型只能基于这样的输入理解内容,结果自然会受影响。Docling 要处理的,就是文件交给 AI 之前的这些解析问题。 普通的 PDF 转 TXT 主要提取字符,Docling 还会尝试恢复文档的组织方式。 它会识别页面上的标题、正文、列表、表格、图片、代码和公式,把不同类型的内容区分开。对于双栏、三栏论文或复杂报告,它也会尝试恢复阅读顺序,让导出的 Markdown 尽量保留标题、段落、表格和图注之间的逻辑关系。 表格处理关注的是行、列和单元格之间的对应关系。实验结果、财务数据、参数表和性能对比都依赖这些关系,单靠 OCR 或复制粘贴,容易得到一串散乱的数字。 数学公式和代码也需要单独识别,方便后续 AI 按对应的内容类型处理,避免把它们当成普通正文。 Docling 还能识别图片类型,并支持进一步的图表理解。目前已经开始支持柱状图、饼图、折线图等图表,将其中的信息转成表格、代码或文字描述。 对于没有可复制文字的扫描版 PDF 和图片,它可以通过 OCR 提取文字,再进入统一的解析流程。 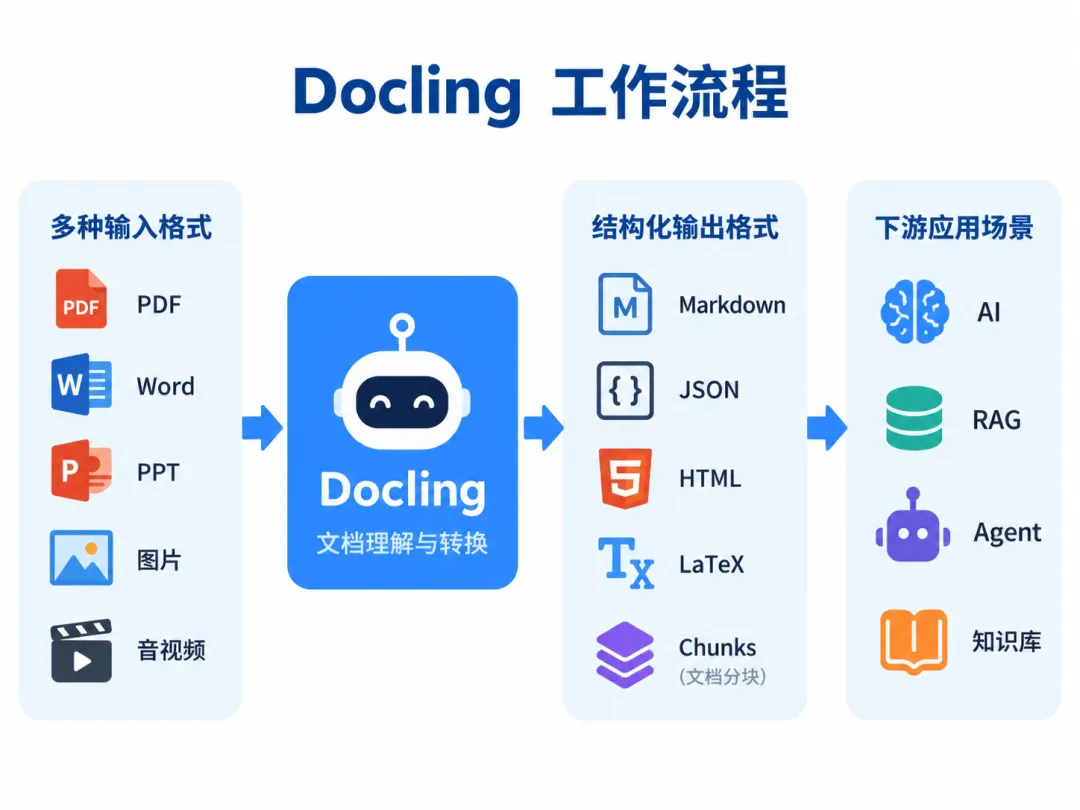
假设下载了一篇 20 页的机器人论文,想放进自己的文献知识库。一个常见做法是: 这套流程能运行,但如果第一步就解析错了,后面的切分、检索和回答都会受到影响。 接入 Docling 后,可以先恢复文档结构,再切分内容: 比如,实验表格属于“4.2 Experiment Results”,图片有对应的 Figure Caption,某个公式属于模型定义。保留这些上下文,有助于后续的总结、问答和检索,也能改善知识库的使用效果。 安装后,用一条命令就能处理本地论文: 也可以传入在线论文的地址: 默认即可得到结构化文档结果。即使暂时不搭建 AI 系统,也可以直接用它把 PDF 转成 Markdown,同时利用它对布局和内容结构的识别能力。 Docling 支持的输入大致可以分成四类: * 办公文件:PDF、Word / DOCX、PowerPoint / PPTX、Excel / XLSX、OpenDocument。 * 网页和出版物:HTML、Markdown、LaTeX、EPUB、Apple Pages。 * 图片:PNG、JPEG、TIFF 等,可配合 OCR 处理扫描资料和图片文档。 * 音频和视频:支持音频 ASR,也增加了视频处理能力。 这样,公司里的 Word、PPT、Excel,以及电子书、网页资料和论文源码,都可以进入同一套处理流程。 以 MP4 为例,处理过程包括: 从这些支持范围来看,Docling 正逐渐成为 AI 系统前面的内容预处理工具,用来统一整理文档、图片和音视频。 Docling 可以与 LangChain、LlamaIndex、Haystack、CrewAI 等工具配合,把整理好的内容送入后续 AI 工作流。 例如,企业知识库可以采用这样的流程: 其中,Docling 负责最前面的文档解析和准备。 它还提供 MCP Server,支持 MCP 的 AI Agent 可以将它作为工具调用。例如,用户提出: > “帮我把这个目录里的所有论文整理成 Markdown。” Agent 就可以按这样的流程处理: 后续还可以让 Agent 进一步分析: > “找出这些论文中所有机器人的实验平台、数据规模和精度结果。” 在这个分工里,Agent 负责推理和执行任务,Docling 负责把原始文件整理成适合继续处理的数据。我更愿意把它叫作 AI 的文档预处理器。 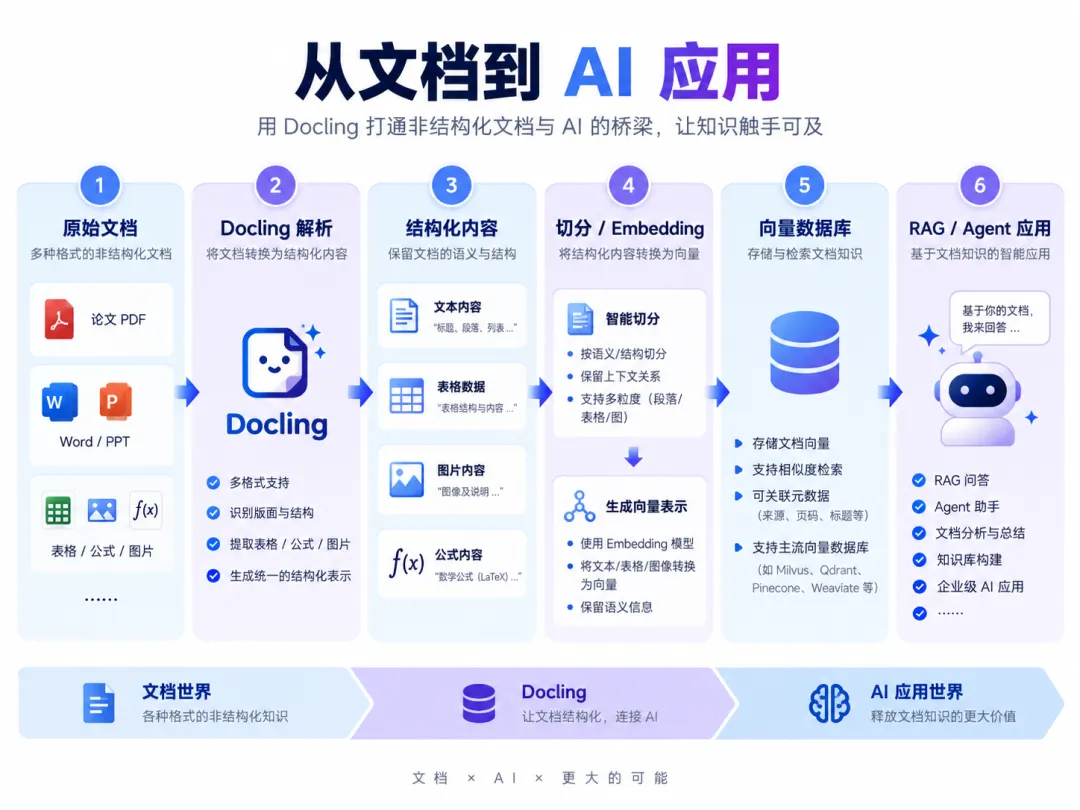
需要 Python 3.10 或更高版本,然后安装: 安装完成后,可以转换 PDF: 也可以转换 Word 文件: 或者直接处理 URL: 在 Python 项目中调用的示例: 拿到结果后,可以保存为 Markdown、转成 JSON,也可以继续做 Chunking,接入 RAG 或交给 Agent。 Docling 支持 Windows、macOS 和 Linux,可以在本地运行。企业内部资料、尚未公开的论文、项目技术文件和敏感数据,可能不适合上传到第三方在线服务;需要在内网或私有环境中处理这些资料时,本地运行就很有用。 如果你需要批量解析论文、建立文献知识库,或者搭建 RAG,把 Word、PDF、PPT 统一整理成结构化内容,Docling 值得试试。开发需要读取复杂文件的 Agent、为扫描文档做 OCR 和结构恢复,以及在本地整理大量企业资料,也都是它适合的场景。 如果只是一个月偶尔上传一篇十页 PDF 给 ChatGPT 做总结,直接使用成熟的多模态 AI 通常就够了,没有必要专门部署 Docling。 我会在需要批量、自动化处理复杂文档,并把结果接入知识库或 Agent 工作流时考虑它。 Docling 采用 MIT License 开源。目前项目已有 6.7 万+ GitHub Stars,仍在持续更新。 * GitHub:https://github.com/docling-project/docling 我们挑选模型时,经常比较它们的能力、上下文长度和回答论文问题的准确度。处理复杂文档时,输入数据的质量也会影响结果。表格、公式、阅读顺序以及图片和图注的对应关系,都值得在解析后检查一遍。 这个系列会继续每天挑一个值得看的开源项目。如果你也关注 AI Agent、科研工具、知识库,以及能改善 AI 使用效果的工具,欢迎关注“GitHub今日值得看”。
01 Docling 是什么?
textPDF / Word / PPT / Excel / 图片↓Docling↓标题 / 正文 / 表格 / 公式 / 图片 / 阅读顺序↓Markdown / HTML / JSON↓AI / RAG / Agent
图:Docling 官方 docling_processing.png
02 直接把 PDF 发给 AI,会有什么问题?
左栏第1段第2段第3段↓右栏第1段第2段第3段
左栏第1段右栏第1段左栏第2段右栏第2段……
模型AccuracyF1A 92.191.6B 94.393.8
模型AccuracyF1A92.191.6B94.393.8
03 它会识别哪些内容?
图:Docling工作流
04 用它处理一篇论文
↓直接提取文字↓切成很多 Chunk↓向量数据库↓RAG
论文 PDF↓识别页面布局↓确定阅读顺序↓恢复标题 / 正文 / 表格 / 公式 / 图片↓建立统一的 DoclingDocument↓输出 Markdown / JSON↓再进行 Chunking↓进入 RAG / Agent
```bashdocling paper.pdf```
```bashdocling https://arxiv.org/pdf/2206.01062```
05 支持哪些文件?
```text视频↓提取音频↓ASR 转录↓提取代表性关键帧↓整理成可以继续处理的内容```
06 怎么接入 RAG 和 Agent?
```textPDF / Word / PPT↓Docling↓结构化内容↓Chunking↓Embedding↓向量数据库↓RAG↓大模型回答```
```text扫描文件↓调用 Docling↓解析 PDF↓得到结构化内容↓继续总结 / 分类 / 建知识库```
图:从文档到AI应用
07 安装和使用
```bashpip install docling```
```bashdocling paper.pdf```
```bashdocling report.docx```
```bashdocling https://arxiv.org/pdf/2206.01062```
```pythonfrom docling.document_converter import DocumentConverterconverter = DocumentConverter()result = converter.convert("paper.pdf")print(result.document.export_to_markdown())```