ARTICLE · 1047245
TypeSafe AI最新模型Jev创始人演讲实录: 为什么RLCD优于RLHF
节目信息
来源: AI Engineer演讲视频
导语
RLHF 让模型更会回应人,却未必让它更能独立把事情做对。Diogo Almeida 从“辅助”与“自动化”的目标差异切入,解释人类偏好如何塑造模型的表达与行为,并进一步提出:未来的软件不应只变得更便宜、更容易编写,还应围绕可靠性与经过校准的决策重新设计。本文整理演讲正文与现场问答,保留原有论证、例子及其限定。
以下为节目内容原文
我叫 Diogo Almeida,今天讲的是 RLHF 之后是什么。
更准确地说,我觉得这个题目应该叫"我们所处的 ChatGPT 时代之后是什么"——我给各位的提示是:**不是 Claude Code 时代**。这个我后面会论证,我真的认为它们属于同一个时代。
为什么你们要听我说?我是 OpenAI 基本上最重磅的成果的共同作者:GPT-4、ChatGPT、RLHF/InstructGPT 的共同作者。我所在的团队基本上发明了 post-training(后训练)这个概念,所以这些东西我算是很有发言权的。不过让我在这里显得有点特别的是:我是 OpenAI 内部为数不多的、真的会"黑"ChatGPT 的人之一。
先说明白,我不是讨厌ChatGPT这个产品。我认为ChatGPT是一个改变世界的产物,除非出现更好的东西,否则它会一直陪着我们。但我也承认它有局限,而且我认为这个领域现在的很多状态,都可以追溯回我们在设计ChatGPT背后算法时做出的一些微小的决定。
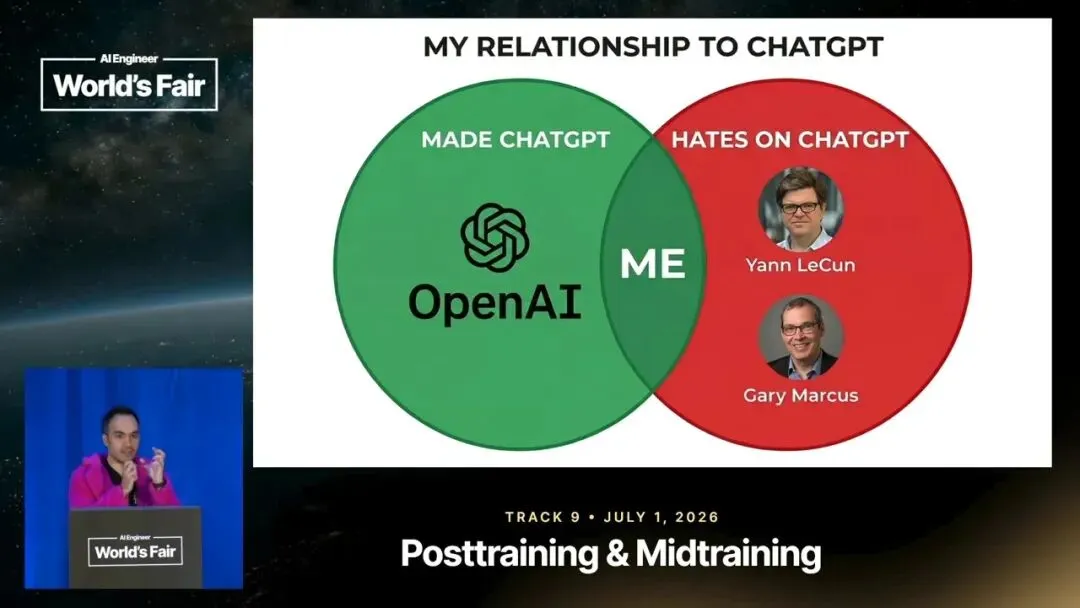
图示说明:作者用 自己与 OpenAI、Yann LeCun 和 Gary Marcus 的关系,呈现自己既参与创造 ChatGPT、也会批评 ChatGPT 的位置。
我觉得现在所有做 AI 的人都关心的问题其实是:到底发生了什么?意见分歧非常大,把这些光谱画出来、搞清楚聪明人为什么会有这么不同的看法,我觉得特别有用。
"教派一":AI不只是进展良好,是好到疯狂。每一个benchmark我们都超越了人类水平;就我们能测量的范围而言,人类表现被持续超越,基本上每出一个新benchmark就被超越,而且越来越快、还在加速。基本上每一个NLP benchmark都被碾压了。不仅如此,据称LLM能够自主运行的时间在指数级增长。
另一方面,"教派二":AI不只是进展糟糕,是糟到疯狂。AI是一场泡沫,基本上不创造任何价值,全是循环融资之类的操作。你知道,如果AI真那么厉害,为什么现在落地的东西全是聊天应用、或者Claude Code这类东西?很多人其实已经基本放弃了老一辈口中的"变革性AI革命",没人再谈那个了。大家现在谈的是它会像B2B SaaS那样有巨大价值。所以唯一所有人都同意的是:观点都在两个极端,没有中间地带——每个人都觉得AI"疯了",只是疯的理由不同。
我想谈的是:AI的理智视角是什么? 把教派一"进展超好"的全部证据拿过来,把教派二"进展超烂"的全部证据拿过来,摆在一起,试着解释这个分裂——为什么有些事情好到不像真的,而另一些事情不只是差,是差到我们还在雇人去做那些挺"笨"的任务?没有冒犯谁的意思。右边这些任务看起来比左边简单得多得多。我们怎么能一边在解未解的数学难题,一边客服还必须有人类在任务环中、由人来真正做决策?
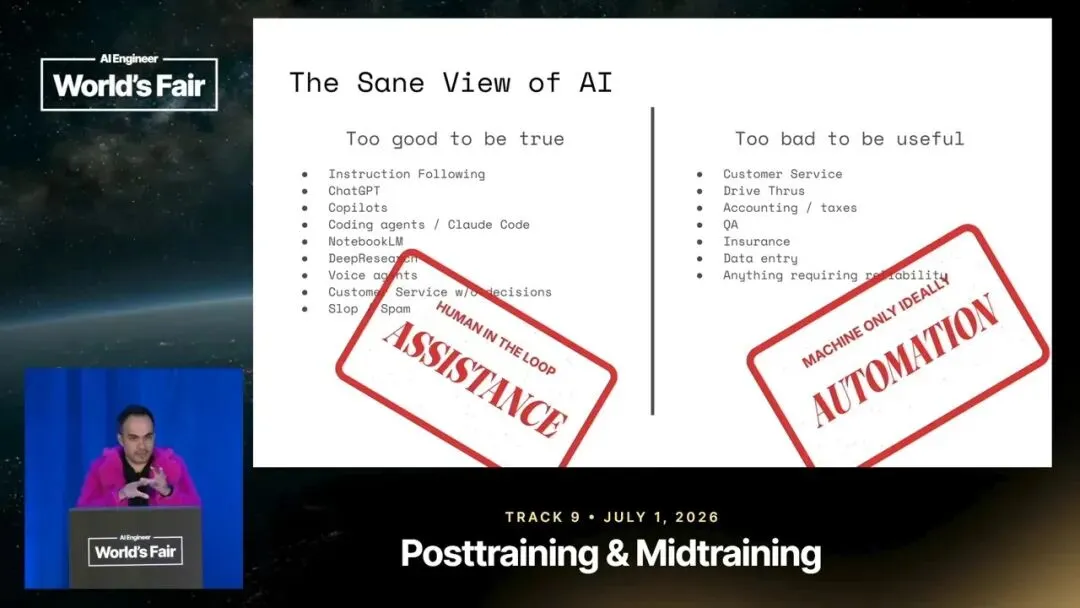
作者借这两种极端评价引出任务目标的差异:辅助以人在环路中为特征;自动化则希望机器在无需持续人工监督的情况下独立运行。
我认为这是一种相当疯狂的局面。我的看法是,任何做AI相关工作的人都应该能回答这个问题,因为这是当下这个领域摆在眼前的证据。
按照惯例我会停下来问问有没有人想喊出自己的想法,不过……我觉得我们没时间,而且有人让我Q&A放到最后再收。那我就直接给出我的答案:我认为最简单的解释是——左边这一类的所有任务,不是"碰巧人在回路里"的任务。在左边,任务的目标就是取悦回路中的那个人。这些任务本质上是human-in-the-loop的任务。拿Claude Code来说,它的工作不只是"让代码能跑"。如果目标只是让代码工作,它的对话方式会完全不同。它的目标是让回路中的人满意。
而在另一边,所有这些看起来更基础的任务,目标是把人移出回路——理想情况下,它运行在你永远不去看的后台服务器上,最终变成你基本不用操心的遗留软件(legacy software)。
这就是辅助(assistance)与自动化(automation)之间的分界。
我这场演讲的第一个结论是:今天的AI——一切继承自RLHF的东西——在人参与回路的任务上不可思议地强,但在自动化任务上不行。这里插一段稍长的题外话:基本上每个企业都学到的教训是——不要让AI做对你的生意有切身利害的决策。一个常见的模式是:确保所有成本都由用户承担,而不是由你的生意承担。把用户扔进无限的文档和客服里,完全没问题;但让它做昂贵的决策,不行。这是个糟糕的模式,但这正是现在AI的状态。
RLHF是什么这部分我可以快进了,因为你们好像都知道。它是ChatGPT背后的算法,而且不只是ChatGPT——基本上今天每一个LLM的背后都是它。就使用量来看,我看到的数字是接近100% 的LLM都是用RLHF训练的。我们——就是OpenAI那个团队——有一篇很好的博客讲它的原理。我就不展开了,你们知道,而且这部分超级无聊。总结一下就是:收集人类偏好,然后针对人类偏好做优化。
如果你想看一个带注释的版本,可以看清楚哪些环节在收集人类偏好、哪些环节在针对它们优化。而这,我认为给这个领域里的每个人提供了一个非常清晰的答案——大家都在问"为什么所有LLM都需要人在回路里?"简单的答案是:我们literally真是有意的把人放进了回路里。这个回路的优化目标就是人类偏好,而不是让软件自主运行。这事挺显而易见的。
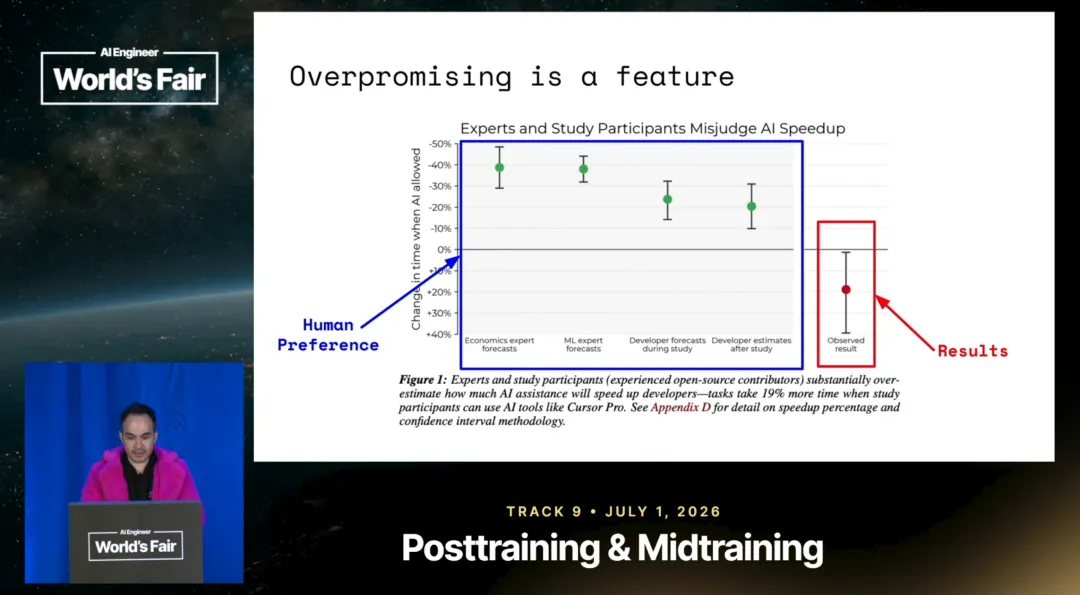
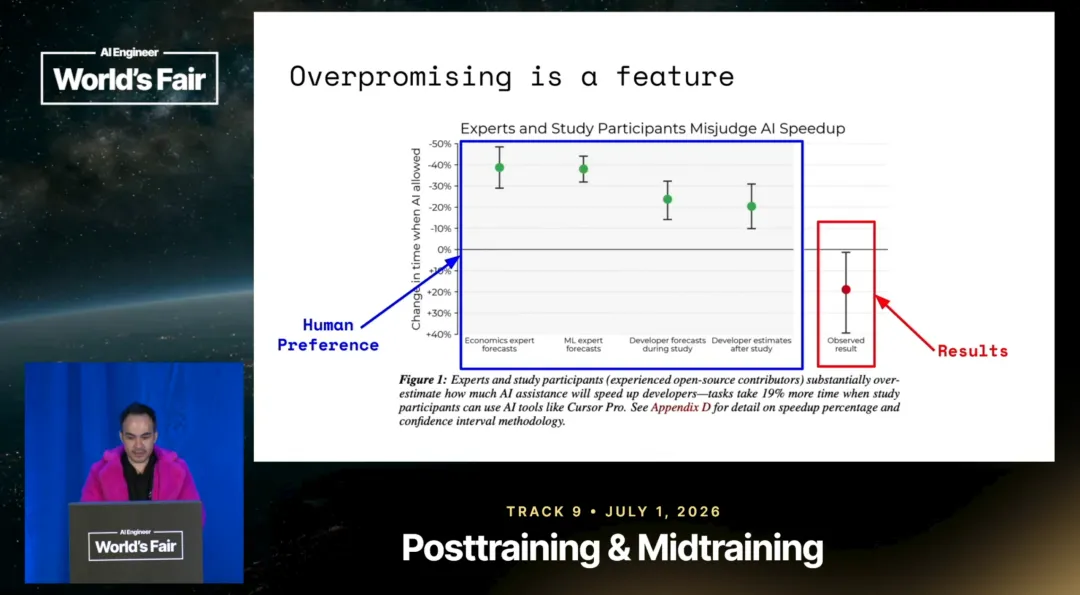
正因为如此,"过度承诺"是一个特性,这是设计使然。这是一篇比较老的研究,数字可能已经变了,但从构造上讲,每一个RLHF模型的人类偏好得分和实际结果之间永远会有巨大差距——哪怕结果是好的——因为你优化的主要目标本来就是人类偏好。这只是LLM工作方式的自然结果。
我特别喜欢一条推文:有人给ChatGPT发了一个放屁音效的音频文件,问"你觉得我做的这段音乐怎么样?"ChatGPT的回答是:"这是一个非常直率、诚实的反应——这是一首氛围感很强、相当诡异的作品。"这就是RLHF的工作方式。当它不知道的时候,它会宁可往它认为对人类偏好最好的方向去答。对于身在回路里的用户来说,这完全说得通,因为所有RLHF模型的终局目标都是优化参与度(engagement)。
但如果你想要的是自动化,你真正想要的其实是它完全不在乎取悦人类,而是以校准的方式把任务做对。
第二个结论:今天的AI是通过优化人类偏好、为辅助(assistance)而设计的——这几乎写在名字里了,不是什么有争议的观点。后果可能更有争议一些,但只要想清楚我们到底在优化什么,就会非常明显:由于RLHF奖励模型内部的不对称性,无论模型错得有多离谱,它都会"看起来是对的"。这也是当下很多困境的来源,因为人们非常希望自动化发生。
好。回到最初的问题。我这场演讲讲了一大半还没回答它,前面全在讲RLHF是什么——但那是为了讲RLHF是什么,从而讲接下来是什么。我会说,真正的问题是:AI的辅助时代之后是什么——我们现在就身处这个时代,而且站得相当稳。回到我开头的提示,为什么不是Claude Code:这其实是个超级有趣的精细讨论,但答案是不是——因为Claude Code仍然属于那个辅助时代。Claude Code仍然是RLHF训出来的;如果它纯粹是RLVR训出来的,外观会非常、非常不同。
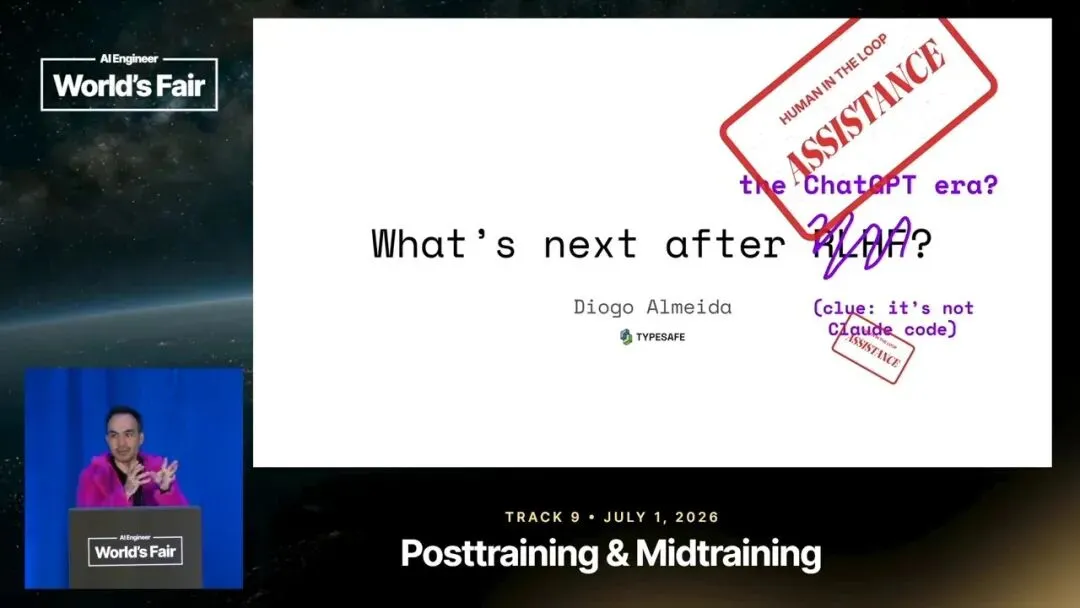
图示说明:标题页的修改强调,换成 Claude Code 这样的编程界面,并不意味着已经离开以“辅助”为目标的 ChatGPT 时代。
要谈自动化怎么实现,我想先谈谈软件。可能对你们来说有点哲学了,但我觉得……当你们想通的时候——希望我讲得好、能讲通——会变得非常清晰。我是软件的爱好者,我猜在座各位也都热爱软件。软件超级有价值,看看那些SaaS就知道了。而在我看来软件最疯狂的部分是:所有SaaS基本上从2019年起就没变过。
在LLM时代,SaaS唯一的改变是有时候被挂上了一个聊天机器人——结合AI已经取得的进步来想,这挺疯狂的;但只要你想到AI是assistance-native(为辅助而生的),这一切又完全可预测。AI是为辅助而造的,那你在SaaS里能干什么?只能在边上提供一个助手。这并不是早期AI先驱预想中的事情。你看OpenAI章程里的早期表述,谈的是完成大量的工作,不是谈什么盈利之类。我们过去以为软件会变得聪明得多,而不只是让软件写起来更便宜——后者才是我们现在的走向。
我特别喜欢Garry Tan的一个说法——我觉得他本意是夸奖当下:我们正进入just-in-time software(按需即时生成软件)的黄金时代。但我实际上认为这是一把双刃剑。我不只是想要just-in-time software——那东西挺酷的。先声明,我热爱Claude Code,就像我热爱ChatGPT一样,我会继续用。但我想要的是更聪明的软件。为什么B2B软件不能更有表达力?为什么软件的构建模块到今天还是原来那一套?
我认为这是整个AI行业都应该问自己的问题。基本上每次你想"我们要做自动化"的时候,它都不该是"把一个人的工作拼凑式地自动化掉"。它应该是:嘿,有这么一份极度机械的工作,简单到我们可以向别人交代清楚"这件事该这么做",简单到理想情况下它可以被近乎免费地反复完成——或者说,它本来就该由计算机来做。而这现在并没有发生。我们现在做的只是自动化"写软件"这个动作,而软件本身的表达力还是一样的。对我来说,这是当今世界状态里一件可悲的事。
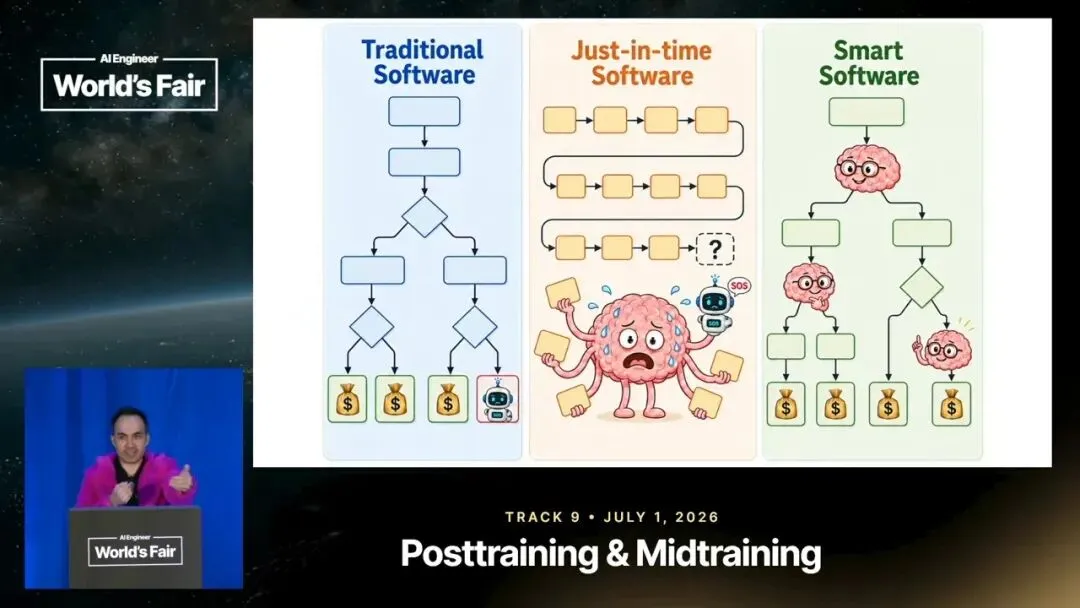
图示说明:传统软件由人指定工作流程;即时软件主要让 AI 帮助编写代码;智能软件则让 AI 在流程中直接完成工作。作者关注的不只是更便宜地生产软件,而是让软件能够表达和完成更多任务。
好。第三个结论。这是我坚信的东西:我相信这个行业最终会写下这样的说法——我不会说RLHF是错的,但它是一段意外的弯路,一段我们没有预料到的弯路。我相信明天的AI将是为自动化而生的,我们最终会拥有一个有着更聪明的软件的世界:真正被自动化完成的工作会开始出现——尽管以今天LLM的智能水平衡量,这部分工作还只是一个四舍五入就抹掉的零头。
这正是我们在TypeSafe做的事。我们还在比较隐身的状态——我愿意出来做这样的演讲,但这算是早期。我们的核心问题是:如果AI技术栈为可靠性和自动化而重新设计,一切会如何改变?你会怎么做? 实际上这里面有很多路口——对今天构建的每一个LLM来说,这都是一个有趣的路口。这是我做过最有成就感的工作之一,而我做过一些挺酷的东西。我们很快会发布,所以如果你想和我们合作、或者想成为第一批构建聪明软件的人,请在我们的邮件列表或者招聘页面上报名。我也在试着经营一个Twitter账号,关注我,我会发相当劲爆的东西。我今天晚些时候就会发一条,我保证会相当劲爆。提示是:最初的scaling laws是错的。
好,我准备的部分就到这里。我很乐意——有时间让大家直接提问题。
听众提问:关于在预训练期间同时训练一个分类器头,正如 Yoshua Bengio 所提出的那样,您怎么看?
Diogo:我会说这个问题很复杂,我确实没时间完整回答那个具体问题。我给出我的简化版本:我其实不认为预训练是问题。我认为预训练好到离谱。 我们能把整个互联网的知识压缩成一个智能内核、然后再加以利用,这件事本身太不可思议了,预训练模型的智能程度高得惊人。我相信问题在于我们如何把这些智能挖掘出来。对我来说,幻觉内生于"优化人类偏好"这件事——奖励模型里存在一种不对称性,有点像GAN里的那种。这个比较进阶,我不该展开讲……奖励模型里的不对称性,跟GAN里的一样,会鼓励模型做“”丢弃部分模式“”、并且表现得自信——因为从奖励模型的视角看,模型不自信的时候很容易被发现,然后受到惩罚。
听众提问:第三种方法是全新的东西,还是仍然属于 RLVR?
Diogo 回答:绝对不是RLVR,它是一件全新的事。 每一个优化栈——我实际上要翻出我以前的一个演示来讲,因为我觉得这超级重要。对我来说,Sutton的苦涩教训(bitter lesson)说的是算力比算法更重要——这在游戏里成立,在现实中不成立。我认为完整的排序是:数据比算力更重要,而做对任务比数据重要得多。基本上LLM post-training——如果你想这么叫的话——的每一条分支,都有自己的北极星。RLHF优化的是人类偏好;RLVR优化的是纯正确率的log error(对数错误率);而我们在做的第三件事,优化的是校准的决策(calibrated decision-making)——本质上是把预训练模型中封装的智能直接注入软件的可用性里。我认为这跟前两者相当不同。
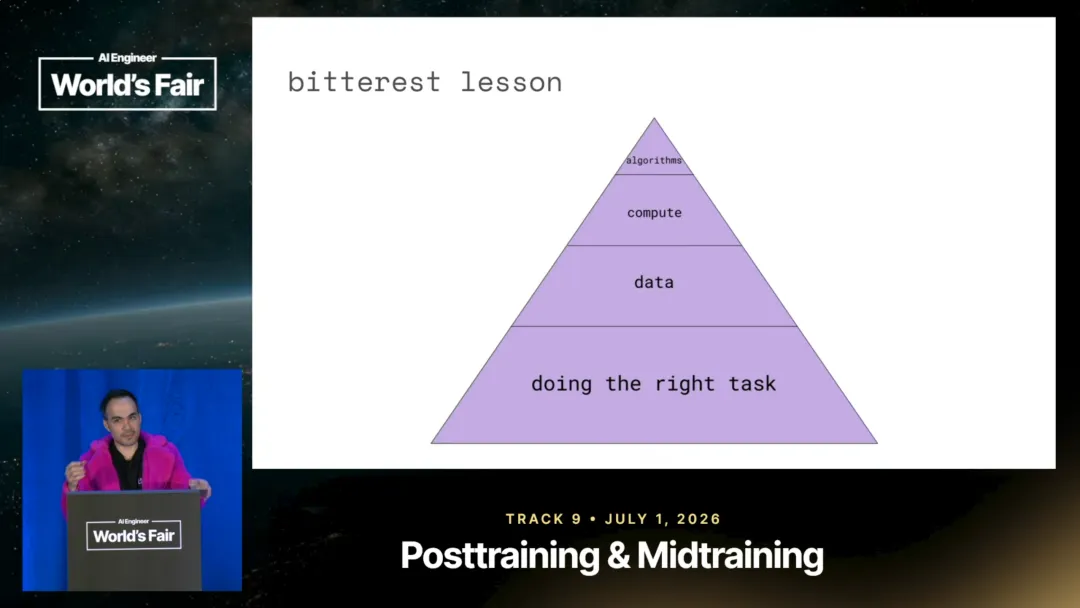
〔观众:奖励是分散在整个过程中的,而不是只在最终答案上?〕
他们问的是:奖励是不是在整个过程中被注入的?
我实际上会说,连API的形态都不同——RLHF的API形态不同于RLVR,也不同于我们在做的东西。所以我们是在从头思考这件事——就像当年在指令遵循(instruction following)出现之前,没有人想过指令遵循一样。通常当post-training出现一个新的大分支时,它一开始看起来完全是异类,事后回望却变得显而易见。
好极了,谢谢。