ARTICLE · 1047826
DeepSeek论文检测能查出来吗 不同AI工具生成的内容怎么判断
检测器通常只能估计文本是否具有生成特征,不能可靠证明具体来自哪个模型。本文说明模型、提示词、文本长度和人工修改为何都会影响结果。
‘你们能不能看出这段是DeepSeek写的?’很多人以为检测系统像指纹库,不仅能认出AI,还能报出工具名称。现实没有这么简单。模型越来越多,版本更新越来越快,同一个模型在不同提示下也会写出完全不同的文字。
检测的是特征不是品牌
系统分析的是最终文本。它可能发现语言规律,却通常无法仅凭文字确认生成工具、账号或具体时间。所谓‘某模型专属痕迹’,需要非常谨慎地理解。
短回答最难稳定判断
一句标题、几条提纲或一小段摘要包含的信息太少。无论系统给出高还是低,都不宜过度解读。更完整的上下文通常更有参考价值。
人工改写会让边界变模糊
有人让AI生成初稿,再加入数据和个人分析;也有人亲自写完后让AI润色。现实文本经常是人机混合的,简单的二元标签很难描述全部过程。
最终仍要问使用是否合规
能否被检测出来,不等于能否使用。先看课程或学校允许AI做什么,是否需要披露,再决定怎样使用工具。规则问题不能交给检测概率回答。
为什么无法可靠追溯到具体模型
多个模型可能生成相近表达,同一模型也会因提示词、温度、语言和版本产生巨大差异。文本经过人工删改后,来源边界更模糊。仅凭成品文字指认‘一定来自DeepSeek’通常缺少充分依据。
长提示词也会改变检测表现
如果用户提供自己的数据、写作样例和严格结构,生成结果可能更接近个人风格;只输入一句宽泛要求,结果通常更模板化。因此‘某模型一定容易或不容易被查’不是稳定结论。
真正该保留的使用记录
若学校允许辅助使用,记录工具、日期、提示内容、输出用途和人工核验。答辩时能说明AI在哪一步介入、哪些内容由你确认,比猜测检测器能否认出模型更重要。
把DeepSeek论文检测问题带回自己的论文
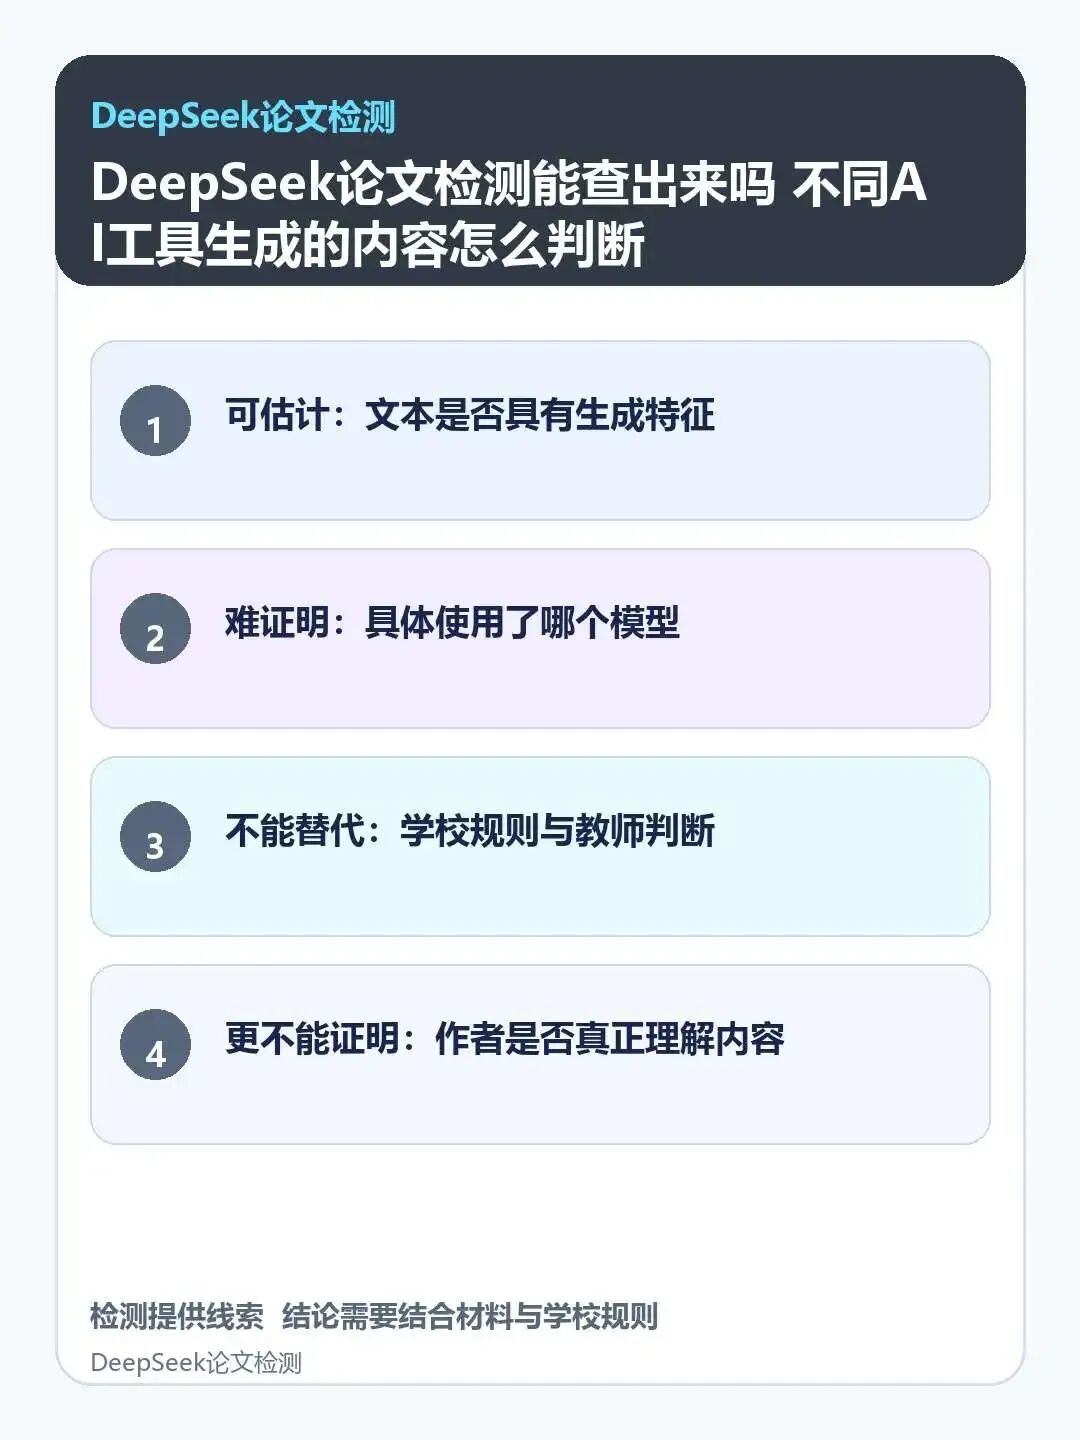
搜索DeepSeek论文检测时,人很容易被一个百分比或一句经验带走,但真正需要处理的是自己的文件。可以打开论文,从报告标记最多的章节开始,逐段回答三个问题:这段事实从哪里来,观点是怎样推出来的,我能否不看原文向导师解释。再结合本文的检查重点——可估计:文本是否具有生成特征、难证明:具体使用了哪个模型、不能替代:学校规则与教师判断、更不能证明:作者是否真正理解内容——给每段标注“保留、补证据、重写或询问导师”。这种做法虽然比批量换词慢,却能留下清楚的修改理由,也不会为了追求数字误伤专业内容。
和导师沟通时不要只发一个百分比
如果DeepSeek论文检测结果可能影响提交,建议把问题整理成一页说明:送检文件名称与时间、检测范围、使用平台、总结果、主要标记章节、你掌握的原始材料,以及准备采取的修改。询问导师时可以直接说:‘这几段被标记,但我保留了数据和早期草稿,想请您判断是表达问题还是需要补充论证。’这样的沟通比只问‘这个比例能不能过’更容易获得明确答复,也能减少双方对同一数字的不同理解。
检测之后还要回到论文质量
完成DeepSeek论文检测相关检查后,再做一次与百分比无关的通读:题目与研究问题是否一致,方法能否支持结论,图表是否与正文相互印证,引用能否查到,限制是否如实说明。AIGC检测没有发现明显特征,并不代表这些项目自动合格;出现较高疑似值,也不等于论文已经被认定违规。最终需要交付的不是一张漂亮报告,而是一篇作者能够解释、材料可以复核、结论边界清楚的论文。
写在最后
不要把注意力放在‘哪个模型更难查’,而应放在‘哪些工作必须由我完成并能解释清楚’。