ARTICLE · 1048762
AI怎么走到今天?聊聊它的来时路
我今天想到一个问题。
以后的小朋友遇到一道不会做的题,第一反应会不会就是,问一下豆包?
我们小时候遇到不懂的东西,要翻书、查字典、找资料。后来有了搜索引擎,就在几个网页之间来回找。
可对以后的小朋友来说,先自己翻一遍资料,可能不再是最自然的选择。他们一开始接触的,就是一个能回答问题、还能接着往下聊的 AI 。
当然,这是我的设想。但顺着想下去,还真有点感慨。
我们还在感叹 AI 怎么突然这么厉害,他们可能会觉得,这有什么好奇怪的,它本来不就应该这样吗?
对我们来说,能这样聊天的 AI 好像才走进生活没几年。现在又开始聊智能体了,连期待都变成了“你能不能直接帮我把事情做完”。
这中间到底发生了什么?
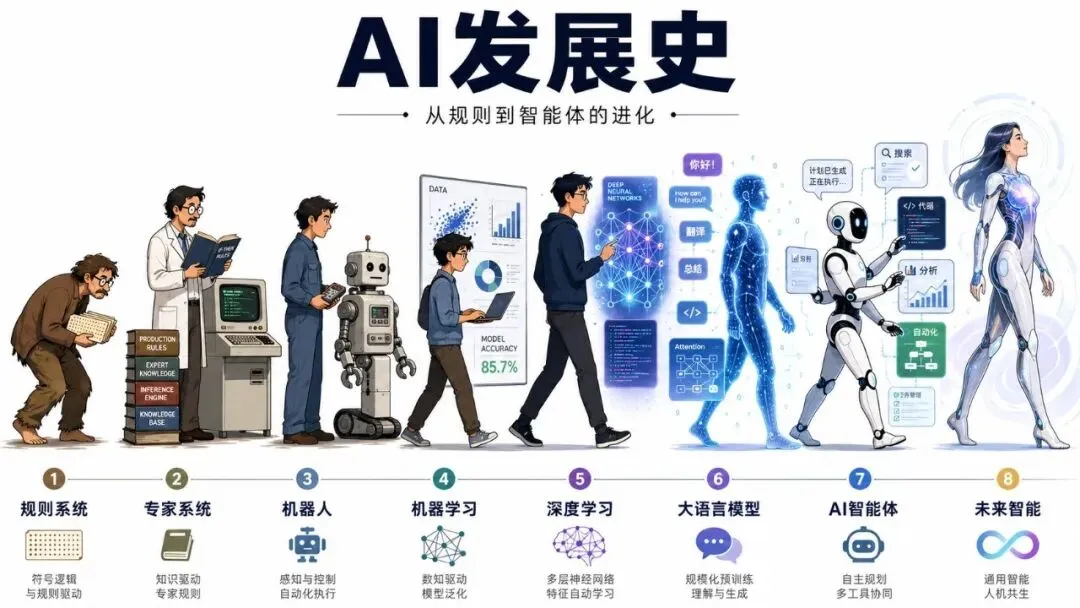
这张图可以帮助我们认路。不过先说清楚,它是能力演进的示意,不是严格的历史年表。机器人、机器学习、规则系统长期交叉发展,图里的“未来智能”也还是展望。
图中的准确率数字只是画面示意,不代表某次实验结果。
要找起点,得先往前走很远,走到今天这些产品都还不存在的时候。
电子计算机让复杂计算有了新的实现方式,也让一个问题变得具体:既然机器可以执行计算,它能不能做一些我们称为“思考”的事?
1950 年,图灵发表《计算机器与智能》,讨论的就是这个问题。
他用“模仿游戏”把问题换成一种可以讨论的测试:如果通过文字交流,人难以分辨对面是机器还是人,我们该怎样评价机器的表现?这也是后来人们谈论图灵测试时的重要来源。
这可不是说,会聊天就等于拥有人的思想。图灵是在寻找一种办法,让“机器能不能思考”不只是停留在争论定义上。
今天我们习惯了在聊天框里和 AI 一问一答,再回头读这个问题,会有一种很奇妙的距离感。七十多年前,已经有人在认真琢磨它了。
1955 年,麦卡锡、明斯基等人写了一份研究提案,打算在第二年夏天,聚集一批研究者,讨论机器能不能使用语言、形成概念、解决问题。
1956 年的达特茅斯研究活动,后来成了人工智能历史上的一个标志。
你看,想让机器变聪明这件事,大家已经琢磨了几十年。
早期一条很有代表性的路,是把人的知识写成规则。满足什么条件,就做什么判断。把足够多的规则交给电脑,让它一步步推下去。
专家系统就是这条路的重要实践。 1965 年开始的 DENDRAL ,把化学领域的专家知识用到推断分子结构上。
听着很合理。专家有经验,电脑算得快,把它们接起来,不就行了?
麻烦在于,人会做一件事,不代表能把怎么做毫无遗漏地写出来。
试着给“认出一只猫”写规则就知道了。有耳朵,有胡须,有尾巴。那狗呢?猫只露半张脸呢?趴着、背着、躲在桌子下面呢?
这是个类比。它想说明的是,开放世界里的变化太多,靠人逐条补规则,很难补完。
这一路也没有像图上画的那样,每走一步就顺利升级。计算机历史博物馆保存的专家系统创业者记录里,既有技术被采用的故事,也有公司发展之后失败的经历。某个领域做得不错,并不意味着马上能造出一个什么都懂的系统。
研究者还在探索另一条路。
有些规律,能不能让机器从例子里学?
机器学习就在研究这样的事。给模型数据,通过训练调整内部参数,让它逐渐学会分类、预测或其他任务。人仍然要设计任务、准备数据、检查结果,只是不必手写每一种情况的处理规则。
这里别误会,机器学习并不是等专家系统退出舞台后才出现的。把它们排成几格,是为了讲清思路,真实的研究一直有交叉。
深度学习沿着这条路,又往前走了一截。
用多层神经网络,学习数据里不同层次的特征。拿图像举例,可以粗略理解成从局部纹理、形状,逐渐组合出更复杂的表示。当然,网络内部没有一个小人在认真背“猫长什么样”。
2012 年,后来被称为 AlexNet 的深度卷积网络,在 ImageNet 图像识别研究中取得了突出的结果。大量图像数据、 GPU 计算和网络设计,在这个节点上配合出了效果。
机器能从复杂数据里学到有用的东西,这条路变得更有说服力了。
接下来有一个很多人听过的名字, AlphaGo 。
2016 年 3 月,它以 4 比 1 战胜李世石。背后不是把所有棋谱背下来这么简单,而是把深度神经网络、搜索和通过对弈改进策略的方法结合起来。
围棋的规则可以写清楚,可下一步下哪里,并没有一张能让人照着填的标准答案表。机器在这种复杂选择上做出了成绩。
但赢棋和陪你聊天,仍然是两回事。那时候,你并不能因为 AlphaGo 下棋厉害,就让它顺便帮你解释一道作业题。
语言更麻烦。同一个词放到不同句子里,意思可能不一样;一句话前面说了什么,也会改变后面的理解。
2017 年,研究者提出 Transformer 。它用注意力机制处理序列中不同位置之间的关系,并让训练更容易并行进行。
这个名字可以先不用记。抓住一个意思就够了,研究者找到了一种有效处理语言信息的架构,后来它成了许多大语言模型的重要基础。
再往后,把更大规模的文本、算力和训练方法接上去,模型能做的语言任务越来越多。
但这里还有一道门槛。一个会生成文字的模型,怎样才能更好地听懂人的要求,接住追问,按要求回答?
2022 年 11 月, ChatGPT 发布。它背后除了语言模型,还有对话示范和人类反馈等训练,让普通人可以通过聊天使用这些能力。
AI 不再只是论文里的指标,而是输入框对面一个可以反复追问的工具。
不过,它也会把错误说得像真的。发布时的官方说明就写了这个问题。
到这里,离智能体还差什么?
想象你对一个只提供文字回答的模型说,帮我把这周的报销整理好。
它可以给你步骤,列个表格格式,提醒你检查发票。
然后呢?
发票还在文件夹里,数字还没核对,表格还没保存。它把建议讲完了,事情仍然等着你做。
要往前走,系统就得让模型接触真实资料,能够使用工具,并看到操作后的结果。
比如,读取文件、调用计算程序、把结果写进表格。这些动作需要外部程序执行,也需要相应权限,光在聊天框里生成一句“已完成”可不算。
步骤预先安排好的,可以交给固定的工作流;需要根据结果调整下一步的,则可以尝试让模型参与决定:资料缺了要查哪里,算完了该不该复核,什么时候需要人来判断。今天基于大语言模型的智能体,就在尝试承担这部分工作。
2022 年提出的 ReAct ,是这条路线上的一个代表性研究。它把推理与行动交替组织起来,让模型通过行动获取信息,再据此更新后续步骤。
可以把这个过程理解成,先判断下一步,调用工具,观察反馈,再继续。
会回答,和能把事情做成,中间隔着行动与验证。
其实,让机器感知环境、规划行动的研究也很早就有了。早期的 Shakey 机器人已经在探索这些能力。今天的新变化,是大语言模型给这类系统带来了更灵活的语言交互和任务处理方式。
这些能力接在一起,开始能处理我们用日常语言提出的、更复杂的任务。但工具用得越多,也越需要检查结果。能执行操作,不等于每一步判断都可靠。
回过头看,今天这种突然变厉害的感觉,就没那么突然了。
人们试过把知识写成规则,也试过让机器从数据里寻找规律。后来,它能识别图像、处理语言,我们终于可以直接和它聊天。再往前一步,它开始借助工具,尝试把任务做下去。
这些路并没有走完,旧的方法也没有全部消失。几十年的积累,最后藏进了我们眼前这个很简单的输入框里。
至于以后会走到哪里,我不想给一个特别满的答案。图上那个“未来智能”很好看,但通用智能什么时候实现、会是什么样,并没有一张可以照着兑现的时间表。
我更愿意先想象一些小事:一个问题问不明白,可以换个说法继续问;一个念头原本因为不会写代码、不会做图就搁下了,以后也许能更容易地试一试。
这么想,又会回到开头那个小朋友。
也许有一天,我们跟他们说,以前为了弄懂一个问题,真的得一本本翻书、一页页查。他们能理解这句话,却很难理解我们第一次看到 AI 连续回答问题时,为什么会觉得不可思议。
就像我们也很难完全体会,更早的人第一次接触电话时是什么心情。
我倒不觉得一定要让他们再经历一遍我们的不方便。能少花一点时间找资料,多留一点时间去问为什么,挺好的。当然,回答有没有道理,还是得慢慢学着判断。
只是偶尔回头看看,会更明白眼前这些方便是怎么来的。
我们记得字典和书页,也看着聊天框一点点变成能办事的工具。这种变化,是我们正在亲身经历的。
以后再听到一句“这有什么,问一下 AI 不就好了”,我大概还是会感慨一下。
是啊,现在可以这样了。
 我是杜少峰