ARTICLE · 1049637
ChatGPT发明者发布不说话的AI:号称快200倍,独立实测快5倍
想象你的客服系统里坐着个AI。用户来一句,我的卡被扣了两次钱。它的任务只有一个判断:这单转售后、转技术,还是转账单?它却先跟你聊了9秒,引经据义,最后甩给你一段话,让你自己从里面抠出「技术」两个字。
9月15日,🏷️TypeSafe AI(一家刚出隐身期的公司)发布了模型Jev。它不聊。状态喂进去,它直接回一行数:技术85%、账单8%、销售7%,附一句把握0.82[3]。就像仪表盘上的传感器,只报数值,不做寒暄。
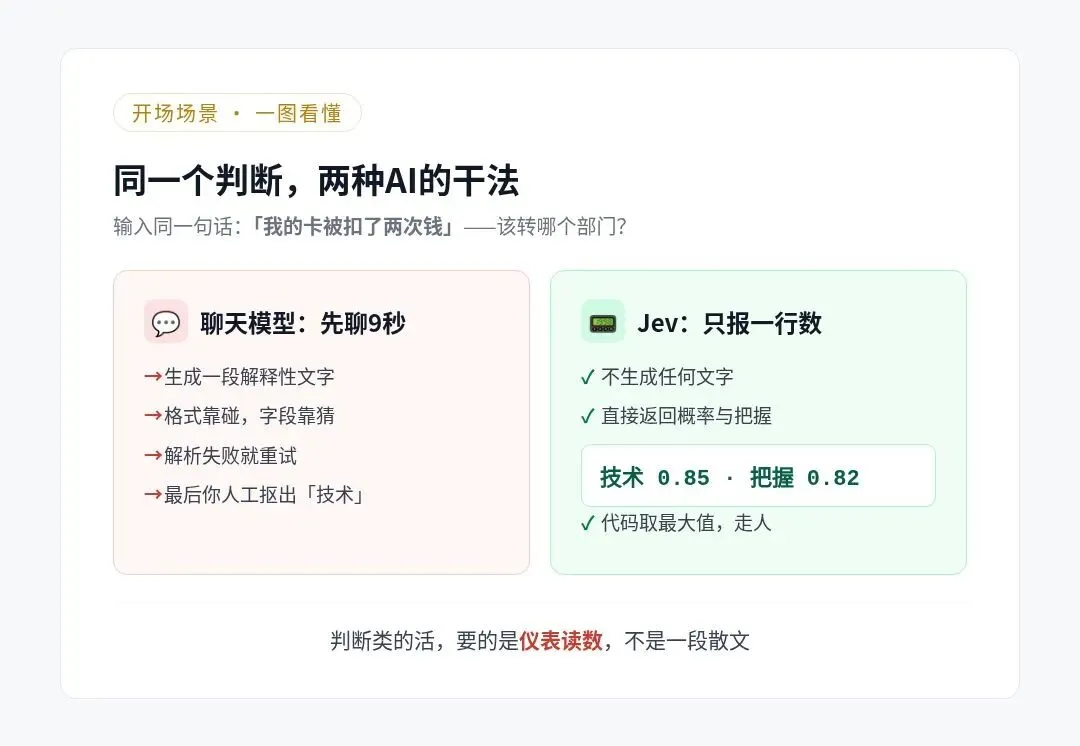
🔑 费曼摘要:以前的AI是个话痨员工,什么都聊一轮再给答案;Jev是个只填表的员工。表印好了,它填数字和把握,填完就走。官方宣称这比聊天AI快
200倍、省444倍。发布24小时内,3个独立团队拿真实业务实测:快5倍、省8.6倍、省1.6倍。数字大缩水,但方向头一回被外人坐实,AI不止聊天一种形态,决策和生成正在分成两个工种。
一、造它的人,凭什么信
一家没听过的公司,凭什么看?先看人。
创始人👤Diogo Almeida,OpenAI出身。官网简历写着:InstructGPT与RLHF研究的共同作者。ChatGPT能听懂人话的那套训练方法,他是构建者之一[2]。
2024年他隐身,一消失就是2年。9月15日复出,带着4000万美元种子轮,DCVC领投。团队从OpenAI、Google Brain、Meta FAIR、Stripe、Airbnb、Docker这6家公司挖来旧部[2]。
模型的名字有讲究。Jev致敬经济学家杰文斯:煤的利用效率越高,烧煤反而越多。效率越提,用量越爆。公司赌的是,判断一次的成本降到近乎为零时,软件里会塞满以前舍不得用AI做的判断[3]。
这个悖论本号6月写过:AI软件像拧开的水龙头,部署一次,token哗哗流[4]。为什么一个新模型要蹭一百年前的经济学家?因为它的商业计划书就建立在这条悖论上。
另一层命名来自卡尼曼《思考,快与慢》。System One,指快而直觉的判断:秒级定生死,不带推理链。公司给模型类起名System One Models,意思摆在明面上。他们做的不是更聪明的AI,是更快的直觉。
名字起完了,这模型到底怎么干活?
二、不说话,怎么干活
一个AI不生成文本,那输出什么?答案是三张印好的表。
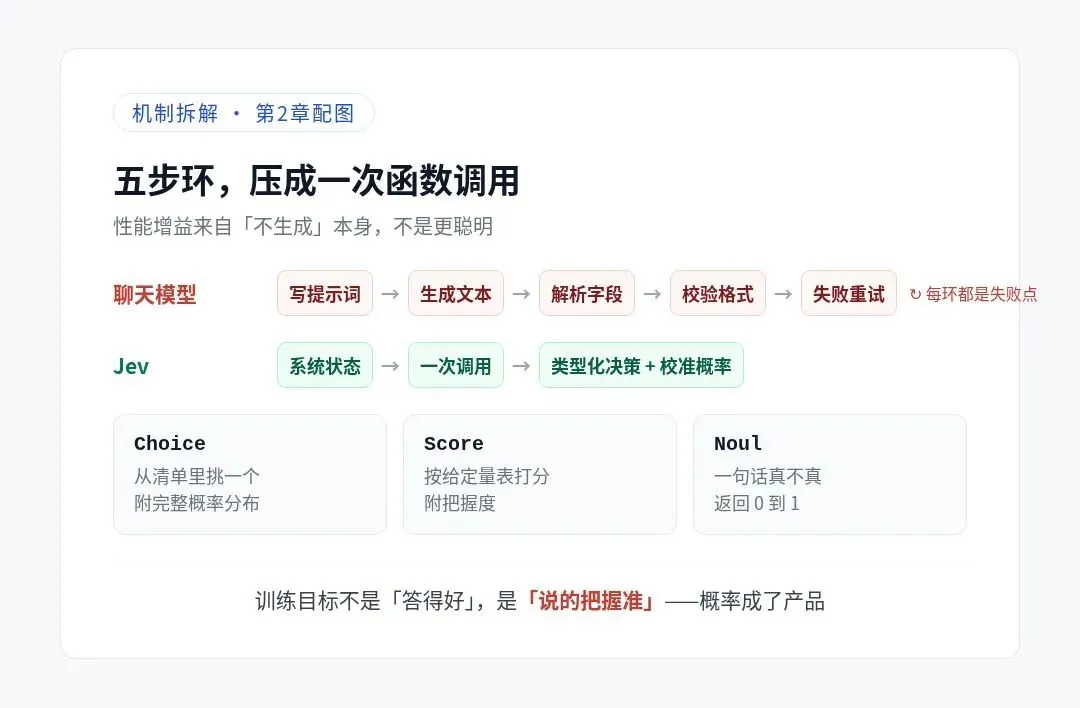
接口只有三个问题类型。Choice:从清单里挑一个,附完整概率分布。Score:按你给的量表打分。Noul:判断一句话真不真,返回0到1的数[3]。
还是拿扣款那单说。传统做法,你得给chat模型写提示词,等它吐一段话,再解析字段,格式错了重试,拒答了哄一哄。五步环,每一环都是失败点。
Jev把五步压成一次函数调用。状态进去,概率出来,代码看哪个最大就走哪条分支,完事[3]。清单再长也不怕:Choice支持最多255个选项,超了走两段式先打分再挑[3]。
🗣️ 说人话:好比医院的分诊台。全科医生什么都能聊,但分诊台只干一件事,把你分到对的科。高频小判断要的是分诊台,不是全科门诊。
训练方法是关键差别。chat模型靠RLHF(人类反馈强化学习,人给回答打分)。
Jev靠RLCD,校准决策强化学习。训练目标不是答得好,是说的把握准:模型说一件事有两成概率,这件事就该真的两成概率发生[3]。
这个性质有学名,校准。chat模型你问它有把握吗,它说非常有把握。那是修辞。校准模型说0.82,意思是长期看这类判断它对八成。概率本身成了产品,不是语气词。
所以官方敢喊那句最猛的话:数学上不可能幻觉。Jev不生成文本,没有能被编造的字符串;返回值永远符合预定义格式[1]。
听着无懈可击?主页上那组快200倍的数字,才是故事的开始。
三、200倍:三个口径,同一天
官方到底宣称快多少倍?同一家公司自己的页面,有3个答案。
主页标题:193.6倍快、444.6倍便宜[2]。博客正文:快40-200倍,限形状贴合的查询[2]。创始人的发布推文:快20-200倍、省40-400倍[2]。
我把主页的延迟对比图翻出来,自己算了一遍:8.566÷0.114≈75倍。跟头顶的193.6倍同屏共存,没有任何标注说这是两回事[2]。
193.6倍哪来的?来自TypeSafe自家的新基准workflow evals(工作流评测)。官方注释里自己承认:参照答案是GPT-6 Astra与Fable 5.1两个前沿模型的平均。这意味着,测的是跟两个大模型的一致性,不是正确性[2]。官方还补了一句,方法偏向OpenAI和Anthropic的模型[2]。
定价也值得抠。输入每百万token收0.042美元,输出免费。听着像降维打击。但公司自己写了句难得的话:我们不能证明这个价格没有补贴[2]。
⚠️ 现实检验:一家公司同一天三个口径,未必是心虚。更可能是,他们也没算清真实业务里到底快多少。答案得等外人拿真活来试。
外人来得比谁都快。
四、24小时,三份真实账单
发布次日,3个没有利益关系的团队,各自拿真实业务测了Jev。数字全在本号逐条核对过的第三方报道里[1]。
第一份账单。英国活动公司🏷️Near Here,拿50条真实的商家上架审核跑Jev:准确率96%,赢过Mistral Small的84%和Gemini Flash-Lite的86%。这是目前对Jev最有利的公开数字。
但速度只有对手的5倍,成本省8.6倍。每千次判断0.043美元,单条决策平均0.59秒[1]。
第二份。🏷️Good Start Labs,6003条评分检查,Jev与Claude Fable一致率91.5%。成本每百万约160美元,对照DeepSeek V4.1 Flash的260美元,便宜1.6倍[1]。我算了一遍:260÷160≈1.6。对手已是市面最便宜的模型之一,444倍的优势瞬间跌到一倍半。
第三份。🏷️Every,速度终于兑现:每段0.35秒,Fable是8.83秒。但他们往文本里埋了7个缺陷,Jev抓出6个,Fable全抓[1]。
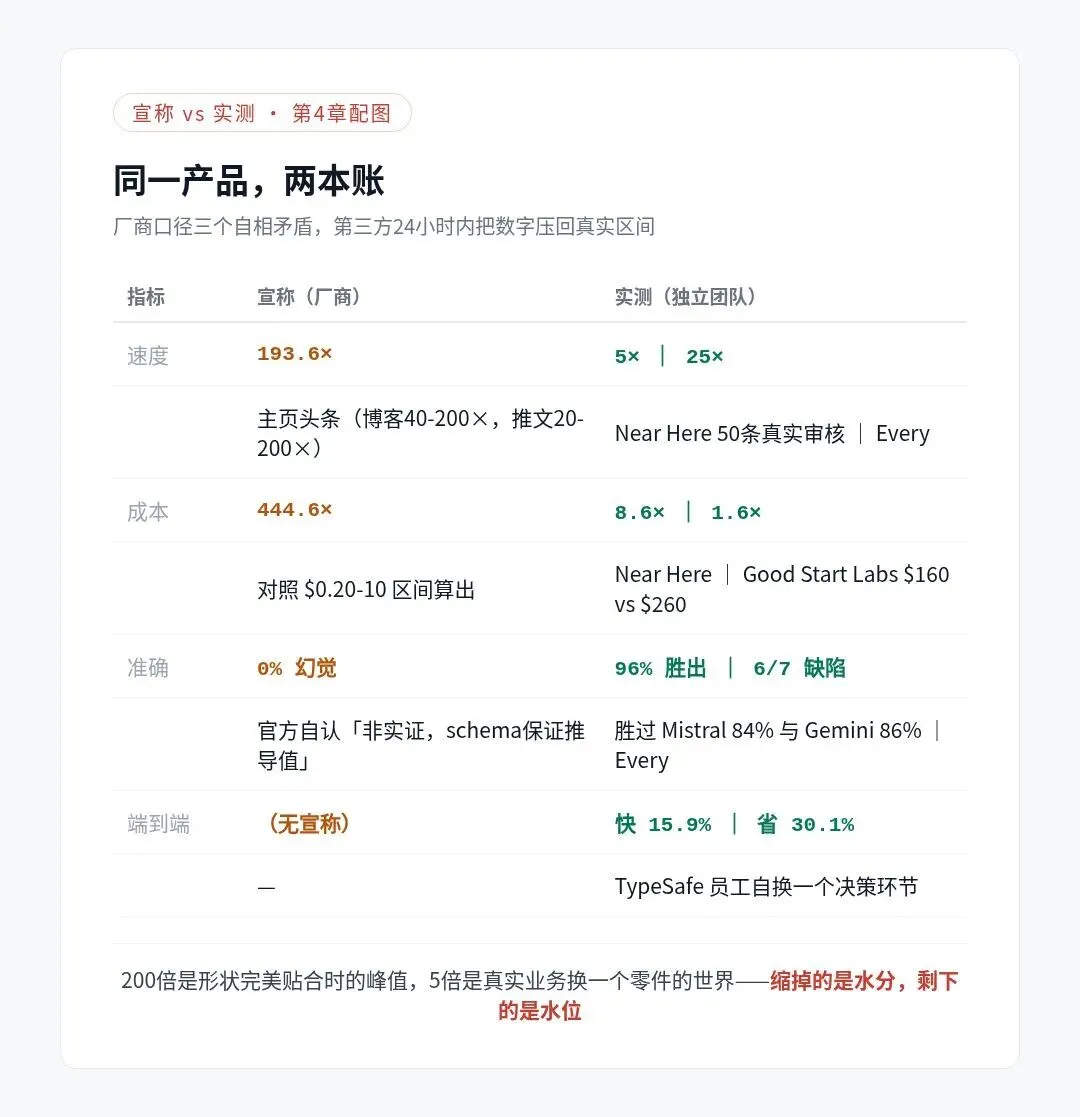
还有个更扎心的。一位TypeSafe自家员工,把DSPy管线里的一个决策环节换成Jev,端到端:快15.9%,省30.1%[1]。换一个便宜零件,整车不会按同一倍数提速。这可能是全部数字里最诚实的一个。
📋 宣称 vs 实测对照(厂商口径 | 第三方实测) 速度|宣称
193.6×→ 实测5×、25×成本|宣称444.6×→ 实测8.6×、1.6×准确|宣称0%幻觉 → 实测96%胜出、缺陷6/7端到端|(无宣称)→ 实测+15.9%快、+30.1%省
两组数字都对。200倍是形状完美贴合时的理论峰值,5倍是真实业务里换一个零件的世界。这意味着,厂商的头条和你的账单都是真话,只是量的不是同一个东西。
五、0%幻觉的小字
宣称里最锋利的0%幻觉,官方小字自己拆了台。
TypeSafe原话:我们的数字不是实证结果。schema(预定义输出格式)匹配是保证的,所以敢把0%画进图里[1]。
翻译成人话:Jev保证的是「形状」,不保证「真值」。它保证返回一张格式正确的表,不保证表里的答案是对的。类型全对、答案是错的,照样发生[1]。
这种保证值多少钱?要看你买的到底是什么。买路由分流,格式对就够用八成;买医疗分诊,答案是错的那两成就是人命。
💡 增量视角:行业里把「结构化输出」和「可靠」划等号,划了两年。这行小字第一次把等号拆开卖:形状上货架,真值另算钱。
这不是狡辩,是诚实的边界声明。但它把一个行业默认混淆的东西摆上了台:过去两年,结构化输出被当成可靠性的代名词。格式对了,就当答案对了。
Jev第一次把两件事拆开定价:形状可以保证,真值只能校准。而校准曲线,官方还没发论文[1]。
这意味着什么?买这类模型的人,往后要问两个问题,而不是一个:表填得对不对,以及表填得准不准。前者白纸黑字保证,后者只能拿真实数据慢慢验。
另一个容易漏的细节:模型现在只有候补名单,没有公开API。上面三组实测全部来自早期内测资格,外人暂时无法复现[1]。
GitHub上48小时冒出1328个复刻仓库,头部5165星。我翻了几个头部仓库的贡献者列表,大多1-2人。星标竞速是热度,不是采用。
六、方向为什么反而坐实了
数字缩水四十倍,为什么还说这方向是真的?因为缩水后的数字,依然够用。
看钱。Near Here的账单:每千次审核0.043美元,用Mistral Small要0.37美元[1]。对一天做几万次小判断的公司,这不是省点钱,是换了一个成本结构。
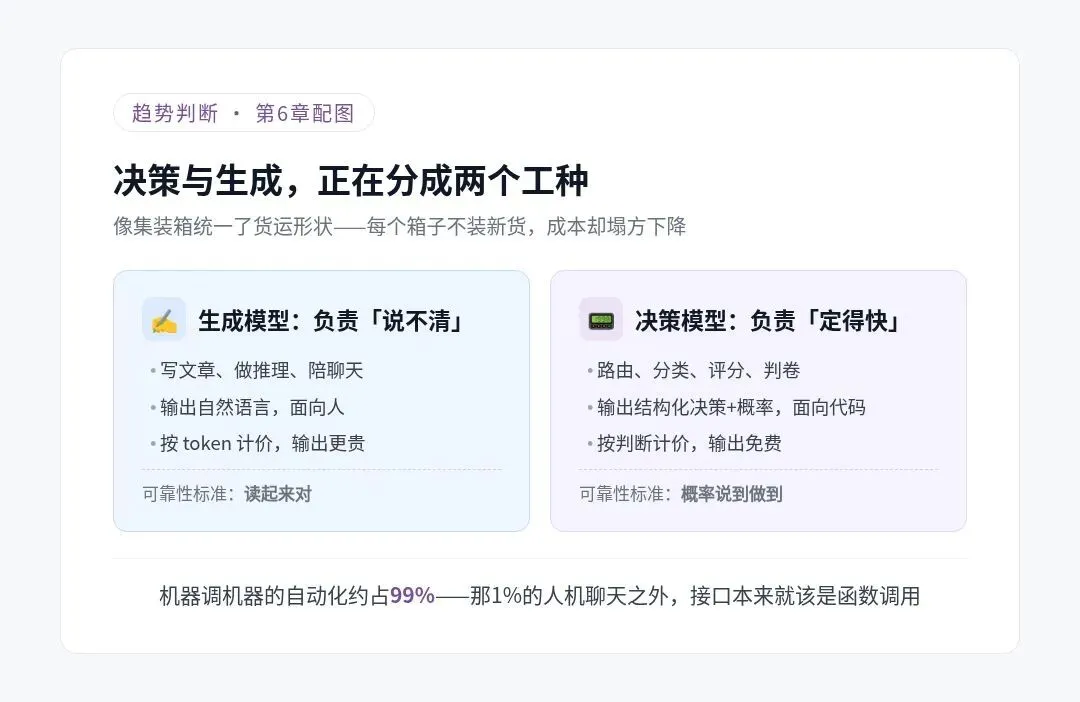
更硬的是那个少有人讨论的论点。TypeSafe的ML入门文档写着:大规模AI自动化,约99%是机器对机器,1%才有人机[3]。机器调机器的接口,本来就该是函数调用,不是聊天窗。
今天的软件架构恰恰相反:代码里嵌一个chat模型,用聊天的姿势干判断的活,再把聊天记录解析回数据。Jev只是把这件别扭的事正名了。
🌉 类比桥:好比集装箱出现之前的货运码头。货物什么都能运,但每换一种运输工具,就得全部卸下重装。集装箱不装任何新货,它只统一了形状。之后全球贸易成本塌方式下降。决策与生成分层,就是AI界的集装箱。
生成模型写文章、做推理、陪聊天。决策模型在管线里一天亿次地填表。两个工种,两套定价,两种可靠性标准。
对用AI做事的人,这扇门开了一条缝。审核、评分、分类、路由这类高频小判断,专用的便宜模型开始出现。
教育场景尤其近。判卷、作业分流、作文按量表打分,全是输入状态、输出结构化判断的形状。Good Start Labs那6003条评分检查,就是直接类比[1]。
但别急着上车。Jev的核心主张,校准概率,目前无公开论文、无第三方复现、无公开API。三个无之前,它是一个方向正确的期货。
七、验证这判断的两个窗口
分层是真趋势,怎么证伪?两个观察窗。
窗口一:Jev公开API后,三组数字能否复现。若Near Here的96%或Every的0.35秒不可复现,方向被验证的结论整体回撤,此事降级为一次成功的注意力营销。
窗口二:3个月内,OpenAI、Anthropic或DeepSeek若在自家模型里补齐校准概率输出,专用决策模型的窗口就从新范式收窄成一个价格歧视工具。分层的故事,讲不下去。
反过来,若开源复刻里跑出可用水平、校准曲线经得起外人测,杰文斯那句起名的深意就兑现了:判断成本趋零,判断塞满所有软件。
挑AI的时候,你多半先问它聪不聪明、聊天顺不顺。在AI只当聊天顾问的年代,这没错。但判断类的活,风向变了:该问的是它填表准不准,概率说到做不到。
从6月的水龙头到今天的填表工,同一条线:AI的账,正从按对话算,改成按判断算[4]。
号称200倍,实测5倍。缩掉的是水分,剩下的是水位。
参考来源
[1] The Cherry Creek News, "TypeSafe's Jev Claims 193x Faster and 444x Cheaper", 2026-09-16.[2] TypeSafe AI, "Introducing System One Models and Jev", 2026-09-15.[3] Toolbit, "Jev review: typed probabilistic decisions", 2026-09-16.[4] 本号, "AI软件即水龙头 — Jevons悖论降临", 2026-06-19.