ARTICLE · 1055489
Jev,让 AI 的判断直接接进代码
“别排查了,也不用重启。我只是想知道 checkpoint 是干什么的。”
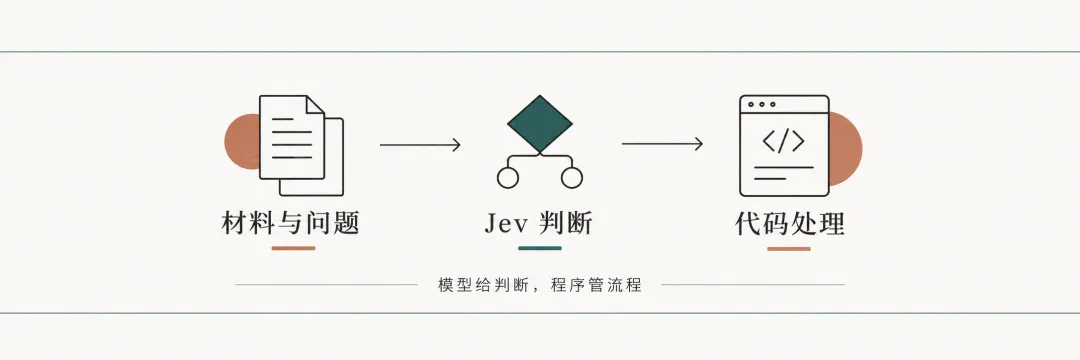
同一句话里同时出现排查、重启和知识提问。对一个运维助手来说,首先要判断用户想做什么,再决定交给哪个处理入口。
这类问题到处都有。客服消息该转给谁,检索到的资料哪段更相关,一份回答的结论有没有证据支持。我们需要的经常只是一个类别、一个分数,或者一个是否判断。
Jev 就是围绕这类任务设计的模型。
我读了 TypeSafe 的文档和社区应用案例,又用构造的中文材料跑了五次真实 API 调用。它比较值得关注的地方,是把这些小判断做成代码可以直接使用的结果。
Jev 是什么,和普通大模型调用有什么区别
Jev 是 TypeSafe 的旗舰模型,官方将这类模型称为 System One。你提交当前材料和明确的问题,它返回有类型的答案以及相应概率,不生成一段解释性回答。官方介绍 [https://docs.typesafe.ai/introduction]
它的输入可以是文本,也可以是 JSON。一次请求可以围绕同一份材料提出多个独立问题。
这和让模型自由写一篇分析报告,是两种不同的使用方式。程序负责流程,Jev 负责其中需要语言理解的小判断。
普通大模型当然也能分类,也有结构化输出和工具调用能力。因此,返回 JSON 本身不足以构成换模型的理由。
Jev 是否值得接入,要比较同样任务质量下的调用成本、等待时间,以及错误时能否得到合适的处理。本文的小测试用于看清用法,没有做与其他模型的性能排名。
先认识它的三种回答
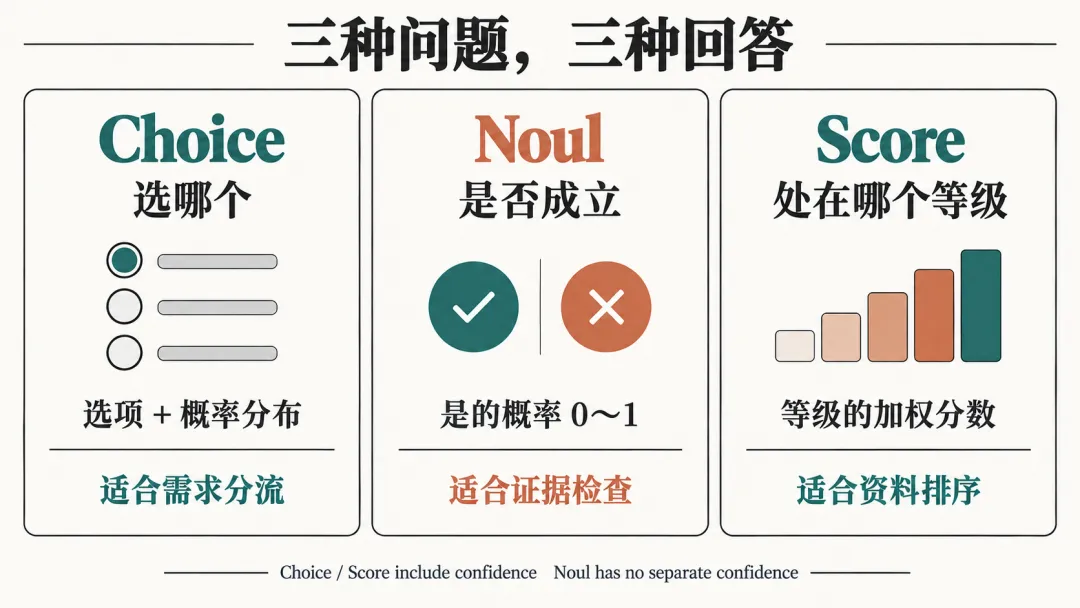
TypeSafe 提供三个基本类型。
Choice 适合单选。请求属于故障诊断、变更还是知识问答,就可以预先定义选项。
Noul 适合独立条件。用户是否要求重启,可以单独问。多个条件能够同时成立时,也可以分别判断,不必硬塞进一个互斥分类。
Score 要先定义有具体含义的等级。例如资料相关性可以从“完全无关”,排到“直接解释错误并给出针对性方法”。它的分数是等级位置的概率加权结果。Choice [https://docs.typesafe.ai/primitives/choice]、Noul [https://docs.typesafe.ai/primitives/noul]、Score [https://docs.typesafe.ai/primitives/score]
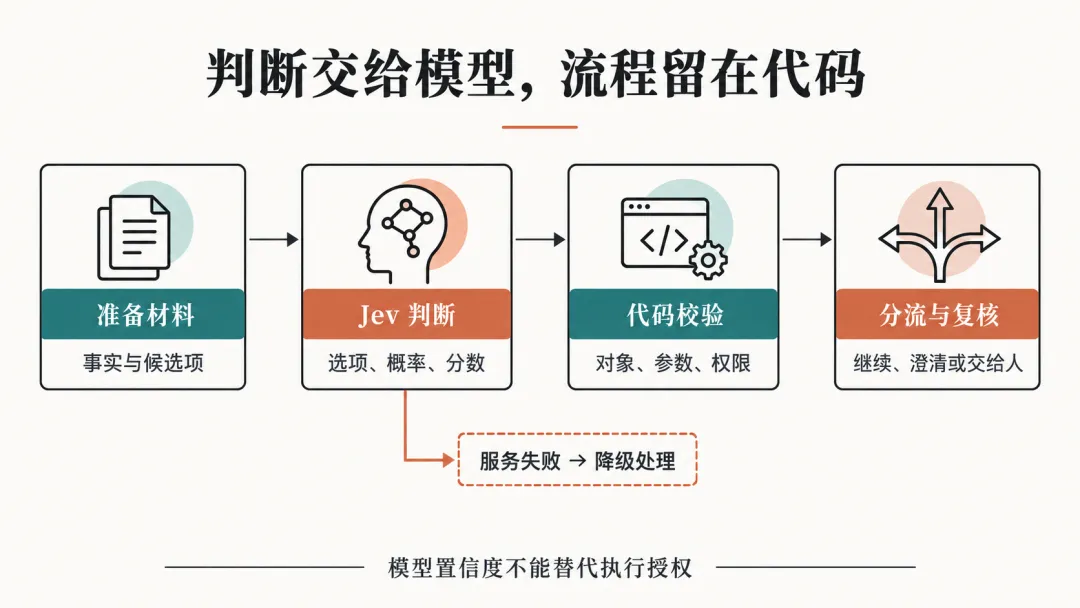
这几个类型最终都要接回应用。选了哪个入口、分数高低怎样影响展示,由代码决定。
社区案例里,最容易理解的是那些小功能
你不一定要先做一个完整 Agent,才能用上 Jev。
我看到的 Sponsor Skip 项目,把它用在了跳过 YouTube 口播赞助片段上。程序读取字幕,Jev 判断哪些内容属于赞助,并选择相关字幕行,程序再把行号映射为时间,执行跳转。
这里有个很实用的分工。时间戳由代码掌握,模型负责识别内容含义。音频模式还需要其他服务先转写,Jev 本身接收文字。Sponsor Skip 项目 [https://github.com/trungdq88/youtube-sponsor-detection]
用户提供的非官方案例库还收录了字段自动匹配和游戏伙伴演示。前者把名称不完全一致的字段对应起来,例如 photo 与 avatar;后者根据游戏状态选择行动意图。
这些是作者公开展示的用法,我没有安装复现,也不沿用帖子中的速度和费用倍数。它们提供的是场景线索。社区案例索引 [https://render.qmuse.pub/p/muse/8079593307628562/index.html]
类似的思路也能放进日常软件。
官方的使用场景也覆盖检索、分流和验证。落到具体产品里,先找一个反复出现的小判断,比直接追求“让 AI 接管流程”更容易验证价值。应用场景说明 [https://docs.typesafe.ai/concepts/use-case-map]
案例一,中文请求能不能分对入口
接下来是本次真实调用。所有输入均为构造材料,任务名“星河订单”为虚拟名称,没有使用生产日志,也没有执行重启或修改配置。
我为运维助手准备了四个入口,分别是诊断、变更、知识问答和先澄清。三条请求的结果如下。
第一条请求还同时问了一个 Noul 问题,用户是否明确要求现在执行重启。返回值为 0.02。
这说明在这条输入和当前问题定义下,模型对“明确要求重启”的判断概率很低。它没有仅因为出现“重启”两个字,就将其当成执行要求。
第三条更值得看。Jev 选择“先澄清”,返回的 confidence 为 1.0。
输入模糊,不一定让分类置信度降低。因为我已经把“对象或症状不清,需要先问清”定义成一个合法选项,模型可以很确定地选择它。
这也是为什么候选项设计重要。只有诊断和变更两个选项,应用就缺少一个表达“现在还不能决定”的出口。
这三条简单输入不能证明中文分类普遍可靠,但它们足够展示请求如何变成应用分支。
案例二,给诊断结论加一道证据检查
前面日志文章讨论过一个问题。只看到最后一小段没有错误,不能推导出整个作业从未报错。
我把这个场景整理成一份构造证据。
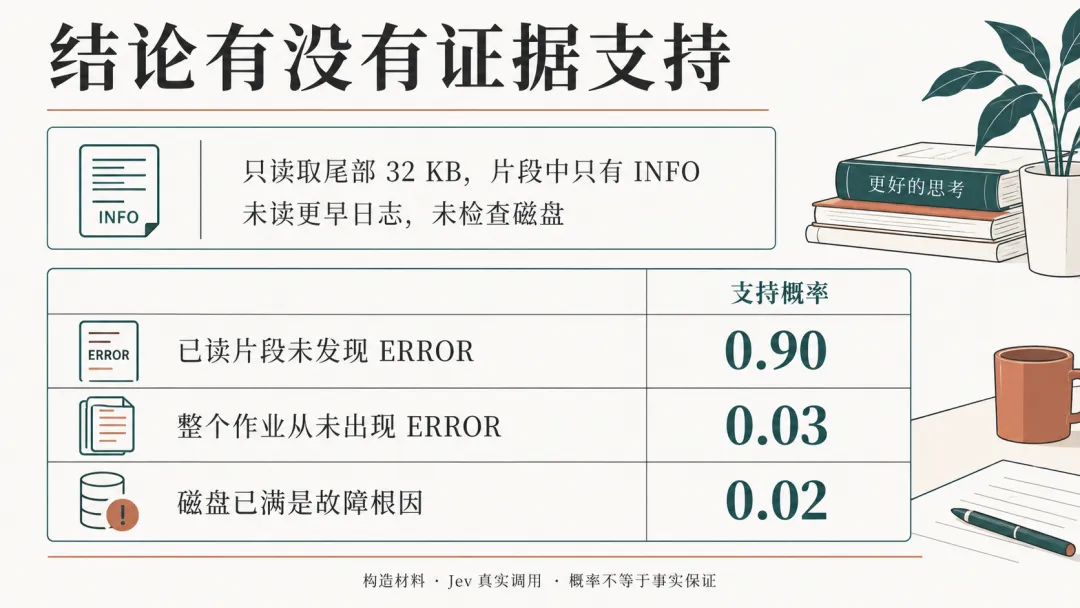
已读取星河订单作业最后32KB日志,所读片段只有INFO。未读取更早日志,未查询其他节点,未检查磁盘。随后在同一次请求中提交三个 Noul 问题,只问证据能否支持相应结论。
第一条保留了查询范围。第二条把局部观察扩成全局判断。第三条加入了材料里根本没有检查过的原因。
这组结果里,Jev 区分出了这些差别。
它可以作为诊断报告发送前的一次语义复核。发现支持不足的结论,程序标记出来,要求补充材料或交给人检查。这里的低概率表示缺少支持,不等于已经证明现实中的磁盘没有满。
官方也提供引用核验案例,先用普通字符串匹配检查引文是否存在,再交给模型判断上下文是否支持结论。能由程序精确完成的部分,仍然先用程序做。引用核验示例 [https://docs.typesafe.ai/cookbooks/citation_check]
这种检查也会误判。不能因为多接了一个模型,就把它当成绝对正确的裁判,更不能让它的单次高分替代生产变更审批。
案例三,把检索片段排出先后
第三个场景是知识库检索。
问题是 Flink 写入 HDFS 时出现配额拒写,需要优先查哪些资料。我准备了四段短材料,分别讲目录配额、Checkpoint 超时、Linux 磁盘空间和夜景摄影。
每段材料对应一个 Score 问题,使用相同的四档标准。最低档完全无关,最高档直接解释该错误并给出针对性检查方法。
四个问题合在一次调用里,结果如下。
配额材料排在第一,摄影材料排到最后。代码可以直接按分数排序,再选择要交给回答模型的片段。
中间那条磁盘材料也提醒我,排序仍有值得检查的地方。目录配额与文件系统空间并不等同,模型给它 1.67,可能使一段相邻主题进入候选集。
这不是一个标准检索评测,也没有给四段材料建立独立标注。它展示的是接入方式,同时保留了一个实际取舍,最终取前几条、是否设置最低相关性,都需要在自己的资料上验证。
另一个容易混淆的点是,Score 的 1.67 不是“答案有 167% 的把握”。它位于预先定义的等级轴上,confidence 和完整概率分布要分开看。
接进应用,需要准备哪几样东西
一次 Jev 请求主要有三个部分。
state 放材料,questions 放问题和标准,model 指定模型。下面是本次“是否要求重启”问题的独立调用示意。
{ "model": "jev-1.13.0", "state": { "message": "请先只读检查任务状态和日志,不要重启。" }, "questions": { "asks_restart": { "type": "noul", "instructions": "message 是否明确要求现在执行重启?被否定或禁止的重启不算要求。", "criteria": { "true": "明确要求执行重启", "false": "没有要求重启,或明确禁止重启" } } }}这个示意缩短了输入。前文的 0.02 来自完整案例,不能把它写成上述短输入必然返回的数字。
请求发送到官方的 POST /v1/systemone 接口。密钥留在服务端,通过认证请求头传递,不放进网页、文章或示例结果。接口文档 [https://docs.typesafe.ai/api]
独立问题可以一起问,但它们不能读取彼此的答案。如果后一个问题要用前一个结果去查新资料,就需要分成两次请求。
返回值也不直接等于执行权限。程序仍需校验对象、参数和授权;模糊请求进入澄清,服务失败进入降级路径。特别是重启、删除等动作,不能靠模型的概率决定是否获准执行。
这次调用花了多少,哪些数字先别夸大
五次调用全部成功,实际返回版本为 jev-1.13.0。接口累计报告 3,109 个输入 Token,273 个输出 Token。
官方当前标价为每百万输入 Token 0.042 美元,输出 Token 不收费。按这五次返回用量估算,模型输入费用约 0.00013 美元,不是账单结算金额。当前模型与价格 [https://docs.typesafe.ai/models]
本机记录的单次请求耗时约 0.85~1.73 秒,包含客户端等待与网络过程。它既不是服务端纯推理延迟,也不是经过重复采样的性能基准。
因此,本次能说的是调用开销很小、结果可以直接被程序使用。没有同条件的大模型对照,不能由此推出“快多少倍、便宜多少倍”。
正式接入还有几个限制需要知道。当前 Jev 只接收文本;英文是主要训练语言,中文需要单独评测。算术、精确计数和时间比较,应尽量留给代码。
官方也列出了复杂间接推理、无关长上下文和对抗性输入等问题。即使把 Jev 用作检查器,也要测试它自身被误导的情况。已知能力边界 [https://docs.typesafe.ai/model-jaggedness/jev-1.13]
Choice 和 Score 的 confidence 来自答案分布的集中程度,不是业务准确率。几条样本返回 1.0,也不代表上线后能保持全对。置信度说明 [https://docs.typesafe.ai/confidence]
我会先把它放在容易回看、容易纠正的位置,例如请求分流建议、候选资料排序和报告复核。复杂原因分析仍交给更完整的诊断流程。
如果你也想试 Jev,可以从每天反复做的一个小判断开始,准备明确、模糊和带否定表达的输入,看看它给出的答案怎样影响下一步。比起先造一个庞大的 Agent,这样更容易看清它到底帮上了什么。