ARTICLE · 1061469
酶工程的“AI时刻”:AlphaFold2解析结构、RFdiffusion生成骨架、ProteinMPNN设计序列——从“分析自然”到“编程自然”的完整路线图

人工智能(AI)的快速成熟正在催化生物催化领域的根本性转变,从结构分析走向对定制酶的处方式设计。本综述综合了这场AI驱动的革命,评估了AlphaFold2和CLEAN等突破性技术如何桥接序列与催化特性(包括动力学参数和底物特异性)。文章批判性比较了理性设计策略,对比了进化引导的重新设计与新兴的生成式从头设计范式(其中扩散模型和蛋白质语言模型探索未表征的序列空间)。通过剖析图神经网络和Transformer等算法,阐释了它们在破译蛋白质化学"语法"中的作用。基于工业案例,展示了AI如何克服稳定性-活性权衡等瓶颈。最后,描绘了通向自主生物铸造厂和虚拟细胞建模的轨迹,展望了将工程化生物催化剂系统整合到复杂代谢网络中的未来,为下一代计算生物催化提供路线图。
结构预测革命:AlphaFold2和RoseTTAFold2实现原子级精度结构预测,弥合了持续数十年的结构覆盖缺口,使元基因组未表征酶(如非特异性过氧酶UPOs)的高保真建模成为可能。
动力学参数预测突破:DLKcat和PreKcat等深度学习框架可从底物结构和蛋白质序列预测kcat/Km值,实现代谢酶全基因组规模参数化,解释数百个物种的表型差异。
功能注释新范式:CLEAN(对比学习酶注释)算法利用对比学习框架将酶嵌入功能空间,在同工酶聚类和识别传统序列比对遗漏的混杂活性方面显著优于BLASTp。
从头设计(De Novo)范式兴起:RFdiffusion利用去噪扩散概率网络生成满足特定功能约束的蛋白质骨架,配合ProteinMPNN进行序列设计,实现"从零编程"非天然反应催化剂,探索"暗物质"序列空间。
稳定性-活性权衡破解:iCASE(等温压缩辅助动态挤压指数扰动工程)和DCCNA(动态交叉相关网络分析)等策略通过识别远端突变位点和动态网络,实现热稳定性与催化活性的协同提升,而非简单牺牲一方。
柔性区工程化策略:提出"柔性区位移"(Flexible Region Shifting)新概念,通过重新定位柔性环区而非简单刚性化,在保持催化所需构象熵的同时提升热稳定性(如纳豆激酶半衰期延长20.7倍且催化效率翻倍)。
工业级多目标优化:AI辅助的酶设计成功应用于塑料降解(PET水解酶)、手性药物中间体合成(Vibegron中间体)、食品级蛋白谷氨酰胺酶改造等工业场景,实现从"实验室优化"到"工业放大"的跨越。
从局部到全局的设计范式转变:从早期基于B因子的局部柔性分析,转向动态网络分析和上位性网络分析,识别远端"枢纽"残基进行别构调控,实现酶的系统性重塑。
多模态数据整合趋势:当前前沿模型(如ESM-3)整合一维序列、二维残基接触和三维结构数据,形成对酶生物学的"双重视角"(进化语法+活性位点几何句法)。
自主生物铸造厂路线图:提出闭环"设计-构建-测试-学习"(DBTL)循环与机器人平台整合的未来愿景,AI作为实验室管理者主动规划实验,最大化信息增益,加速探索蛋白质序列空间的"暗物质"区域。
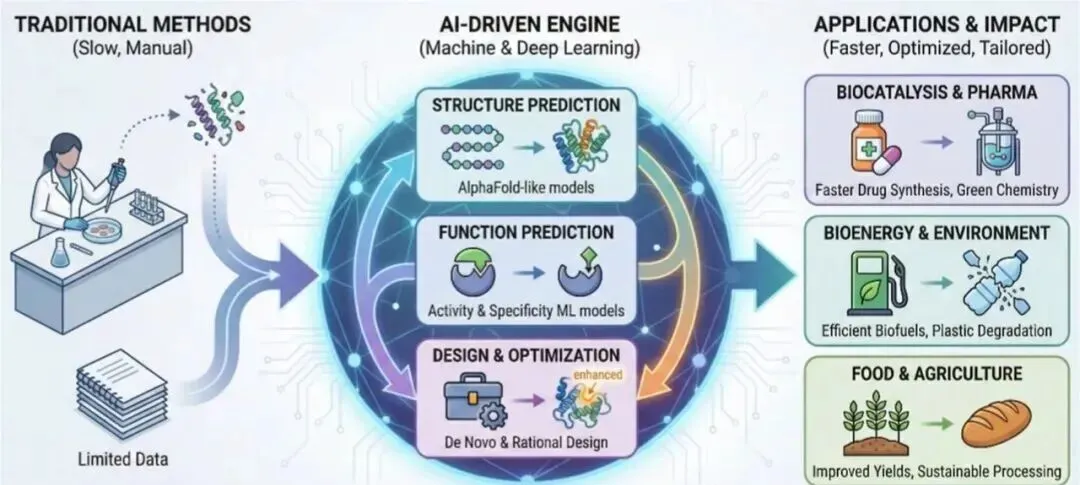
Figure 1 | AI在酶工程中的应用:从预测到设计
酶工程从传统实验方法向AI驱动范式的转变,以及由此产生的三大应用领域的变革。
左侧:传统方法(Traditional Methods)
以实验科学家手持移液器、培养皿和堆叠纸质记录为视觉符号,表征"慢速、手动、依赖有限数据"的经验性研究范式。这代表了定向进化时代的高通量筛选瓶颈——依赖随机突变和劳动密集型实验表征。
中部:AI驱动引擎(AI-Driven Engine)
以电路板纹理的圆形核心表示机器学习与深度学习的计算核心,内部包含三个递进层次:
结构预测(Structure Prediction):AlphaFold类模型实现从序列到三维结构的映射,打破实验结构生物学的时间瓶颈;
功能预测(Function Prediction):基于ML模型的活性与特异性预测,建立序列-结构-功能的三元关联;
设计与优化(Design & Optimization):整合从头设计(De Novo)与理性设计(Rational Design),实现从"分析自然"到"编程自然"的跃升。
右侧:应用领域与影响(Applications & Impact)
展示AI赋能后的三大产业方向:
生物催化与制药:加速药物合成(如Vibegron中间体手性合成)、推动绿色化学;
生物能源与环境:高效生物燃料生产、塑料废弃物降解(PET水解酶);
食品与农业:提升作物产量、可持续食品加工(如低聚半乳糖GOS生产)。
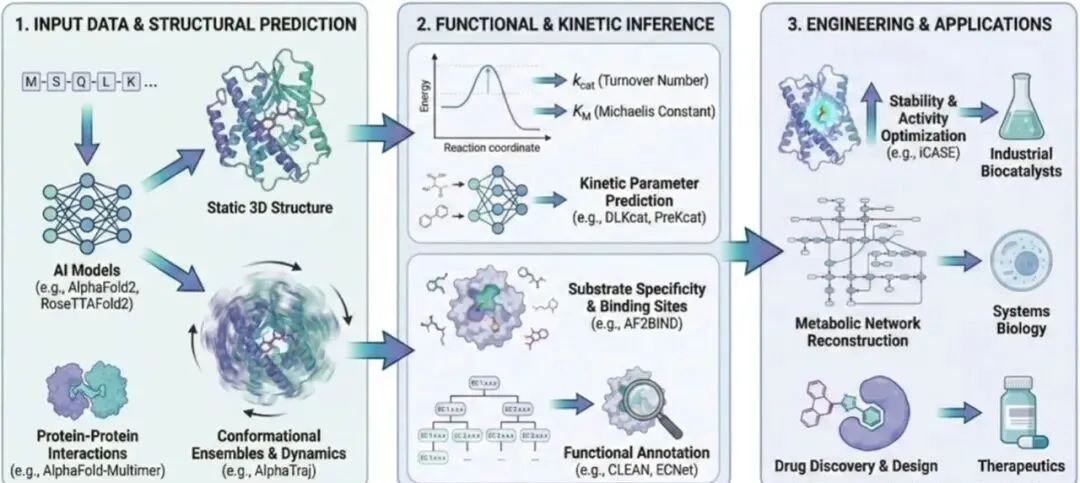
Figure 2 | AI驱动的酶分析:从序列到动态功能与应用
梳理了从原始序列输入到工业应用的完整AI分析管线,分为"结构预测→功能推断→工程应用"三大逻辑模块。
模块1:输入数据与结构预测(Input Data & Structural Prediction)
序列输入:以氨基酸单字母代码(M-S-Q-L-K...)表示一级序列信息;
AI模型处理:通过AlphaFold2/RoseTTAFold2等深度学习架构,将一维序列转化为静态3D结构;
多尺度扩展:蛋白质-蛋白质相互作用(AlphaFold-Multimer),预测跨物种(如植物-病原体界面)的复合物结构;构象集合与动态(AlphaTraj),超越静态快照,模拟蛋白质的动态构象变化,识别底物进入和产物释放的过渡态。
模块2:功能与动力学推断(Functional & Kinetic Inference)
动力学参数预测:DLKcat和PreKcat等工具从能量景观图(反应坐标vs能量)预测kcat(转换数)和Km(米氏常数),实现代谢网络重建的数字化;
底物特异性与结合位点:AF2BIND等工具利用AlphaFold2的内部配对表征预测配体结合位点,无需共晶小分子的先验信息;
功能注释:CLEAN和ECNet等算法通过对比学习与进化上下文整合,实现从序列到酶学编号(EC number)的精准映射。
模块3:工程与应用(Engineering & Applications)
稳定性与活性优化:iCASE等策略针对稳定性-活性权衡进行系统优化;
工业生物催化剂:面向生物能源、制药和食品工业的定制化酶设计;
系统生物学整合:从单酶设计扩展到代谢网络重建,最终实现药物发现与治疗应用的闭环。
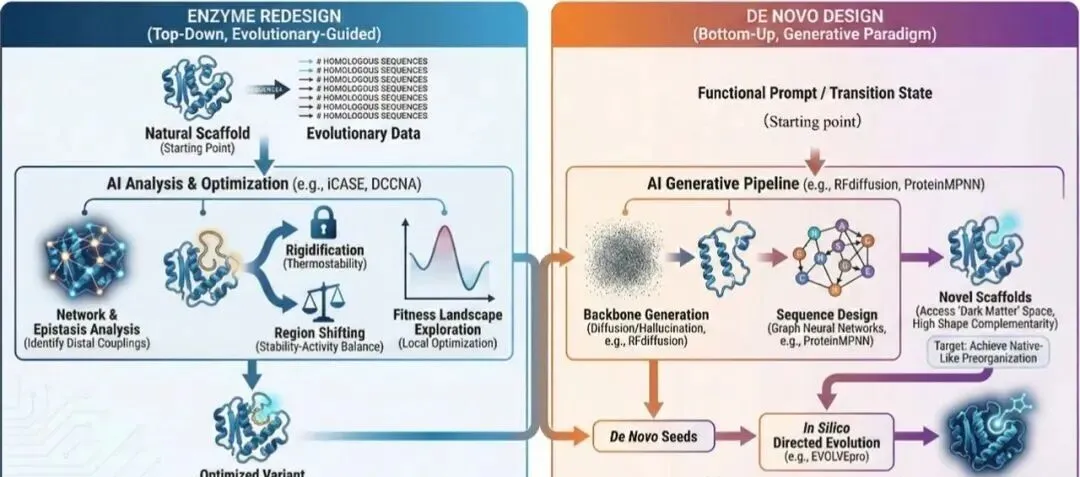
Figure 3 | AI理性酶设计:导航适应度景观
对比了两种AI酶设计范式——"重新设计(Redesign)"与"从头设计(De Novo Design)",并展示其融合趋势。
左侧:酶重新设计(Enzyme Redesign,自上而下,进化引导)
起点:天然骨架(Natural Scaffold)作为"现成"模板,结合同源序列的进化数据;
AI分析与优化策略:网络与上位性分析(Network & Epistasis Analysis),识别远端耦合残基,解析动态网络中的别构信号传递;刚性化(Rigidification),针对高B因子区域进行刚性化改造以提升热稳定性;区域位移(Region Shifting),通过迁移柔性区位置平衡稳定性与活性,避免"刚性致死"(catalytically dead);
输出:优化变体(Optimized Variant),实现渐进式改进(Incremental Improvement),主要解决稳定性-活性权衡难题。
右侧:从头设计(De Novo Design,自下而上,生成式范式)
起点:功能提示/过渡态(Functional Prompt/Transition State)作为化学需求的抽象表征,而非自然模板;
AI生成流程:骨架生成(Backbone Generation),RFdiffusion等扩散模型通过去噪/幻觉技术生成满足功能约束的原始骨架;序列设计(Sequence Design),ProteinMPNN等基于图神经网络的模型将骨架转化为可折叠的氨基酸序列;
产物:新型骨架(Novel Scaffolds),进入"暗物质"序列空间(高结构互补性,目标实现天然样预组织);
后续优化:通过计算定向进化(如EVOLVEpro)打磨为工业级生物催化剂。
底部:未来方向——混合合成(Hybrid Synthesis)
指出两种范式的融合趋势:利用从头设计生成"种子"骨架,再通过重新设计策略进行局部优化,结合两者优势以突破当前的功能天花板。
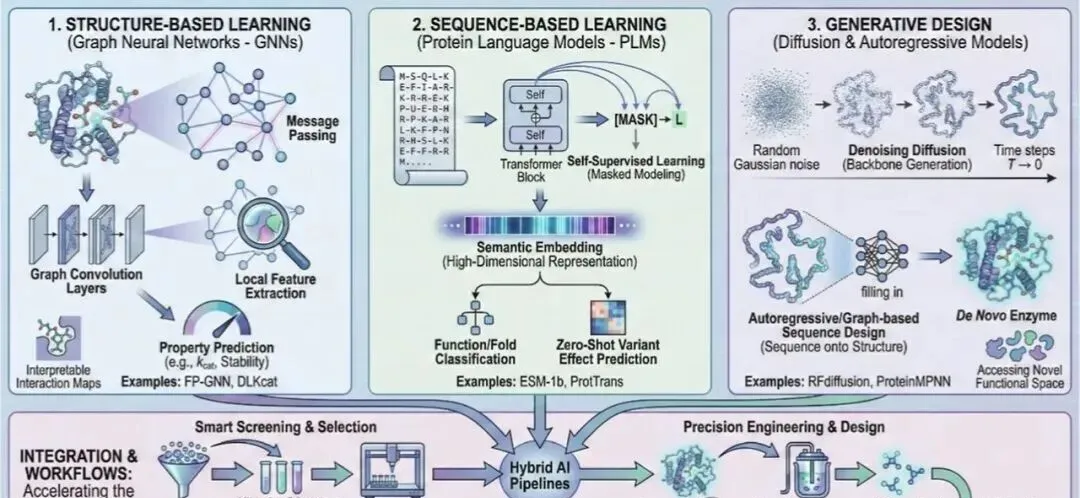
Figure 4 | AI算法与工具:从结构、序列到生成式设计
支撑AI酶工程的三大算法范式及其整合工作流。
范式1:基于结构的学习(Structure-Based Learning,GNNs)
核心架构:图神经网络(Graph Neural Networks),将蛋白质视为拓扑图(残基为节点,相互作用为边);
机制:通过消息传递(Message Passing)和图卷积层(Graph Convolution Layers)提取局部特征;
应用:属性预测(如kcat、稳定性),示例工具包括FP-GNN(结合分子图与指纹)和DLKcat(CNN/GNN混合架构);
优势:保持置换不变性,生成了可解释的相互作用图谱。
范式2:基于序列的学习(Sequence-Based Learning,PLMs)
核心架构:蛋白质语言模型(Protein Language Models),采用Transformer自监督学习(掩码建模);
机制:将序列视为"句子",残基视为"词",通过自注意力机制捕获长程依赖,生成高维语义嵌入(Semantic Embedding);
应用:功能/折叠分类、零样本变异效应预测(无需实验数据即可预测突变影响),示例包括ESM-1b和ProtTrans。
范式3:生成式设计(Generative Design,扩散与自回归模型)
扩散模型:从随机高斯噪声开始,通过去噪扩散过程(Denoising Diffusion)生成骨架(如RFdiffusion);
序列填充:通过自回归或图基序列设计(如ProteinMPNN)将骨架填充为完整序列;
产出:从头酶(De Novo Enzyme),探索新型功能空间。
底部:集成与工作流(Integration & Workflows)
混合AI流程(Hybrid AI Pipelines)如何实现DBTL(设计-构建-测试-学习)循环的加速:
智能筛选与选择:虚拟文库→高置信度命中→机器人液体处理;
精准工程与设计:混合AI流程输出设计的酶→定制化生物催化剂;
反馈循环:实验数据回流优化模型,形成闭环自治系统。
会议地点:济南(具体地点直接通知报名单位)
会议时间:2026年10月23日-25日(23日全天报到)
10月23-25日 上午9:00-12:00 ,下午13:30-16:30 个人本地电脑基础配置(全程基础实操可用) 适用场景:分子对接预处理、结构可视化、轨迹预处理、AlphaFold3在线预测、NRIMD网页端分析、数据结果统计与绘图、理论案例学习 配置要求: 1. 系统:Windows 10/11 或 Linux、macOS 系统 2. 处理器:Intel i5/R5 及以上 3. 内存:16G 及以上 4. 硬盘:空闲存储空间 ≥50G 5. 网络:稳定高速网络会场独立网络(满足在线服务器、网页工具访问需求) 6. 预装软件:PyMOL、常规办公及数据处理软件 |
第一天:酶生物元件智能挖掘与催化作用机制解析 一、大数据驱动的生物元件与新酶智能挖掘实战 1. 酶序列与结构特征工程提取:物理化学特征、2D/3D分子指纹与表征嵌入(Embeddings)提取 2. 机器学习新酶预测模型构建:搭建经典分类模型,从海量未表征基因组中高通量筛选潜在高活性、高选择性新酶 二、全原子动力学模拟与催化结合自由能精准量化 1. Amber分子动力学标准工作流实操:酶-底物复合物体系构建、力场拓扑分配、溶剂化、能量最小化及多阶段热力学平衡 2. 动力学轨迹稳定性与构象监测:RMSD、RMSF(局部柔性)、回旋半径(Rg)及催化活性中心空间构象稳定性分析 3. 高斯加速增强采样(GaMD)高级应用:跨越能垒捕获底物诱导契合构象,绘制自由能形貌图(FEL)并提取代表性催化构象 4. MMPBSA/MMGBSA结合自由能解析:底物亲和力能量项定量评估,执行逐残基能量分解以锁定关键催化氨基酸贡献 三、酶-底物相互作用机制与反应通道动力学分析 1. 拉伸分子动力学(SMD)模拟搭建:定义底物拉伸反应路径,模拟底物进出活性口袋的动态通量与能垒变化 2. 通道瓶颈与选择性残基识别:精准定位限制底物通量及立体催化选择性的通道关键残基 第二天:AI驱动的酶理性改造、别构调控与生成式设计 四、AI高精度结构建模与长程别构传导通路网络解析 1. AlphaFold3复杂体系建模实操:酶单体、多聚体及“酶-底物/辅因子”复合物的高精度三维结构预测 2. 结构置信度与构象评估:pLDDT/PAE多维度参数判读与活性口袋结合构象可靠性验证 3. 图神经网络(NRIMD)动力学别构分析:基于神经关系推理(NRI)模型,利用轨迹数据推断残基动力学耦合模式与互作网络 4. 远端调控关键突变位点锁定:识别活性中心至远端结构域的别构传导路径,突破近活性中心局限,定位驱动酶活性提升的关键远端残基 五、蛋白质大语言模型与AI生成式酶改造实战 1. 蛋白质大语言模型(Prot-LLM)微调生成:基于特定酶家族序列微调 ProtGPT2/ProGen2 模型,实现酶催化活性与表达量序列的定向条件生成 2. ProteinMPNN功能位点重构与序列优化:固定核心催化残基,对活性口袋周边与表面残基进行序列重新设计以提升催化效率与耐受性 3. RFdiffusion从头生成新型抗体骨架结构:设置活性位点几何约束(Motif Scaffolding),从头生成新型空间折叠骨架 |
1. 科研与高校群体:生物化学、酶工程、计算生物学方向的研究生/青年教师,以及生物信息学研究人员,聚焦“实验+计算+AI”的复合研究能力提升。
2. 产业研发人员:生物制药、精细化工、食品工业的酶制剂研发工程师,合成生物学团队核心成员,医药企业计算生物学/结构生物学部门人员,聚焦酶改造技术的产品研发效率提升。
3. 跨领域从业者:AI+生物交叉领域的算法工程师/数据科学家,生物科技公司技术负责人,聚焦AI与酶工程技术的融合应用与产业化落地。
4000元/人,同一企业三人以上报名3500元/人,(含会务费、资料费、会议期间中餐等)住宿统一安排,费用自理。
汇款信息:
1)对公银行汇款至
户 名:中科凯晟(北京)化工技术研究院
开户行:中国工商银行北京玉泉路支行
账 号:020 006 300 920 008 7710
2)也可以通过在线报名直接支付或线下支付宝/微信转账
支付宝帐号:info@chem-bang.com
微信号:chembangpub
扫描下方二维码
即可快速报名
电话:0571-87607694
微信:CHEMBANGPUB
邮箱:info@chem-bang.com
点击下方“阅读原文”也可参与活动报名