ARTICLE · 1062255
需求文档一键变测试用例:手工用例智能生成平台
从一份几十页的需求文档,到一套结构完整、可评审、可交付的手工测试用例,过去可能要花测试同学一两天。现在,只需要五步、几分钟。
今天给大家介绍我们最近开发的一个平台——TestCaseMind 手工测试用例智能生成平台。它把大模型的理解与生成能力,和测试设计的专业流程结合起来,让"读需求、想场景、写用例、评审改稿"这件事变得前所未有的轻松。
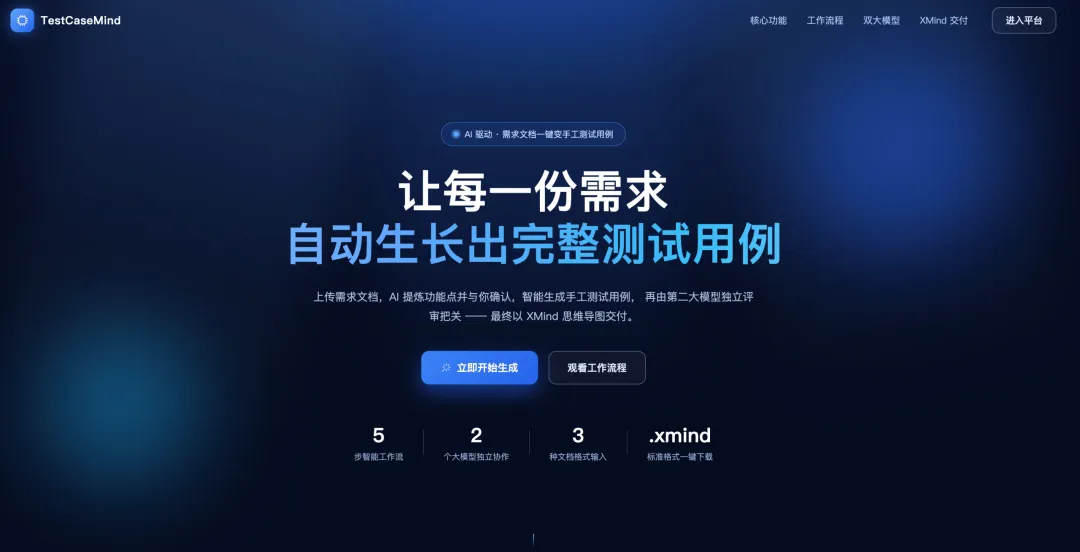
这篇文章会讲清楚三件事:它能做什么、它是怎么设计的、为什么这样选型。
一、先说说痛点
做过测试的同学都熟悉这样的场景:
需求文档几十页,要反复读好几遍才能理清功能点; 写用例时容易遗漏异常和边界场景,质量高度依赖个人经验; 用例写完还要评审、返工、再评审,来回沟通成本高; 最终交付到团队手里,格式不统一,导入测试管理工具还要重新整理。
大模型出现后,很多人尝试直接把需求丢给它:"帮我写测试用例"。结果往往是——能写,但不可控。功能点漏没漏不知道,用例合不合格没人把关,输出结果也难以直接用于正式交付。
我们想做的,不是一个"一问一答"的对话框,而是一条人机协同、关键节点可确认、质量有第二道关卡、成果可标准交付的完整流水线。
二、平台能做什么:五步工作流
平台把整个用例设计过程拆成五个清晰的步骤,每一步都由 AI 执行、由人来拍板。
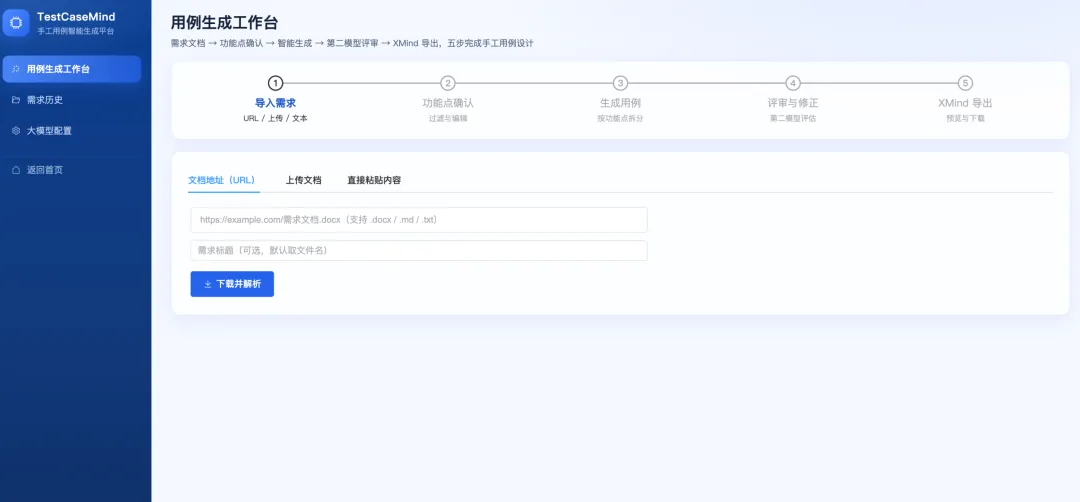
第一步:导入需求,三种方式任选。你可以给一个需求文档的 URL 地址让平台自动下载,也可以直接上传本地文件,或者干脆把内容粘贴进来。目前支持 Word(.docx)、Markdown(.md)和 TXT 三种格式,Word 文档会自动识别标题层级和表格内容。
第二步:功能点提取与确认。AI 通读需求后,会过滤掉背景介绍、术语解释等"水分",提炼出真正需要测试的功能点,并给出每个点的描述。这一步不会直接往下走,而是把功能点列表交给你:可以新增、删除、修改名称和描述,也可以勾选哪些功能点参与用例生成。需求理解得对不对,你说了算。
第三步:按功能点智能生成用例。确认之后,平台会围绕每个功能点拆分需求内容,定位到相关段落作为上下文,生成标准化的手工测试用例。每条用例都包含:用例标题、优先级(P0–P3)、用例类型(功能 / 异常 / 边界等)、前置条件、操作步骤、预期结果。正常流程、异常场景、边界条件都会被覆盖。
第四步:第二个大模型独立评审。这是平台很关键的设计——生成之后,不是直接交付,而是交给另一个独立的大模型以"第二方"视角逐条评审打分,满分 100,低于 75 分判定为不符合要求,并给出具体的改进意见。对于不合格的用例,你可以勾选后让平台结合评审意见一键重新生成,且自动再次评审,直到满意为止。
第五步:XMind 思维导图交付。最终用例以思维导图形式在页面上呈现,层次为"需求 → 功能点 → 用例 → 字段",评审结果也会标注在节点上。确认无误后,一键即可下载标准的.xmind 文件,用 XMind 打开就能直接用于团队评审和归档。
整条流程走下来,人只需要做两次关键确认(功能点、不合格用例),其余都交给 AI,但控制权始终在人手里。
三、系统架构:前后端分离 + 分层服务
平台采用典型的前后端分离架构,整体分为四层。
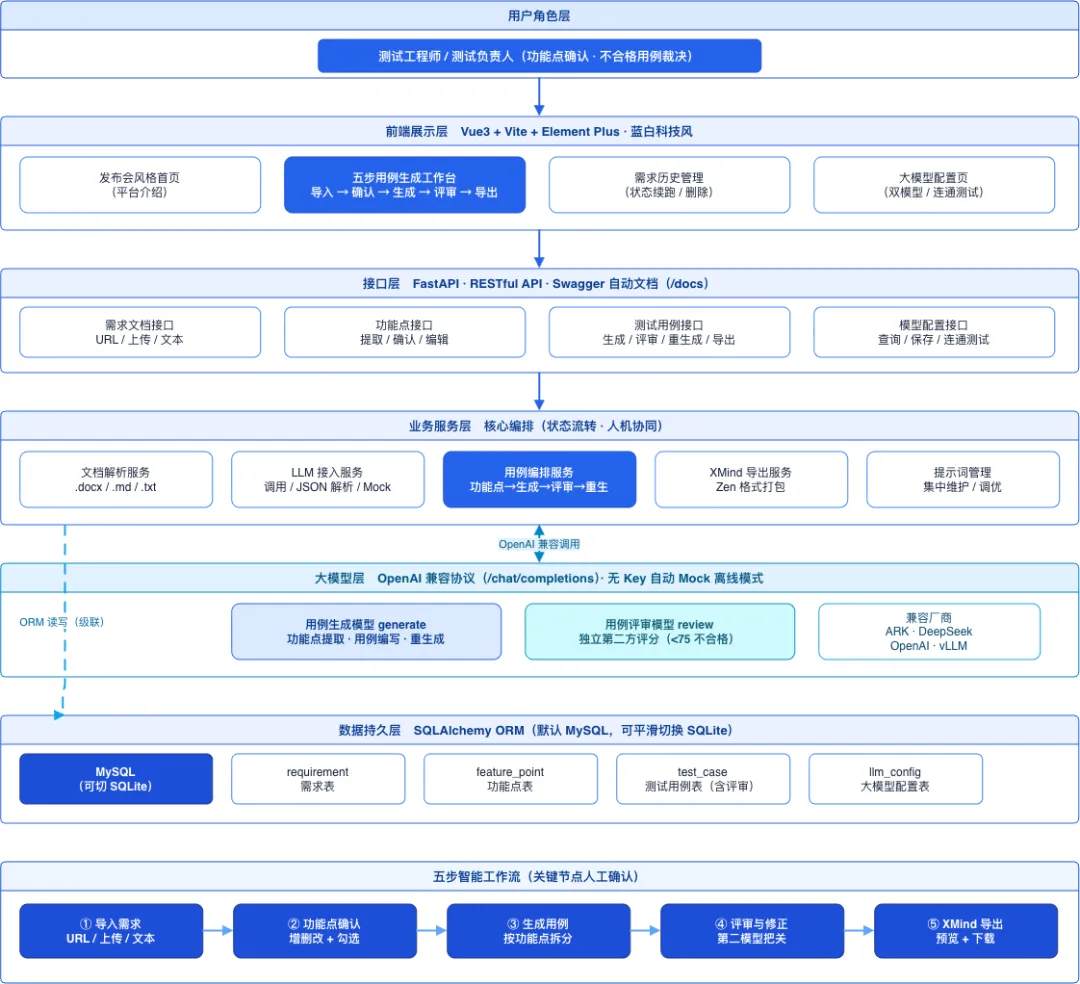
前端展示层基于 Vue3 构建,是一个单页应用,包含发布会风格的产品首页、五步用例生成工作台、需求历史管理和大模型配置四个主要界面。
接口层使用 FastAPI 提供 RESTful 接口,按业务域拆分为需求、功能点、用例、模型配置四组路由,并自动生成 Swagger 接口文档,方便联调与二次开发。
业务服务层是平台的核心,每个模块职责单一:文档服务负责下载与多格式解析;LLM 服务负责对接大模型并解析输出;用例编排服务负责功能点提取、生成、评审、重生成的完整状态流转;XMind 服务负责思维导图的构建与文件打包;提示词则集中在独立模块统一管理,便于持续调优。
数据持久层通过 SQLAlchemy ORM 操作数据库,共设计四张表:需求表(requirement)、功能点表(feature_point)、测试用例表(test_case)和大模型配置表(llm_config)。表之间通过外键关联,删除需求时其功能点和用例会级联清理。
此外,平台用一个状态字段贯穿需求的全生命周期(已导入 → 功能点已确认 → 用例已生成 → 已评审),关闭页面后再回来,可以从上次的步骤继续,不会丢失上下文。
四、技术选型:为什么是它们
后端选择 Python + FastAPI。Python 在 AI 生态上的优势不言而喻,而 FastAPI 自带异步支持、基于类型注解的数据校验和自动接口文档,性能出色、代码简洁,非常适合这类需要频繁调用大模型、IO 密集的服务。
大模型对接采用 OpenAI 兼容协议。我们没有绑定任何一家厂商,而是直接按 OpenAI 接口规范调用 /chat/completions。这意味着火山方舟(ARK)、DeepSeek、OpenAI、通义千问,乃至本地部署的 vLLM、Ollama,只要提供兼容接口都可以无缝接入。
生成模型与评审模型分别配置、相互独立。这是平台最重要的设计决策之一。两者可以用同一个模型,也可以跨厂商组合——比如用一个擅长生成的模型写用例,再用另一个推理严谨的模型做评审,形成真正意义上的"交叉验证",避免"既当运动员又当裁判"。每个模型的 Base URL、API Key、模型名称、温度系数都可以在配置页单独设置并做连通测试。
数据库默认 MySQL,可平滑切换 SQLite。正式环境使用 MySQL,稳定可靠、团队熟悉;得益于 ORM 的抽象,本地想快速体验时,只需改一个连接串就能换成零配置的 SQLite,无需安装数据库。
前端选择 Vue3 + Vite + Element Plus。Vue3 的组合式 API 让复杂的工作流状态管理更清晰,Vite 带来极快的开发体验,Element Plus 提供成熟的企业级组件。视觉上我们设计了统一的蓝白科技风,并为产品定制了深色舞台风格的发布会首页。
五、两个特别贴心的设计
零门槛的 Mock 模式。如果暂时没有大模型的 API Key,平台会自动识别并降级到 Mock 模式——功能点提取、用例生成、第二模型评审、不合格返工全流程都可以离线完整跑通。这对演示、教学和前端联调非常友好,等拿到 Key 后在配置页填上即可无缝切换到真实模型。
工程级的 XMind 文件生成。.xmind 本质上是一个包含 content.json 的压缩包,平台严格按照 XMind Zen 格式组装,导出的文件不是"长得像",而是可以被 XMind 正式识别和编辑的标准文件,用例的优先级还会自动映射为思维导图中的优先级标记。
六、适合谁用
如果你是测试工程师,它可以帮你从繁琐的用例编写中解放出来,把精力放在场景设计和质量判断上;如果你是测试负责人,它能统一团队的用例产出标准,评审环节也更有据可依;如果你在学习 AI Agent 开发,这个项目本身就是一个很好的实战案例——它完整展示了"工具调用 + 人机确认 + 多模型协作 + 结构化交付"的典型智能体流水线是如何落地的。
写在最后
大模型真正改变测试工作的方式,不是简单地替我们"写点东西",而是把专业流程重新组织一遍:AI 负责处理信息和生成草稿,人负责关键决策和质量把关,系统负责流程衔接和标准交付。
TestCaseMind 就是按照这个理念做的一次实践。从需求文档到思维导图,五步、几分钟、两个模型协同,让一套高质量手工用例的诞生变得自然而然。
如果这个项目对你有启发,欢迎点个"在看"并转发给身边的测试同学。想要平台源码的同学,也欢迎关注留言。