ARTICLE · 1068668
数据篇 -- PDF / Markdown / 网页:文档怎么装进系统
💡 摘要:同样叫「加载文档」,PDF、Markdown、网页其实走的是三条完全不同的路。本文对比主流加载器怎么选型,以及 Unstructured 这类工具如何把杂乱格式对齐成可检索语料。
你以为数据准备的第一步是「读文件」——打开一看,却发现:
Markdown 很干净,标题层级齐全 PDF 把表格拧成一行乱码 网页抓回来一半是导航栏和广告
格式不同,进系统的姿势就不同。加载器选错,后面分块、嵌入、检索全在帮倒忙。
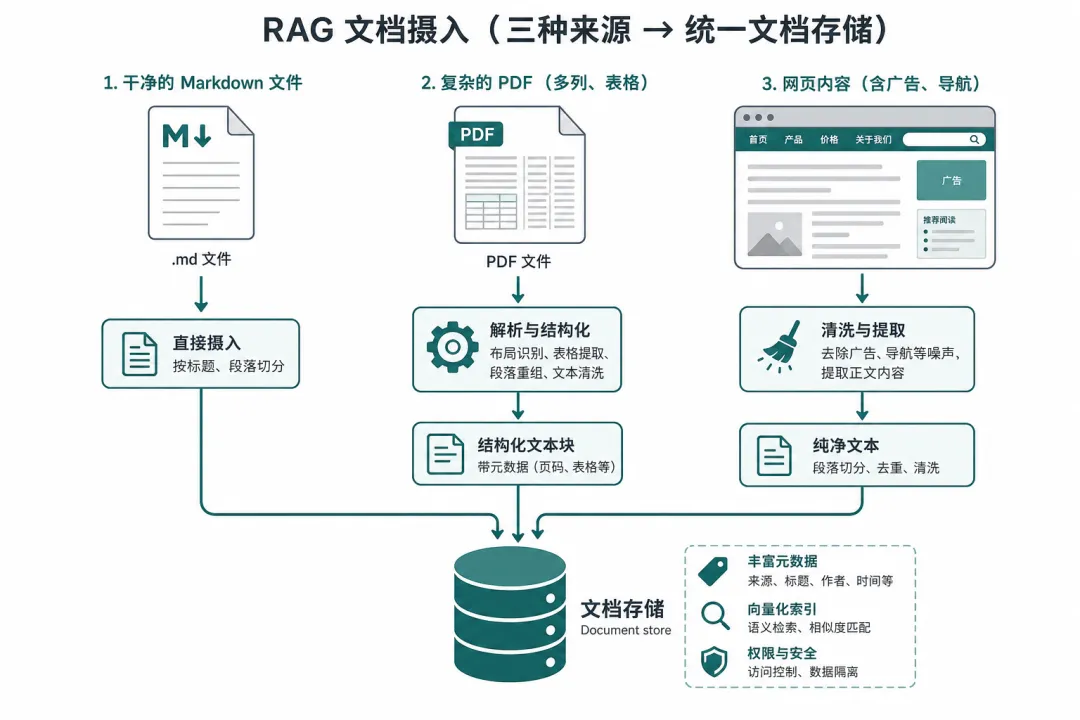
图1|Markdown 直通、PDF 要深解析、网页要先洗再存
加载器到底在干什么
不管你用 LangChain、LlamaIndex,还是直接调 Unstructured,加载这一步通常要完成三件事:
解析:把 PDF / Word / HTML / Markdown 变成可处理的文本(尽量保住标题、表格、列表) 抽元数据:来源路径、页码、作者、章节标题等 统一结构:变成框架认得的 Document/Element,方便后面切分、向量化、入库
这和传统 ETL 是一类活:把杂乱原始资料,对齐成适合检索的标准语料。「能打开文件」≠「能进 RAG」——后者要求结构可读、噪音可控、元数据可用。
三种格式,三种处理
| Markdown / TXT | |||
| 网页 / 在线文档 |
Markdown:最省心的「原生语料」
技术文档、内部 Wiki、很多知识库导出,最终都是 Markdown。对 RAG 来说,它几乎是理想输入:
#/##就是天然的章节边界代码块、列表结构清楚 很少有页眉页脚污染
实践上,用 TextLoader、UnstructuredMarkdownLoader 一类轻量工具即可。真正要小心的是:编码是否正确、单文件是否过大、标题层级是否被乱用(六个 # 乱飞,后面按标题分块会翻车)。
PDF:企业知识库的「主战场」
合同、论文、制度、产品手册——大量仍是 PDF。难点不在「读出字」,而在版面理解:
双栏排版被读成左右交错 扫描件没有文字层,必须 OCR 表格被拍扁成一行,数字对不上条款 页眉、页脚、水印混进正文
所以 PDF 加载器差别巨大:轻量提取 vs 版面重建,效果可以差一个数量级。
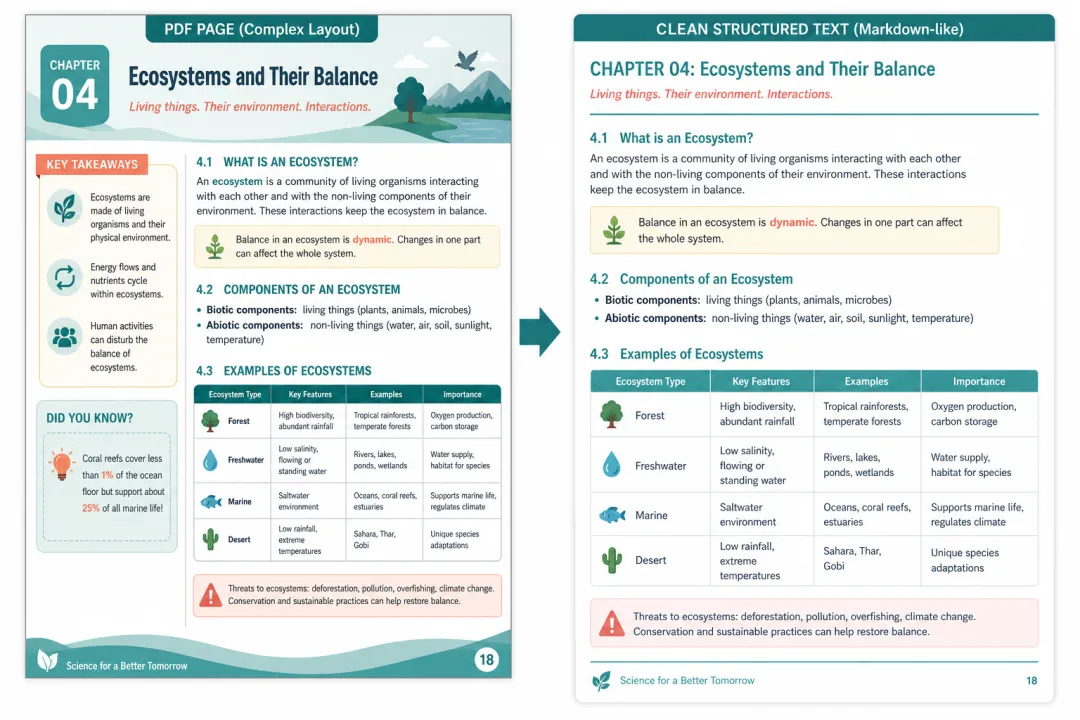 图2|好的 PDF 加载器要保住标题、段落与表格结构
常见方向可以这么记:
选型口诀:拿你们库里最难的 3 份 PDF(带表格、双栏、扫描)做 A/B,看标题是否断、表格是否还像表、页眉是否进正文——通过再谈批量入库。
网页:先抓正文,再谈入库
产品文档站点、帮助中心、新闻、飞书/语雀导出页……网页是「活知识」的重要来源。但 HTML 天生嘈杂:导航、侧边栏、推荐卡片、脚本标签,都会污染语料。
常见做法:
用 FireCrawl 等工具抓取,尽量只要正文 清洗:去导航、去脚注噪音、统一编码 落盘成 Markdown / 纯文本后再走分块
网页还有一个隐患:今天抓到的,明天可能变。若业务强依赖在线页,要考虑定时更新、版本元数据(抓取时间、URL),否则库里会悄悄过期。
Unstructured:一种「统一接口」思路
当资料库里同时有 PDF、Word、HTML、Markdown,为每种格式各写一套解析,维护成本很高。Unstructured 这类库的价值,就是提供相对统一的入口:自动识别格式,把内容拆成带语义标签的元素(Elements)。
常见元素类型包括:
Title | ||
NarrativeText | ||
ListItem | ||
Table | ||
HeaderFooter | ||
CodeSnippet |
「先分区成元素,再组块」——比「整页糊成一大段纯文本」更接近人读文档的方式。你后面按标题分块、过滤页眉、单独处理表格,都建立在这些标签上。
一个最小直觉示例(直接用 Unstructured):
from unstructured.partition.auto import partitionfrom collections import Counterelements = partition( filename="rag.pdf", content_type="application/pdf",)print(len(elements), "个元素")print(Counter(e.category for e in elements))for e in elements[:5]:print(e.category, "→", str(e)[:80])跑完先看两件事:元素类型分布是否合理、抽几段给人读是否像正文。若大量 Header/Footer,或 Table 内容一塌糊涂——先别入库,先换策略(如 PDF 走 hi_res / OCR,或换专门 PDF 工具)。
partition 还有几个实战里常动的旋钮:
strategy="fast" | |
strategy="hi_res" | |
ocr_only | |
include_page_breaks |
同一份 PDF,fast 和 hi_res 解析结果可以差很多——别只看跑通,要看抽出来的字像不像人读的文档。需要更细的 PDF 控制时,也可直接走 partition_pdf,而不是通用 partition 自动路由。
团队里最常见的三种翻车
「能提字」当成「能进库」程序没报错,库里却是页眉 + 目录 + 半截表格。验收标准必须是人读抽样。
一种 Loader 打天下Markdown 用对了工具,不代表合同 PDF、帮助中心网页也能用同一套。格式变了,链路就要重评。
元数据后天补上线后才发现没法按部门/版本过滤,只好全库重跑。
source、日期、页码/URL,第一天就要进metadata。
怎么选:一张对照表
没有万能加载器,只有贴合格式的流水线。贵的不一定对;免费的也不一定够。标准只有一个:抽出来的文本,人能不能当「干净参考资料」用。
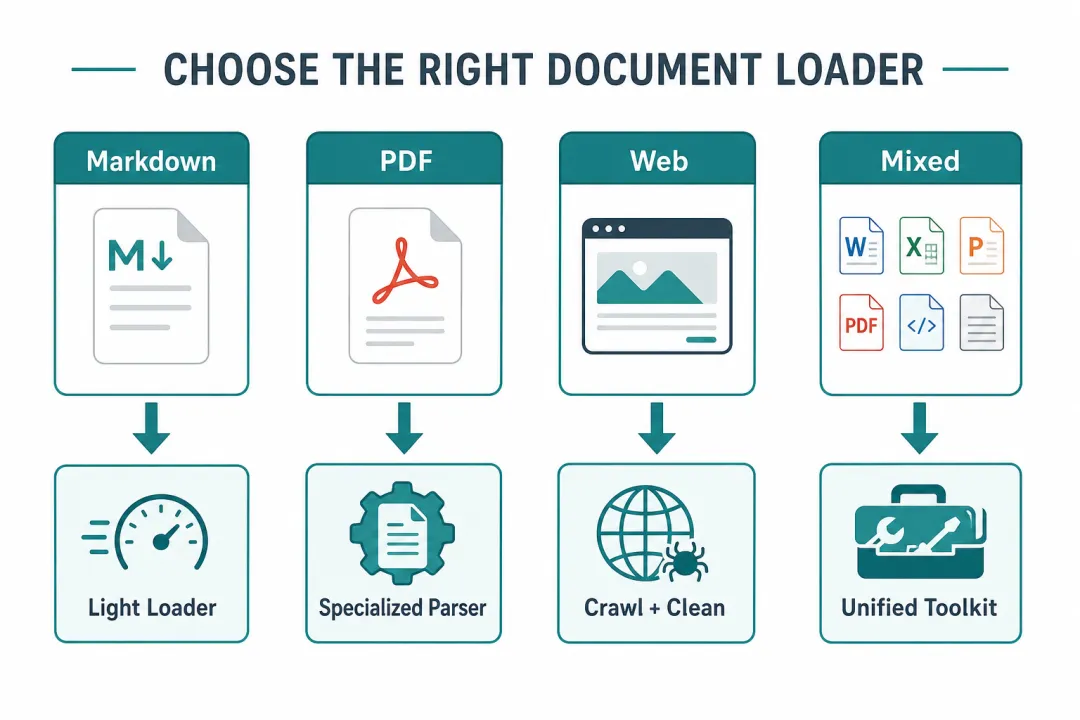 图3|先匹配格式,再拼流水线;难例不过关就不要批量入库
落地时的三条纪律
先抽样,后全量:每种格式抽 5–10 份难例,人工看解析结果 元数据从第一天就写: source、页码/URL、抓取或修订日期,后面过滤和溯源全靠它噪音显式处理:页眉页脚、导航、免责声明,能在加载阶段丢掉就丢掉
加载通过的标志不是「程序没报错」,而是:随机打开 20 个即将入库的片段,你愿意把它们交给大模型当开卷资料。
这篇你带走什么
PDF / Markdown / 网页是三条路:解析难度、噪音来源、工具选型都不同。 加载 = 解析 + 元数据 + 统一结构,不是简单 open(file)。用难例验收加载器:表格、双栏、扫描件、网页噪音过关,再批量进系统。