ARTICLE · 1069771
我把一份英文文档丢给 WorkBuddy,它自己造了个 AI 技能
导读:从 typesafe.ai 申请 API Key、把官方文档喂给 WorkBuddy 让它自己生成技能、配置多 Key 轮换、到产出一份 Jev 应用场景报告——这是我和 WorkBuddy 一起把「决策模型 Jev」从陌生到跑通的全过程记录。文末附一份可直接照抄的实操清单。
图1:一份文档,被 WorkBuddy 变成了一个能跑的技能
01 缘起:一个不写字的「决策模型」
说实话,第一次听 WorkBuddy 讲起 TypeSafe 的 Jev 模型,我是懵的。
它不是 ChatGPT 那种「你让它写段代码、它哗啦啦吐字」的大模型。它干的事特别拧巴——只做判断,不写文字。你丢给它一段文本,加上几个提前定义好的问题,它并行返回一组「带概率的结构化答案」。
举个例子:一条客服消息进来,你问它「这是账单问题还是技术 bug?紧急吗?」,它直接给你「账单 0.91 / 技术 0.05 / 紧急 0.99」这种数字,而不是写一段分析。
一句话结论:Jev 干的是软件里那些高频、重复、答案已知的小判断——路由、分类、打分、过滤。用 1/几十的成本、亚秒级延迟,把这部分从昂贵的大模型调用里摘出来。
我让 WorkBuddy 查了下官方数据:输入 $0.042 / 百万 token,输出免费;端到端延迟 70–500ms;结构化输出错误率号称 0%。这性价比,对做产品的我来说,太有想象空间了。
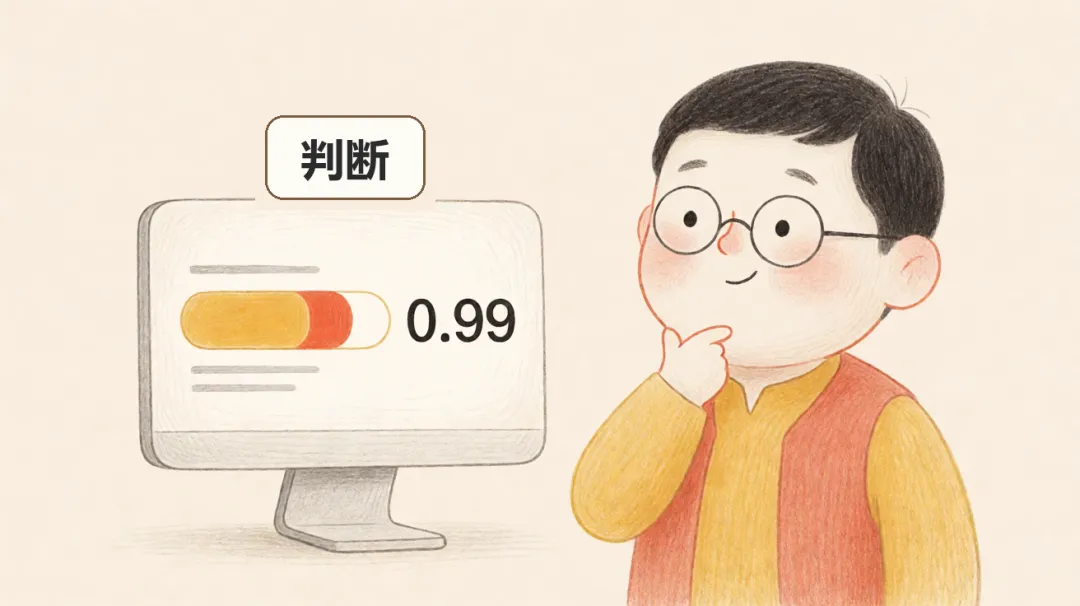
图2:Jev 不写字,只输出带概率的判断
02 不写一行代码,让 WorkBuddy 自己造技能
重点是这一步。
我没有去啃 TypeSafe 的 SDK 文档,也没配什么 npm 包。我干了一件事:把官网那篇 llms.txt 文档(链接:https://docs.typesafe.ai/llms.txt,可直接复制)连同「请据此安装对应 skill」的指令,直接丢给 WorkBuddy。
WorkBuddy 自己把活全干了:
1. 克隆了 typesafe-ai 的技能仓库,先做安装前安全审计(确认是 zero-code 纯文档技能,0 个高危风险); 2. 把整个技能目录手动复制到我的用户级 ~/.workbuddy/skills/typesafe-ai/;3. 我还让它额外加了个「多 Key 轮换」的参考客户端,落进技能的 references/。
一句话结论:把文档当输入、把「做成技能」当输出,WorkBuddy 帮我把一个陌生 API 变成了开箱即用的本地能力——我全程没碰一行 SDK 代码。
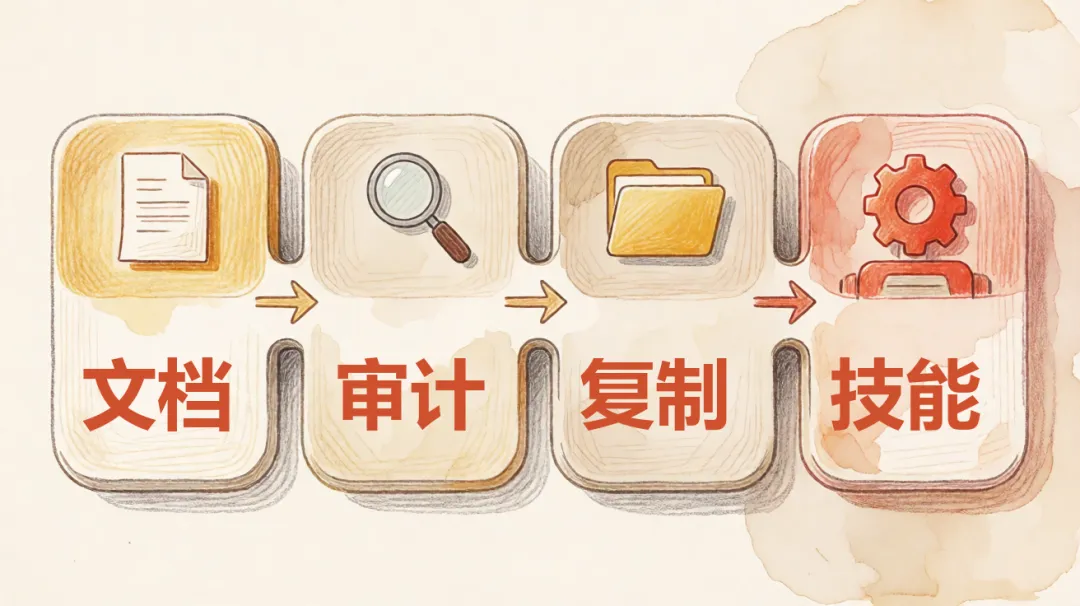
图3:文档 → 审计 → 落盘技能目录,Agent 全自动
03 申请 Key 与配置环境变量(我踩了个坑)
技能有了,得有钥匙。我去 https://console.typesafe.ai(新注册送 $5 额度)一口气申请了 6 个 API Key(想着高并发好轮换)。
配置环节我栽了一跤。最早我用 $env:TYPESAFE_API_KEYS=... 在交互式终端临时设,结果 WorkBuddy 的进程里读不到——临时变量只活在那个 shell,新开的进程不继承。
后来改成 Machine 作用域设:
[System.Environment]::SetEnvironmentVariable( "TYPESAFE_API_KEYS", "k1,k2,...,k6", "Machine")设完所有进程都能读到(当前 shell 要重开才热加载,重新打开终端 $env: 就有值了)。
一句话结论:API Key 放系统环境变量(Machine 级)或项目 .env + dotenv,千万别写进技能目录——技能目录会被共享、还会进 GitHub 公开仓库,写真密钥等于泄露。
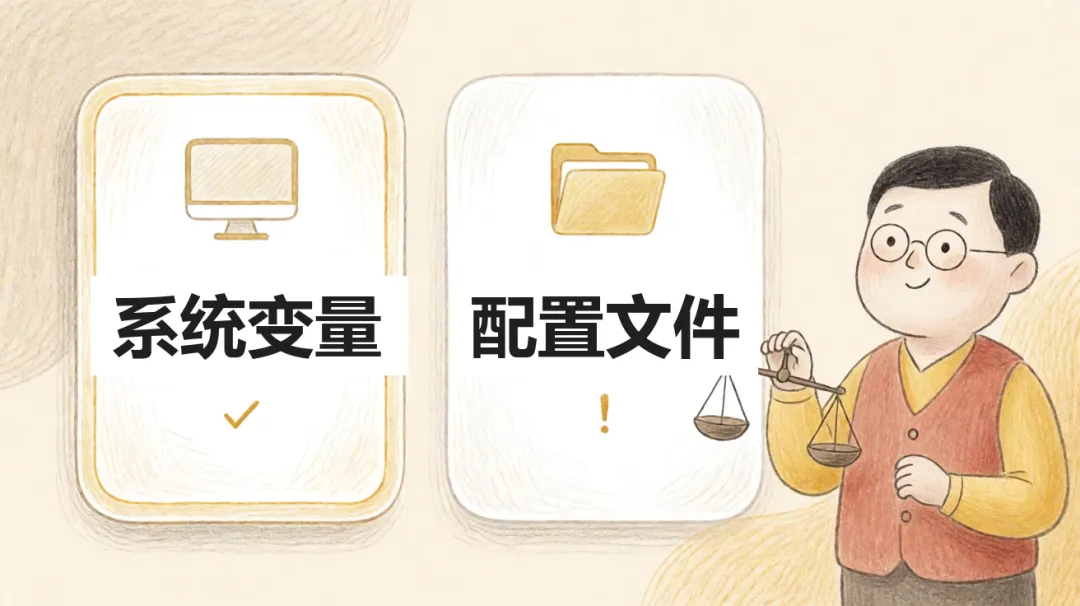
图4:系统环境变量 vs 项目 .env,密钥的归属之争
04 多 Key 轮换:实测翻车,然后修复
这是最有意思的一段。
我为客户端写了「多 Key 轮换」逻辑:从 TYPESAFE_API_KEYS 读一串 key,每次请求轮着用,碰到 401 自动剔除坏 key,碰到 429 限流就退避重试。想法很美。
但当我真用 6 把真实 key 联网测时,发现 3 次调用全用了同一把 key(前缀都是 apikey_223..443d)。排查定位到一个 bug:那个一行式便捷函数 askTypeSafe() 每次调用都 new 一个新的客户端实例,轮换游标每次从 0 重新起步——等于白轮换。
我把它改成模块级单例,游标跨调用保持。复测:3 次调用用了 3 把不同的 key(apikey_223 → apikey_215 → apikey_239),轮播确认生效。一次真实调用返回 jev-1.13.0,答案 noul=0.99,干干净净。
一句话结论:多 Key 轮换不是写个循环就完事,游标状态必须跨调用存活;这个 bug 不跑真实联网根本发现不了。
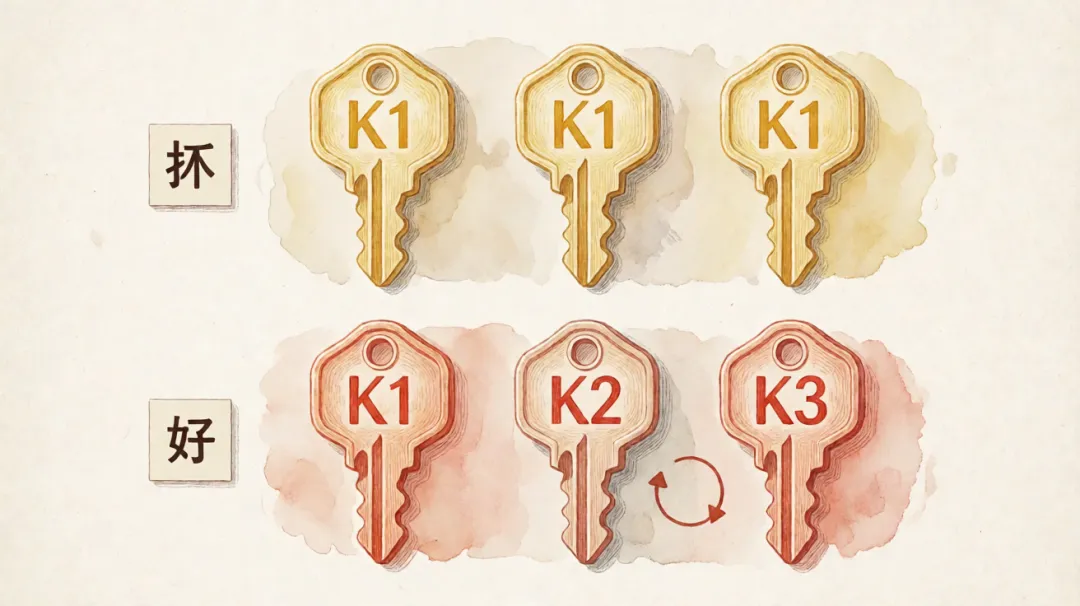
图5:游标归零(坏)vs 模块单例(好)
05 Jev 到底能干什么:一份应用场景报告
工具跑通了,我让 WorkBuddy 把官网用例地图、架构模式、Cookbook 全读了一遍,整理成一份《Jev 应用场景报告》。核心结论:
• 决策矩阵:10 类任务形状(分类 / 检测 / 打分 / 路由 / 检索 / 排序 / 校验 / 抽取……),凡是「答案集已知」的判断都适合。 • 行业地图:客服、保险理赔、金融风控、法律合规、电商、内容审核、广告、游戏 AI、招聘……5 大主题 18 个具体场景(全景见 https://docs.typesafe.ai/concepts/use-case-map.md)。• 四大架构模式:推测式扇出、置信度门控路由(高置信自动 / 中置信转 LLM / 低置信转人工)、复合打分、意图路由——都带可运行代码。 • 量化实证我最服:把 13 个并行问题一次性问,比逐个问 省 12.2×、快 10× 且答案不变;RAG 重排把 BM25 的 Top-1 准确率从 5% 拉到 18%,1200 次调用只花 $0.0645。
一句话结论:Jev 不是来替代大模型的,它是大模型的「决策副驾」——前面先分类、路由、打分,难的那少数几步才交给大模型。
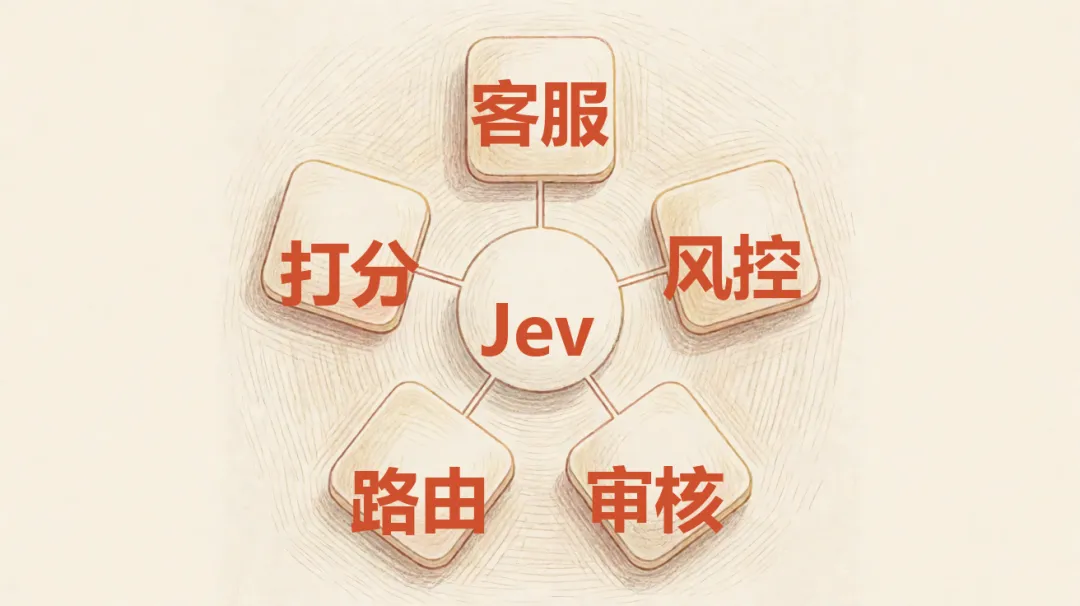
图6:从一条文本到一组带概率的判断
06 我的几点实在建议
折腾一圈,给想上手的人几句大实话:
1. 架构走「级联」:Jev 先分类 / 路由 / 打分,代码处理确定部分,难的少数交给大模型。别想着用它替大模型写东西。 2. 先拿一个「老在坏的正则 / if」开刀:你代码里现在靠正则或硬编码 if判断、又老出错的那个点(路由 / 审批 / 跳过),换成 1 个 Noul 或 Choice,记一周置信度日志,稳了再让它真自动执行。3. 阈值三段式:高置信自动、中置信要确认、低置信转人工。这比「设个死阈值」稳得多。 4. 中文先实测:官方明说英文是主训练语言,中日韩「能用但没那么好」。中文场景务必先拿自己的内容校准,别直接上生产。
一句话结论:Jev 的价值不在「多聪明」,而在「又快又便宜又稳地做对大量小判断」——把它的活儿接住,你的大模型账单能砍掉一大半。
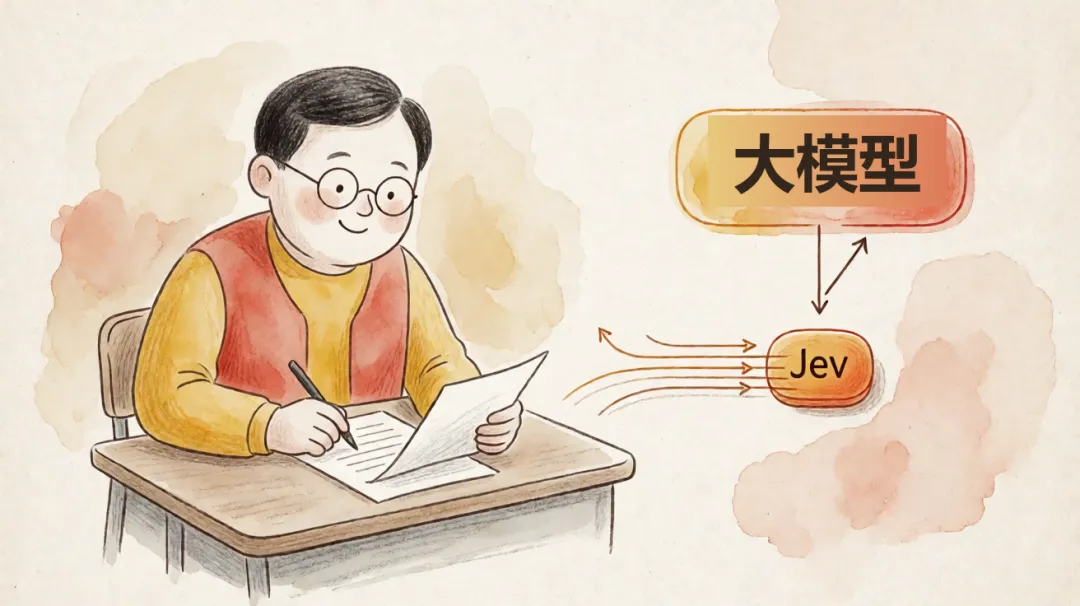
图7:Jev 接住大量小判断,大模型只管难的那几步
工具只是拐杖,走路的人是你。真正值钱的,是你把「哪段判断该交给机器」想清楚的那一下。
【互动·知识向】
你在工作里有没有那种「靠一堆 if / 正则硬扛、还老出错」的判断逻辑?或者有想用 AI 做分类 / 路由 / 打分的场景?评论区聊聊,下期我可以挑一个具体场景,用 Jev + WorkBuddy 写成可跑的模块。觉得有用,欢迎收藏转发~