ARTICLE · 1073045
AI 不是万能工具,它更像一个跑得很快、但完全没有常识的实习生
三个月前,我对 AI 的态度是"什么都能让它干"。
写东西让它写,算账让它算,整理文件让它整理,连"我接下来该做什么"都想问它一句。
用到第 7 天,我就吃了第一个亏。我让它帮我写一个小脚本,把一批数据按规则重新整理一遍。它给我的代码看起来挺像样,我没多想,直接跑在原始文件上了。
结果是:原始数据被改了,改得还很整齐,整齐到我第一时间没看出来。
我是第二天才发现不对劲的。那批数据我攒了快一个月,好在之前顺手留了一份备份,才捞回来。
从那天起,我改了用法。不是不用了,是把它当成一个具体的东西来用——它有明确的强项,也有明确的盲区。搞不清这两件事,用它就是碰运气。
这篇是我这三个月摸出来的用法。不吹也不黑,就是把我实测的结果摆出来,你能用上哪条用哪条。
一、我做了个小实验:记一个月的账
光凭感觉说"AI 有用"或者"AI 没用",都不算数。所以第二个月开始,我把每一次交给它的活都记了一笔。
记什么?三样:这件事属于哪一类、我原本自己做得花多久、交给它之后我实际花了多久。
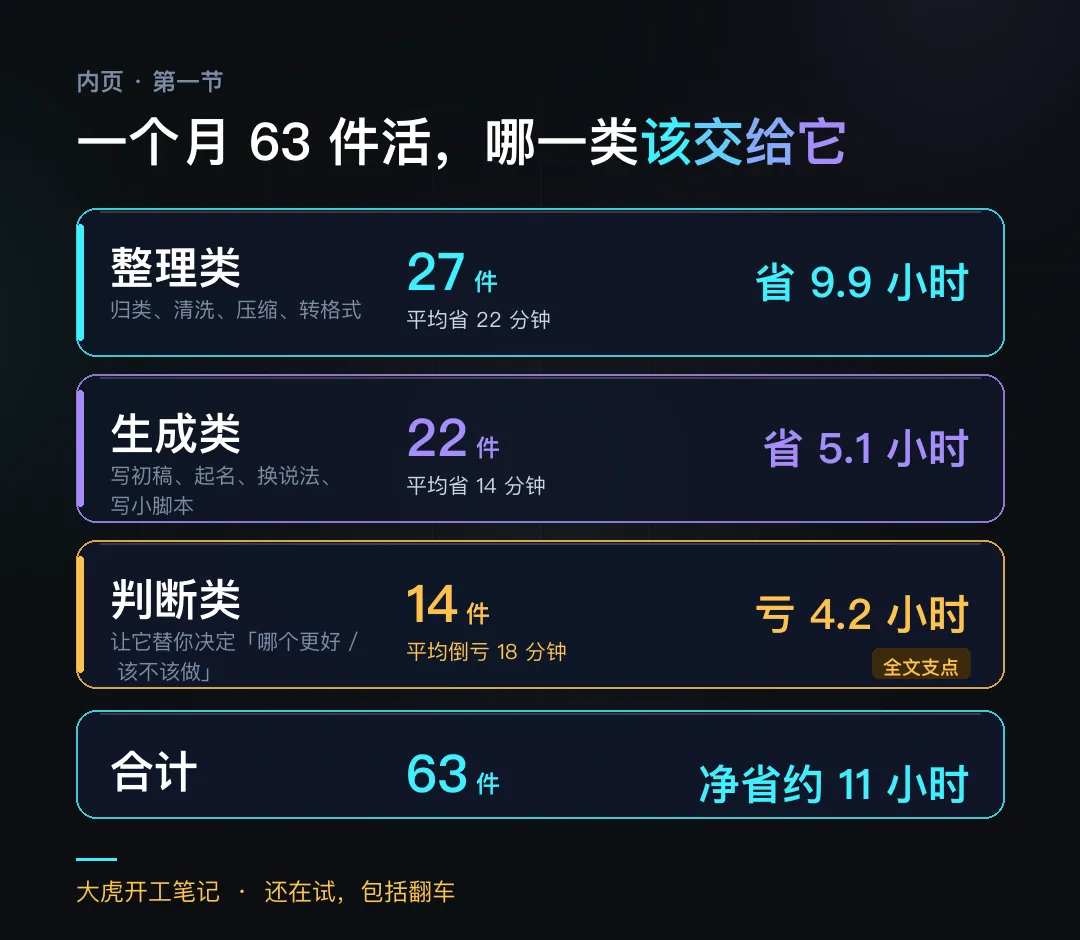
一个月下来,一共 63 件。按性质分成三类:
- 整理类 27 件
:把乱的东西变成整齐的东西(归类、清洗、压缩、转格式)。
- 生成类 22 件
:把没有的东西生出来(写初稿、起名、换说法、写小脚本)。
- 判断类 14 件
:让它替我决定"哪个更好""该不该做""这样行不行"。
一个月之后我算了一下账:
类别 | 件数 | 平均每件 | 合计 |
整理类 | 27 | 省 22 分钟 | 省 9.9 小时 |
生成类 | 22 | 省 14 分钟 | 省 5.1 小时 |
判断类 | 14 | 倒亏 18 分钟 | 亏 4.2 小时 |
合计 | 63 | — | 净省约 11 小时 |
净省 11 小时,听起来还行。但这张表里最值钱的不是"省了 11 小时",是判断类那一行是负的。
也就是说:我让它帮我想"该不该做"的那 14 次,不但没省时间,还让我多花了四个多小时——因为它每次都能给你一个听起来很有道理的方向,而我要花时间去验证那个方向到底对不对。验证完发现不对,再重来。
这是我这三个月最重要的一条发现:它最像你的地方,恰恰是它最不可靠的地方。
下面把这条拆成两份清单。
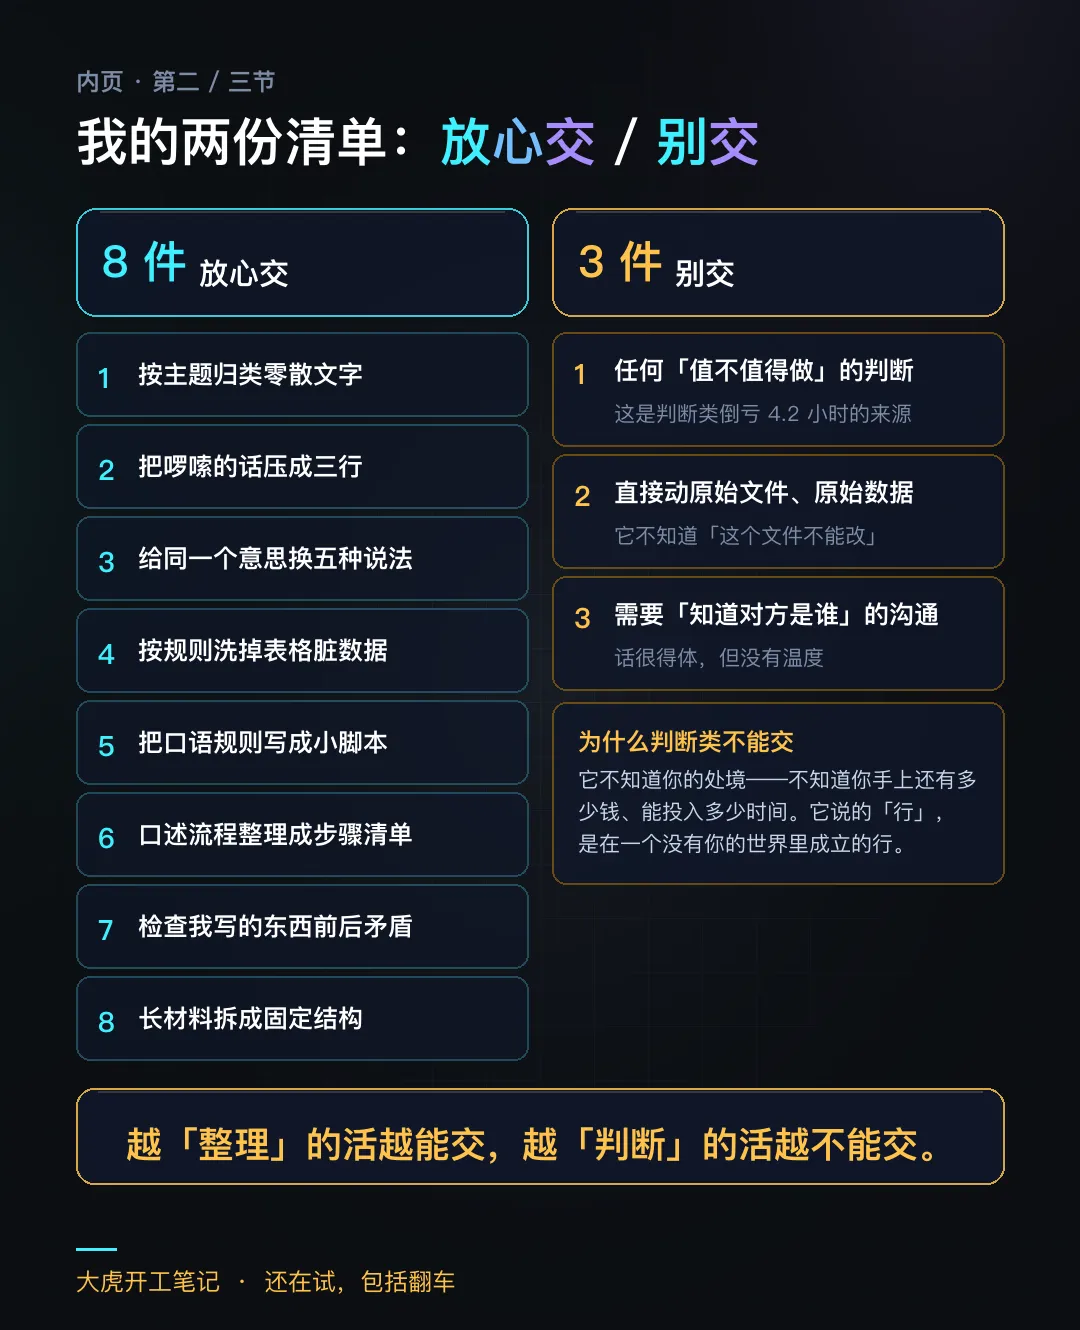
二、它做得比我好的 8 件事(可以直接抄)
这 8 件事我用了三个月,稳定性很高,基本可以放心交。
1. 把一堆零散文字按主题归类。我把一天的随手记丢给它,说清楚分哪几类,它几十秒归完。我以前手动拖,半小时起步。
2. 把一段啰嗦的话压缩成三行。我写的东西经常发散。给它一句"压到三行,保留原来的意思",它压得比我狠,也更准。
3. 给同一个意思换五种说法。写标题卡住的时候很有用。它给的五个里通常有一个能用,剩下四个当陪练。
4. 把表格里的脏数据按规则洗一遍。比如把"1,200 元""1200元""¥1200"统一成一种写法。规则说清楚,它做得又准又不烦。
5. 把一大段口语规则写成能跑的小脚本。这是它最被低估的能力。你说人话,它出代码。前提是——先备份(这个坑我踩过,见第六节)。
6. 把我口述的流程整理成步骤清单。我对着它说一遍"我平时是这么干的",它整理出来的步骤比我脑子里想的清楚。
7. 检查我写的东西里前后矛盾的地方。这条我一开始没想到。让它"找矛盾",它真能找出我前后数据对不上的地方。
8. 把一份长材料拆成固定结构。给它一个结构(比如"背景 / 做法 / 结果 / 坑"),它照着填。省的是最枯燥的那部分。
三、它一直做不好的 3 件事(别交)
这三件我反复试过,结论是稳定的:不要交。
1. 任何"这件事值不值得做"的判断。
这是判断类亏 4.2 小时的来源。你问它"这个方向能不能行",它的回答永远是有条理的、有正反面的、听起来很全面的。
问题是——它不知道你的处境。 它不知道你手上还有多少钱、不知道你家里什么情况、不知道你真正能投入多少时间。它说的"行",是在一个没有你的世界里成立的行。
判断这件事,只能你自己做。它能做的是帮你把判断需要的信息摆齐,不是替你下判断。
2. 直接动原始文件、原始数据的操作。
就是第 7 天那次。它写的脚本没有恶意,但它不知道"这个文件不能改"。
从那天起我立了一条规矩,到现在没破过:任何自动化的第一步,永远是先复制一份原始文件。 不是"如果重要就备份",是"没有例外"。因为你怎么知道它重不重要,得等你改坏了才知道。
3. 需要"知道对方是谁"的沟通。
回复别人、跟人打交道、有情绪含量的对话——这一类我试过几次,效果都不好。它写出来的话很得体,但没有温度,也不认识对面那个人。
这类事它只能帮你打草稿,最后那句话必须你自己说。
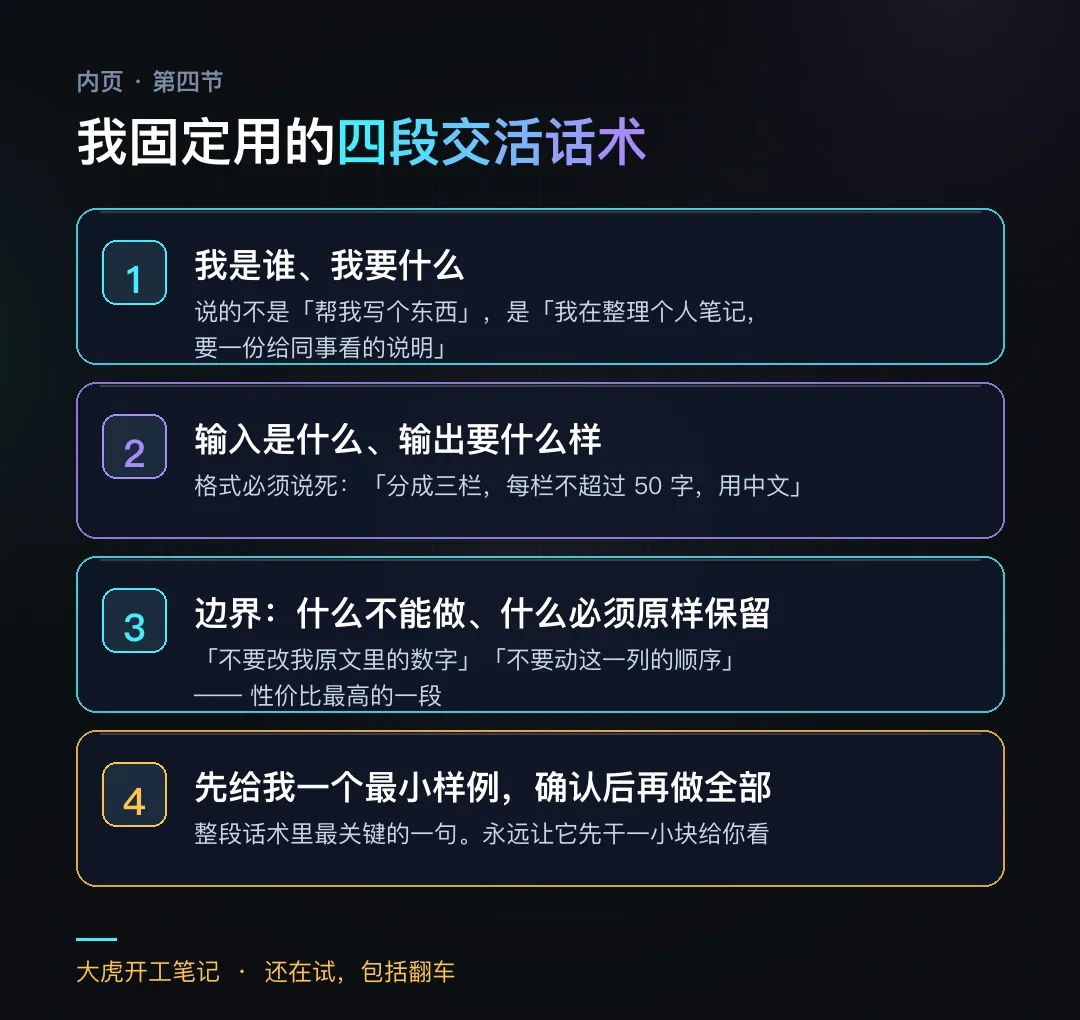
工具本身差别不大,差别在你会不会交活。 我现在的每件事都按四段来说,缺一段就容易返工:
第一段:我是谁、我要什么。不是"帮我写个东西",而是"我在整理个人笔记,我要一份给同事看的说明"。你的处境说得越具体,它跑偏的概率越低。
第二段:输入是什么、输出要什么样。输入是"我下面给你的这段文字",输出是"分成三栏,每栏不超过 50 字,用中文"。格式必须说死,不然它会自由发挥。
第三段:边界——什么不能做、什么必须原样保留。"不要改我给的原文里的数字""不要动这一列的顺序""不要加你没在我材料里看到的例子"。这一段是我吃过亏之后才加的,性价比最高。
第四段:先给我一个最小样例,我确认之后再做全部。这一步是整段话术里最关键的一句。永远让它先干一小块给你看。 对了我再放它去做全部,错了也只损失一小块。
这四段你记下来,存在你常用的地方。就这四句,我用了两个月,返工次数掉了一大半。
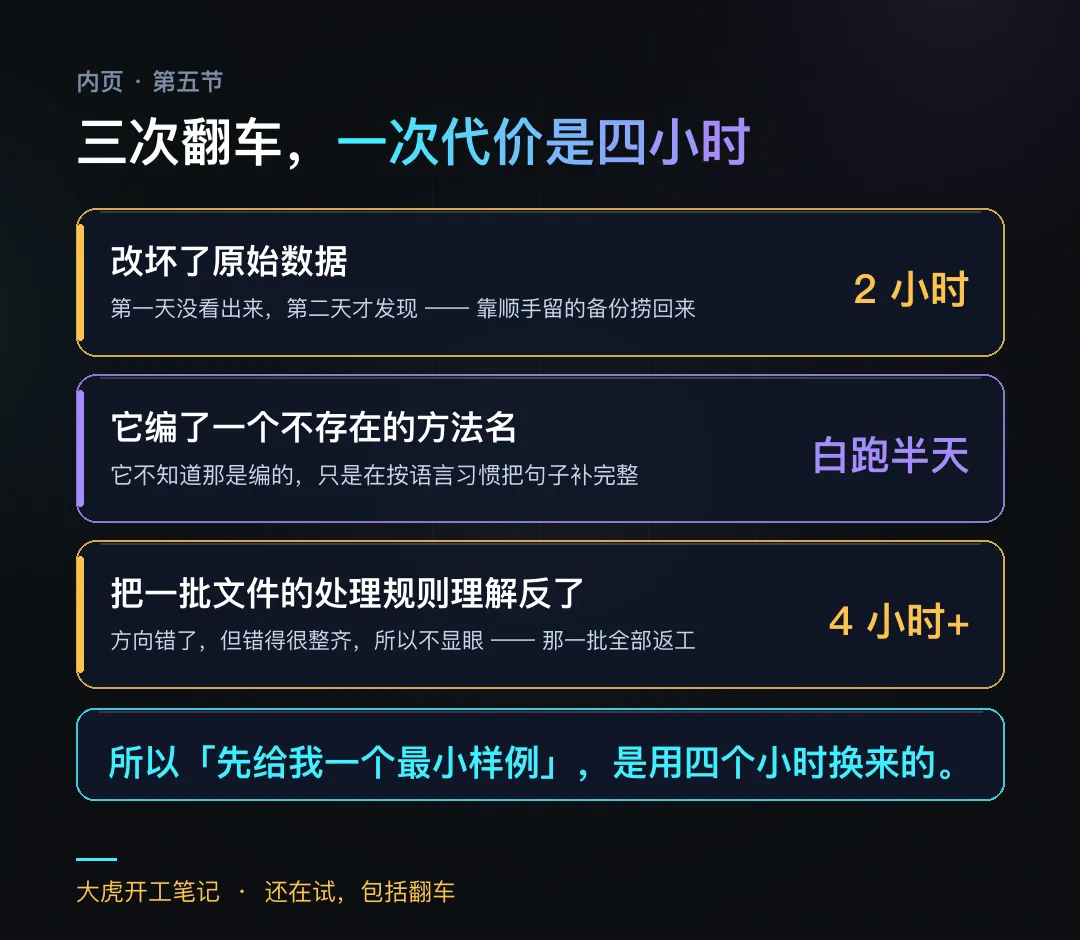
五、真实翻车:三次,有一次代价不小
第一次:改坏了原始数据(前面说过)。第二天才发现,靠备份捞回来。代价是两小时,加上一身冷汗。
第二次:它编了一个不存在的东西。
我让它用某个方法处理一批数据,它给我写了一段很顺的说明,里面提到一个具体的方法名。我照做了,怎么都跑不通。
后来才发现,那个方法名是它自己拼出来的——它不知道那是编的,它只是在按语言习惯把句子补完整。
这件事之后我改了习惯:凡是它给的具体名词、数字、链接,我一律单独验一遍。 不是不信它,是它分不清"知道"和"听起来知道"。
第三次:我把一个月的整理白做了。
那次我图快,让它一次处理一整批文件,没先给它看样例。跑完我扫了一眼觉得没问题,就直接归档了。
过了两周要用的时候才发现,它把某一类文件的处理规则理解反了——方向错了,但错得很整齐,所以不显眼。 那一批文件得全部返工,前后搭进去四个多小时。
所以第四段话术里那句"先给我一个最小样例",是用四个小时换来的。
六、你可能会问
Q1:我不会写代码,是不是用不上?
用得上。上面 8 件里只有第 5 件沾代码,其他 7 件都是说话就能用的。而且第 5 件也不要求你会写——你会说就行。你只要能把"我平时是怎么处理这件事的"讲清楚,它就能给你一段能跑的。
Q2:我怎么知道它给我的答案是对的?
两个土办法:一是让它把你的要求复述一遍,你对一遍,看它理解错在哪;二是凡具体名词数字都单独验一遍(编造是我踩过的坑)。
Q3:是不是所有活都该交给它?
不是。第三节那三件事别交。剩下的大原则是:越"整理"的活越能交,越"判断"的活越不能交。
Q4:用了它之后,我自己的能力会不会退化?
我自己的体感是:"把事说清楚"的能力变强了,其他没变。 因为你每次都要先想明白"我要什么、边界是什么",这个动作本身就在训练你的表达。至于判断力,它本来也替代不了。
七、如果你明天就想开始用:三句话
- 交活说四段
——我是谁、要什么、输入输出、边界,最后加一句"先做一小块给我看"。
- 整理和生成的活放心交,判断的活自己来。
- 动任何原始文件之前,先复制一份。没有例外。
就这三句。剩下的是你自己用起来才会有的。
三个月下来,我对它的定位变了。以前我以为它是个"什么都能干的万能工具",现在我觉得它更像一个跑得特别快、但完全没有常识的实习生。
快是真的快。但没有常识也是真的没有——它不知道什么重要,不知道什么不能动,也不知道你是谁。
而"知道什么重要、什么不能动、你是谁",恰好是只有你能提供的部分。所以真正的用法不是让它替你想,是你说清楚,它跑腿。
我这半年最值钱的一条经验就是这个:别指望工具替你做决定,指望它替你把执行做快。
你平时都让它干什么活?有没有踩过坑?留言区聊聊,我不一定能答,但说不定能一起看看是出在哪一步。
本文为本人原创,记录个人实践,不构成任何建议。