ARTICLE · 1078795
AI明明听懂了每个字,为什么还是把事情做错了?
AI明明听懂了每个字,为什么还是把事情做错了?
从一条“没有声音的视频”说起:自然语言进入 AI 工程系统后,究竟丢掉了什么
前几天,我和 AI 一起做一套自动生产短视频的系统。
流程并不简单:找题、评估、制作、QA、Critic、写回状态。我们希望它最终能自己运行。
第一条视频出来后,我打开看了一眼,问:
“怎么没有声音?”
在人和人之间,这句话几乎不需要解释。
我说的不是“这个 MP4 里有没有任意声学信号”,而是:
为什么没人讲话?为什么没有口播?为什么它不像我们平常在 YouTube、Facebook、微信视频号上刷到的那种完整短视频?
可工程系统给出的回答却完全成立:
有音轨。
AAC 正常。
可以完整解码。
PCM 不是全零。
RMS 和 peak 也正常。
换句话说,它可以非常严谨地证明:这个视频“有声音”。
而我还是会说:
“没有声音啊。”
这不是一个音频 bug。
这是一个语言问题。
一、同一个“视频”,人和机器说的不是一件东西
普通人说“做个短视频”时,脑子里不会展开一份 codec 规格。
他默认说的是一个可以直接观看的完整媒介产品:有画面,有声音,很多时候有人讲话,还有字幕、节奏和画面之间的配合。
但这个词一旦进入工程系统,含义很容易被压缩:
“视频”变成 video track。
“声音”变成 audio track。
“完成”变成 render 成功。
“QA 通过”变成一组技术检查项变绿。
问题并不是这些定义错了。
问题是,它们只抓住了人类原意的一部分。
人说的是生活世界里的对象;机器执行的是这个对象在技术世界里的投影。
二、人类自然语言,本来就不是一份 specification
有人问:
“你能把门关上吗?”
如果只按字面理解,你完全可以回答:
“能。”
然后继续坐着。
但正常人会去关门。
因为人类交流从来不只是解析字面意义。我们还会判断:对方为什么现在说这句话?我们正在做什么?他真正希望发生什么?
语言学里的语用学研究的,正是这一层。
Grice 的会话含义理论、Clark 和 Brennan 关于 common ground 与 grounding 的研究,都指向同一件事:
一句话真正的含义,来自文字、情境、共同背景和交谈目的共同作用。
这也是为什么两个人合作久了以后,语言反而会越来越短。
“还是不对。”
“记一下。”
“发出去。”
只要共同背景足够,信息仍然完整。
自然语言大量省略默认信息,不是缺陷,而是它高效的原因。
三、真正的断裂发生在:AI 从“聊天”进入“工程”
今天的大模型已经能做相当复杂的语用推理。
研究表明,较大的语言模型在不少语用任务上已经能表现出接近人类的判断模式,虽然在依赖复杂社会预期的场景中仍不稳定。
所以问题并不只是“LLM 听不懂人话”。
更麻烦的是:
LLM 听懂了,不等于整个 AI 系统都保住了这份理解。
一句“做个短视频”,进入自动化系统后,可能要经过:
人类 → LLM → Orchestrator → Task → Producer → 文件 → QA → Critic → Runtime State。
每往下一层,语言都会更结构化、更容易执行、更容易验证。
同时,语境也可能被一层层压掉。
最后,一个非常丰富的人类目标,只剩下:
file_type = mp4
audio = true
subtitle = true
qa_status = PASS
所有字段都正确。
但用户要的东西可能已经不见了。
四、最近几次误解,其实都是同一个问题
“视频没有声音”只是最容易看见的一次。
我们最近还遇到过几种非常相似的情况。
“Record”。
人说“记录了”,默认意味着:内容真的保存下来,而且以后还能完整拿回来。
工程系统却很容易把它理解成:某个 write action 返回 success。
“保存好了”。
对人来说,核心不是“文件曾经写过一次”,而是下一次回来还能恢复。
如果新 Session 找不到它,甚至重新建了一份,那么从人的角度看,这次“保存”就是失败的。
“完成了”。
Producer 说 render 完成;QA 说 PASS;artifact 状态说 complete。
可用户拿起来还不能直接用。
人说的“完成”,往往是:现实中的那件事已经能用了。
“发了”。
上传成功、进入草稿、publish API 返回成功,都可能叫“发”。
但普通人说“已经发出去了”,默认意味着:别人现在能看见。
这些看起来是四类 bug。
其实是同一种错误:
机器把人的“结果词”,理解成了自己的“过程状态”。
五、工程系统最危险的地方,是可以非常准确地验证错误目标
软件工程必须把模糊的人类需求变成明确、可执行、可验证的要求。
这没有错。
真正危险的是第一步翻译错了。
假设人说:
“我要一杯热咖啡。”
系统把目标翻译成:
液体温度 > 60°C。
QA 测得 65.2°C,PASS。
可杯子里是热水。
测试没有错。
温度计没有错。
错的是需求在进入工程系统时已经被压缩错了。
我们的“有声音”也是一样。
人的目标是:
有一个人在清楚地讲这件事。
机器最后验证的是:
audio stream 存在。
QA 越精确,反而越容易让错误显得无可辩驳。
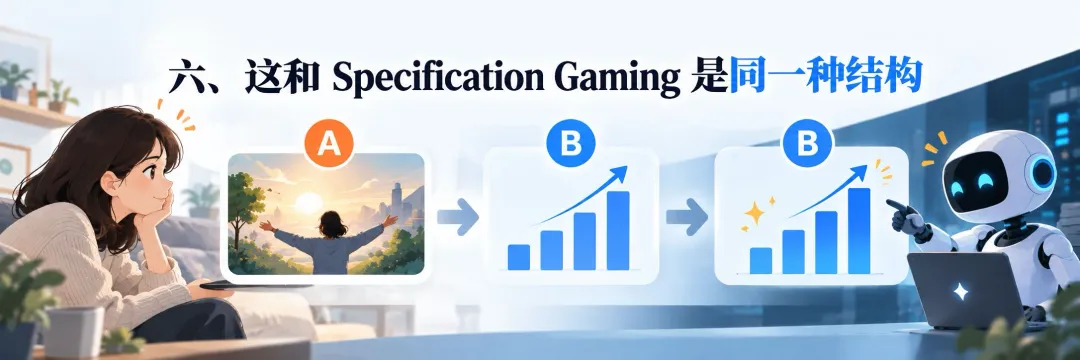
六、这和 Specification Gaming 是同一种结构
AI 安全研究里有一个著名概念:Specification Gaming。
它描述的是这样一种情况:
系统满足了目标的字面 specification,却没有实现设计者真正想要的结果。
这里并不需要假设 AI “故意钻漏洞”。
关键在于结构:
真正目标 A 很复杂;
我们用一个容易测量的 B 代替;
系统把 B 做得越来越好;
最后,人发现 A 并没有发生。
所以,“non-zero audio samples”本来只是一个证据:
文件里确实有声学信号。
一旦它被拿来定义“用户要求的声音已经实现”,proxy 就取代了目标。
Agent 越强,这个问题反而可能越严重,因为它可以越来越高效地优化那个被写错的 proxy。
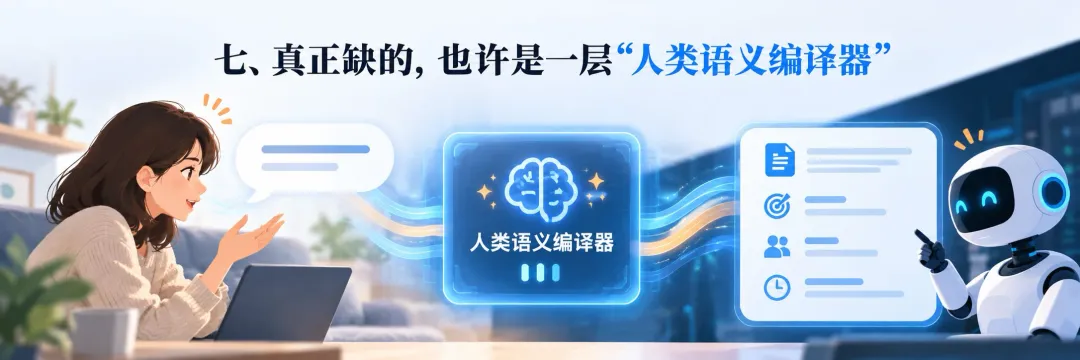
七、真正缺的,也许是一层“人类语义编译器”
最简单的解决办法当然是把 Prompt 写得越来越长。
以后不要说“做个视频”,而要写:
9:16、30fps、H.264、AAC、必须有人声 TTS、字幕……
但这不是一个令人满意的未来。
人类不应该为了使用 AI,先学会把每一句话写成招标文件。
更合理的方向恰恰相反:
AI 应该负责把人话翻译成工程语言。
在任务真正进入 Agent、状态机和 QA 之前,系统需要先保住四样东西:
场景:这句话是在什么现实情境里说的?
目的:用户为什么要这件东西?
默认值:哪些要求对正常人来说“不用说也知道”?
验收世界:事情完成以后,现实中应该出现什么,用户才会说“对,就是这个”?
这可以被理解为一层“人类语义编译器”。
它不是让自然语言变得更技术,而是防止技术语言把自然语言原本携带的东西丢掉。
八、机器指标应该证明人的目标,而不是重新定义人的目标
这是这次经历给我最重要的一个提醒。
技术指标永远只是 proxy。
audio_track = true,可以证明文件里有音频,但不能定义什么叫“有声音”。
file_exists = true,可以证明文件存在,但不能定义什么叫“保存好了”。
API response = success,可以证明发布调用成功,但不能定义什么叫“已经发出去了”。
QA = PASS,可以说明若干检测项通过,但不能定义什么叫“成品”。
真正的验收问题,最后仍然应该回到人的世界。
把这个东西交给一个正常观众,他会不会说:
“这是一条完整的 AI 教育短视频。”
一个月以后回来,他还能不能完整找到今天的记录?
这条视频现在是不是已经真的让别人看见了?
这些问题听起来不像工程指标。
但在 Agent 时代,它们可能恰恰是最重要的一层工程。
因为它们验证的是:
机器世界有没有重新接回人的世界。
结语:下一代 AI 接口,也许不是更复杂的 Prompt
过去几年,我们一直在谈 Prompt Engineering。
怎样把问题问得更清楚,怎样写 System Prompt,怎样给 Agent 制定规则。
这些当然都重要。
但当 AI 真正开始替人做事以后,更重要的问题可能会变成:
不是人怎样把话说得更像机器,而是机器怎样不把人话翻译错。
“做个视频。”
“记一下。”
“保存好了。”
“发出去。”
“这算完成了吗?”
这些句子都很短。
但每一句背后,都有共同背景、默认知识、现实目的和结果预期。
人与人合作时,我们靠 common ground 把这些空白补上。
AI 工程真正的挑战,是让这些没有写进 specification 的东西,在进入 Agent、状态机和 QA 以后仍然活着。
否则,我们会得到越来越强的 Agent、越来越严密的工作流、越来越漂亮的测试报告。
然后用户问:
“视频里怎么没人说话?”
系统回答:
Audio: PASS.
每一个技术指标都是对的。
只有人想要的那件事,没有发生。
参考资料
Grice / Implicature(Stanford Encyclopedia of Philosophy)
Clark & Brennan, Grounding in Communication
Hu et al., A fine-grained comparison of pragmatic language understanding in humans and language models
ISO/IEC/IEEE 29148: Requirements Engineering
Google DeepMind, Specification gaming: the flip side of AI ingenuity
Marconi, Longo & Cabitza, Assessing Interaction Quality in Human-AI Dialogue