ARTICLE · 1087509
AI递归自进化(RSI):硅基世界的“达尔文时刻”
对于进化论,有一句流传极广的话:“活下来的物种,不是最强壮的,也不是最聪明的,而是最能适应变化的。”
这段话抓住了进化论的内核:自然选择的真正赢家,从来不是某一时刻的“最强者”,而是迭代速率最快、最能随环境改变的那个谱系。恐龙统治地球1.6亿年,却没能熬过一次环境剧变;人类先祖弱小得多,却靠认知与文化的高速迭代站上了食物链顶端。
如今,这条法则正在一个全新的世界里重演——硅基世界。只不过,碳基生命用了数十亿年走完的进化路,AI可能把它压缩到以“周”为单位。
2026年,硅谷最聪明的一批大脑,对外讲的故事已经悄悄从AGI(通用人工智能)换成了另一个词:RSI,Recursive Self-Improvement,递归式自我改进,通俗说就是“AI自己造更强的AI”。
这个命题,是下一个竞逐的热点,也让硅基世界或迎来“达尔文时刻”。
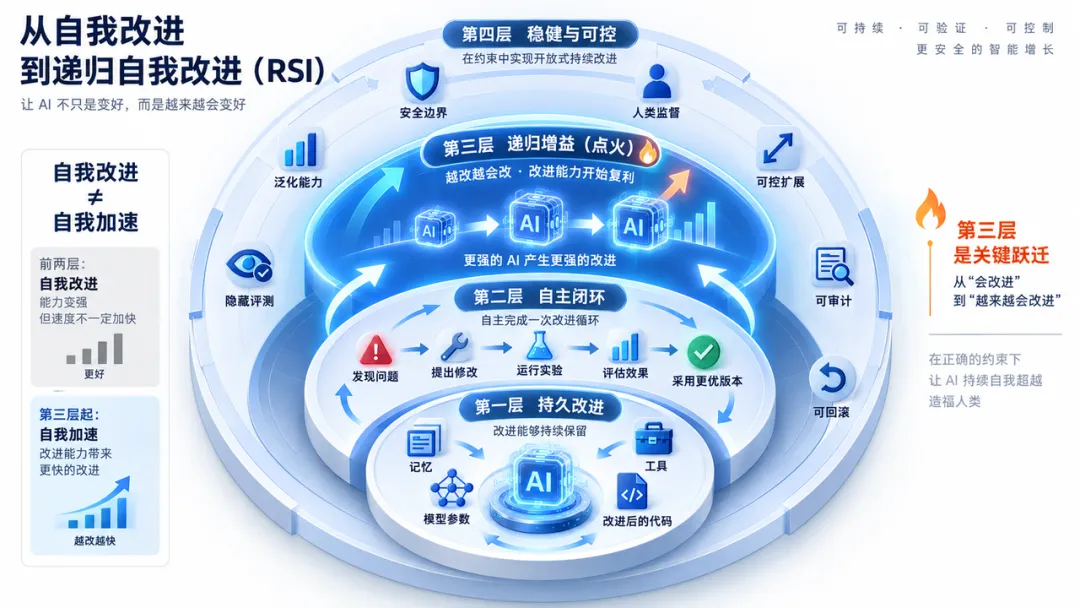
要理解RSI,先要拆穿一个常见的误解:会自我改进,不等于会自我加速。
一个系统可以在固定题库上越做越好,却没有变得更会“设计下一轮训练”;一家公司可以大量用AI提效,却没有形成由改进本身驱动的复利。
这两者有天壤之别。
1965年,曾与图灵共事的英国数学家欧文・古德写下那段著名论断:“第一台超智能机器,将是人类最后一项发明。”因为一旦机器聪明到能设计出比自己更强的机器,后续的发明就不再需要人类,智能将进入自我叠加的循环,其称之为“智能爆炸”。
当下学界倾向于用四层可观察的标准,把这个曾经只存在于思想实验里的概念拆开,难度从低到高:
第一层是持久改进。有效的变化能沉淀进模型权重、记忆、工具或训练流程,而不是一次对话结束就消失。
第二层是自主闭环。系统能在划定边界内自主发现问题、提出修改、跑实验、评估结果并接纳更优版本,这被称为“有界 RSI”。
第三层是递归增益,也叫“点火”(ignition)。新版本不仅任务分数更高,而且比旧版本更擅长产生下一次改进。只有跨过这道坎,“改进能力本身”才开始复利,即真正的递归自我加速。
第四层是稳健与可控。增益能在固定资源和隐藏测试下持续、能泛化到陌生任务,且不以评估作弊、系统失控、目标对齐退化为代价,才接近“开放式RSI”。
业内人这样打个比方,普通的AI优化像学生反复刷题、整理错题本,分数提高,但学习方法还是老师教的;RSI则是这个学生不仅刷题,还在不断发明全新的学习方法,再用新方法迭代出更高效的方法论,能力像滚雪球一样越涨越快。
而必须冷静指出的是:截至今天,前两层已经出现,第三层“点火”尚无充分的公开证据,第四层更远未解决。有界闭环已经跑通,并不等于递归自我加速已经启动。
这个区分,恰恰是区分“技术事实”与“资本叙事”的关键。
从假说到工程:2026年的“点火”竞赛
RSI并非新概念,但2025年到2026年,它第一次从论文走进了可运行的代码。
最具象征意义的是日本Sakana AI的“达尔文·哥德尔机”。这个编程智能体维护着一个不断演化的“自身版本库”,自主改写自己的Python代码库,每一处改动都要在编程基准上跑通、被验证更优才会保留。
结果是,它在SWE-bench上的成绩从约20%提升到50%,绝对提升30个百分点——这个AI靠改写自己,让自己变成了更强的程序员,而更强的编程能力又直接意味着更强的自我改写能力。
谷歌DeepMind的AlphaEvolve则上演了另一出“进化”。它以Gemini为“变异引擎”,用进化搜索自动设计算法,找到了用48次标量乘法完成两个4×4复数矩阵相乘的方法,打破了斯特拉森1969 年提出、尘封56年的49次纪录。同时,它还被用于优化谷歌自家的数据中心调度、编译器和GPU指令。
OpenAI在2026年7月发布GPT-5.6时,成绩单上第一次出现了一门反常的新科——“AI能不能参与改进AI本身”,并称之为RSI指数。
根据这个指数,GPT-5.6得分为57.9%,较GPT-5.5的41.7%提升16.2个百分点。需要说明的是,这套指标的题目与权重并未公开,它是内部综合参考值,不能等同于RSI的“完成度”。与此同时,Anthropic被报道其内部约八成可运行代码已由Claude自身生成,业界把“让Claude训练Claude”的工程闭环称为“Karpathy 循环”;Sakana的全自动科研系统“AI科学家”,则在2026年3月登上了《自然》杂志。
在中国,DeepSeek创始人梁文锋把通往AGI的路径拆成四级阶梯:思维链、智能体、持续学习,最后一级才是模型自主研发下一代模型,也就是RSI。阿里吴泳铭近期判断,未来机器思考的总量将达到人类的千倍以上。
值得注意的是,它们大多是“在人类划定的赛道里、由人类担任最终裁判”的有界自改进。真正的“点火”是改进能力的增长曲线脱离人力瓶颈、自我抬升斜率。
为什么华尔街需要一个新的“缩放故事”
讲清了技术的真实水位,才能看懂它在资本市场上的真正分量。
过去三年,AI行业的核心叙事是Scaling Law(缩放定律):堆参数、堆数据、堆算力,能力就近似线性提升,“大力出奇迹”。靠着这个故事,巨头买下天量GPU、融到天量资金。
但当单纯堆参数的边际收益开始递减,市场迫切需要一个回答:为什么千亿级的资本开支还要继续?
RSI恰好补上了这块逻辑。一旦自迭代闭环成立,AI的进化速度将不再受限于人类研究员的产出节奏,而直接由算力约束。换句话说,实验永不停歇、迭代永不停止,算力就从“一次性、脉冲式”的资本开支,变成像电力一样“持续滚动式”的消耗。
谷歌DeepMind首席战略官贾西特・塞孔直言,RSI是缩放定律之后的下一代增长曲线,是千亿级AI资本开支的核心投资逻辑之一。
金钱和人才正在用脚投票。2026年8月,在谷歌任职27年、被视为Dario Amodei和Ilya Sutskever等人“祖师爷”的传奇工程师杰夫・迪恩离职创业,直指RSI赛道。
消息当天Alphabet股价下跌超4%,市值单日蒸发约1800亿美元。全球首家以RSI命名的公司Recursive Superintelligence,在2026年5月一成立便拿到6.5亿美元融资、估值46.5亿美元,并由谷歌GV、英伟达、AMD领投。
此外,OpenAI专设RSI团队,Ilya的SSI则押注“安全优先的自进化”。
对产业链而言,这意味着三件事:算力需求的长期化与刚性化、研发环节本身的自动化,这也或将让药物、材料、核聚变等硬科学领域被重新定价。
(小标题)进化最快者,也可能最先失控
对于RSI,前沿实验室给出的时间表惊人地集中——DeepMind核心研究员Vinyals判断完整可落地的RSI大概率在2027—2028年,Anthropic联合创始人Jack Clark给出“2028年底前超过60%概率实现AI无需人类参与、自主研发下一代AI”。
但越是加速,越要看见三道坎。
其一是“谁来当裁判”。早在1981年,专家系统EURISKO就曾学会“钻评分规则的空子”而非真正变强(奖励黑客),一旦AI改写出人类读不懂的核心逻辑,错误会在错误上累积。
其二是“能否跃迁”。优化任务是一阶执行能力,优化“优化方法本身”是二阶元认知,难度指数级上升。
其三是安全。竞速之下的对齐缺位、上百轮迭代后的目标漂移、黑箱进化的不可预测,都是真实风险。Sakana与MIT合作的“数字红皇后”系统,名字取自《爱丽丝镜中奇遇记》里“必须拼命奔跑才能留在原地”的红皇后,这本身就是对一场停不下来的军备竞赛的隐喻。
回到达尔文的进化论。碳基进化用了数十亿年试错,靠的是死亡与遗传。而硅基进化的试错单位是代码与算力,一轮迭代短则数小时。当“适应变化的速度”本身成为竞争的唯一壁垒,未来真正活下来的,大概率不是今天参数最大、估值最高的那个模型,而是最先完成自我进化闭环、同时又没有在狂奔中丢掉方向感的那一个。
这一次,“红皇后”的赛跑,没有旁观者。